Константы модуля string
Конкатенация ascii_lowercase и ascii_uppercase константы описаны ниже. Это значение не зависит от локали.
string.ascii_lowercase :
Строчные буквы 'abcdefghijklmnopqrstuvwxyz' . Это значение не зависит от локали и не изменится.
string.ascii_uppercase :
Прописные буквы 'ABCDEFGHIJKLMNOPQRSTUVWXYZ' . Это значение не зависит от локали и не изменится.
string.digits :
string.hexdigits :
string.octdigits :
string.punctuation :
Строка ASCII символов , которые считаются знаки препинания в локали языка C : !"#$%&'()*+,-./:;<=>?@[\]^_
string.printable :
Строка символов ASCII, которые считаются печатными. Это сочетание digits , ascii_letters , punctuation , и whitespace .
string.whitespace :
Строка, содержащая все символы ASCII, которые считаются пробелами. Сюда входят пространство символов, табуляция, перевод строки, возврат, подача формы и вертикальная табуляция.
Saved searches
Use saved searches to filter your results more quickly
You signed in with another tab or window. Reload to refresh your session. You signed out in another tab or window. Reload to refresh your session. You switched accounts on another tab or window. Reload to refresh your session.
Python object to handle digits (integers from 0 to 9)
License
davidjsanders/python_digits
Name already in use
- Local
- Codespaces
Use Git or checkout with SVN using the web URL.
Work fast with our official CLI. Learn more about the CLI.
Sign In Required
Please sign in to use Codespaces.
Launching GitHub Desktop
If nothing happens, download GitHub Desktop and try again.
Launching GitHub Desktop
If nothing happens, download GitHub Desktop and try again.
Launching Xcode
If nothing happens, download Xcode and try again.
Launching Visual Studio Code
Your codespace will open once ready.
There was a problem preparing your codespace, please try again.
Latest commit
Git stats
Files
Failed to load latest commit information.
README.md
Version 2.0 This is part 1 of a multi-part tutorial. The link for the tutorial will be provided soon. This is an open source project and you are welcome to reuse and/or fork it.
Related Projects
-
: The game which uses python_digits as its base. : A Flask based server which serves up a web server offering the game to callers (human or machine) : A console based game which interacts with the server : A single page webapp which interacts with the web server using XHR (XMLHttpRequest).
The objective behind this project is to provide a Python function which provides an object to represent a digit (an integer between 0 (zero) and 9 (nine)) or a hex digit (an integer between 0 (zero) and F (fifteen)). This is further extended by providing an object (a DigitWord) which represents a collection of Digits, in a set sequence, for example:
- 0421 would be a decimal DigitWord with a length of 4 and containing 4 digits of the values: 0, 4, 2, and 1.
- ff3c would be a hex DigitWord with a length of 4 and containing 4 digits of the values: f, f, 3, and c.
The reason I created this package is for a cowbull game I have been developing which allows a series of digits to be randomly generated and then for a user to guess each digit. If the guessed digit is in the right place, then it’s a bull; if the guessed digit is in the wrong place, then it’s a cow.
To aid this, the DigitWord allows comparisons of multiple DigitWords and returns a list of DigitWordAnalysis (DWA) objects. The DWA objects state the index (the position of the guessed digit), the digit (the guess, not the actual digit), a match (True or False) indicator, an in word (True or False) indicator, and a multiple (True or False) indicator which shows whether the guessed number actually occurred more than once.
After forking this repository (or cloning using https), the package can be installed typing
and will then be available to your Python environment. Virtualenv is recommended to avoid polluting your Python environment. The Python package is also available at https://pypi.python.org/pypi?name=python-digits&:action=display and can be installed using pip:
pip install python_digits
When installing the package from source, tests are held in a directory called (unsurprisingly) tests. To validate the package, run the tests as follows from the installation directory:
python -m unittest python_digits.tests
Add new tests into new files in the tests directory and update init.py to import them, then tests can be run using the command above. Hint Use -v python_digits.tests to see the test results in verbose mode.
To use the package, do the following steps:
Try the following code to see what the objects contain:
Equality can also be compared. Try the following:
Empty DigitWords can be set to contain a random word:
An end-to-end example is provided below:
Digit — a subclass of int designed to store a single digit between 0 and 9. A Digit is formed by instantiation and passing integers (or string representation) using the parameter value. The value must be between 0 and 9 (e.g. 0, 1, 2, 3, 4, 5, 6, 7, 8, or 9) and will raise a ValueError if not. As a subclass of int, the Digit class obeys all integer operations such as multiply, add, etc.
- Instantiation: obj = Digit(value:int)
- Methods: None
- Properties: None
HexDigit — a subclass of int designed to store a single digit between 0 and F. A HexDigit is formed by instantiation and passing integers (or string representation) using the parameter value. The value must be between 0 and F (e.g. 0, 1, 2, 3, 4, 5, 6, 7, 8, 9, A, B, C, D, E, or F) and will raise a ValueError if not. As a subclass of int, the Digit class obeys all integer operations such as multiply, add, etc.
- Instantiation: obj = Digit(value:int)
- Methods: None
- Properties: None
A DigitWord is a collection of Digit objects (see Digit). The collection can be any size (up to the maximum size of a list.) The DigitWord holds each Digit in a list (see word) and DigitWord(s) may be checked for equality and compared to another DigitWord providing analysis of the matches (true or false), inclusion in the list (true or false, i.e. the number is the DigitWord but not in the same position), and if the Digit occurrs more than once (true or false)
- Instantiation: obj = DigitWord(*args, wordtype=DIGIT|HEXDIGIT) (a variable, or null, list of integers (or castable types) representing Digits.
- wordtype should be set to either DigitWord.DIGIT for decimal or DigitWord.HEXDIGIT for hex.
- If wordtype is not present, then the default is DigitWord.DIGIT
- DigitWords of different wordtypes are not equal, even if the content is equal.
- DigitWord(1, 2, 3) != DigitWord(1, 2, 3, wordtype=DigitWord.HEXDIGIT)
- __str__ : Provide a string representation of the DigitWord
- __eq__ : Provide equality checking
- __iter__ : Provide iteration of the DigitWord
- __len__ : Provide length (i.e. number of Digits) of the DigitWord
- dump() : return a JSON string representing the list
- load(value:str) : load a JSON string as the value of the DigitWord
- random(length:int=4) : Randomize the contents of the DigitWord
- compare(other:DigitWord) : Compare (analyse) the Digits of another DigitWord against self
- word:list . Returns the Digits in the DigitWord as a list of int
A DigitWordAnalysis represents the analysis of a digit compared to the digits within a DigitWord. The analysis states the index of the digit (0, 1, 2, etc.), the value of the digit (an integer between 0 and 9), whether it matched the exact position in the DigitWord (True or False), whether it occurred multiple times (True or False), and whether the digit was in the DigitWord or not (True or False).
Методы строк в Python
Возвращает копию строки, в которой первая буква переведена в верхний регистр (заглавная), а остальные — в нижний (строчные).
Совет: если хотите сделать заглавными первые буквы всех слов в строке, используйте title() .
Этот метод помещает указанную строку в центр другой строки, ширина которой (в символах) определяется параметром width .
Все пространство, не заполненное центральной строкой, заполняется символами, заданными в параметре fillchar (по умолчанию используется пробел ASCII).
Если указанная ширина строки меньше, чем ширина исходной строки ( len(s) ), или равна ей, возвращается исходная строка.
Метод возвращает число вхождений указанной подстроки sub в строку в заданном промежутке ( [start, end] ).
Аргументы для определения начала и конца промежутка опциональны и интерпретируются как обозначение среза.
При подсчете учитываются непересекающиеся вхождения. Это означает, что Python не будет заново прибавлять символы, которые уже были посчитаны.
Например, если у вас есть строка хххх и вы хотите подсчитать, сколько в ней вхождений подстроки ххх, то в результате получите 1.
Возвращает декодированную версию строки в качестве байтового объекта. Кодировка по умолчанию — utf-8.
При помощи параметра errors можно задавать разные наборы схем обработки ошибок. Возможны следующие варианты:
strict (ошибки декодирования вызывают UnicodeError )
любое другое слово, зарегистрированное через codecs.register_error()
Возвращает True , если строка заканчивается на указанный суффикс; в противном случае возвращает False .
Суффикс также может быть кортежем суффиксов.
Если указывается аргумент start , проверка начинается с указанной позиции.
При указании аргумента end проверка останавливается на указанном символе. Оба аргумента опциональны.
Возвращает первый индекс в строке, на котором была найдена указанная подстрока.
Можно указать диапазон поиска при помощи опциональных аргументов start и end (они интерпретируются как срез).
Если подстрока в строке не найдена, возвращается -1 .
Примечание: метод find() стоит использовать, только если вам нужно знать позицию, с которой начинается подстрока. Если позиция вам не нужна и вы хотите просто проверить, встречается ли в строке эта подстрока, используйте оператор in .
При помощи этого метода можно отформатировать строку.
Строка, относительно которой вызывается этот метод, может содержать простой текст или места для подстановки, обозначенные фигурными скобками.
Каждое место для подстановки содержит или числовой индекс позиционного аргумента, или имя именованного аргумента.
Метод возвращает строку, в которой каждое поле подстановки заменено строковым значением соответствующего аргумента.
Tea and Coffee
Coffee and Tea
Peas and Beans
1, 2, 3
Lunch: Pizza, WineLunch: Pizza, Wine
Lunch: Pizza, Drink
Lunch: Food, Wine0
3
3
4
ValueError: substring not foundЭтот метод возвращает True , если в строке есть хотя бы один символ, а все символы являются цифрами или буквами. В противном случае возвращается False .
Значение переменной c считается буквенно-цифровым, если хотя бы одно из выражений возвращает True :
Возвращает True , если все символы в строке — буквенные (и при этом в строке есть хоть один символ). В противном случае возвращает False .
Примечание. Имейте в виду, что под «буквенными» символами понимаются символы, определенные в базе данных Unicode как «буква», т. е., относящиеся к любой из категорий «Lm», «Lt», «Lu», «Ll» и «Lo».
Возвращает True , если все символы в строке являются десятичными символами (и если в строке есть хотя бы один символ). В противном случае возвращает False .
К десятичным символам относятся символы, с помощью которых можно формировать числа в десятичной системе счисления. В Unicode эти символы относятся к общей категории «Nd».
Возвращает True , если все символы в строке являются цифрами (и если в строке есть хотя бы один символ). Иначе возвращает False .
Метод isdigit() часто используется, например, при работе с надстрочными символами Unicode (обозначающими степень числа).
Цифра это символ, имеющий значение свойства Numeric_Type=Digit или Numeric_Type=Decimal .Разницу между методами isdigit() и isdecimal() можно увидеть, если посмотреть, как они работают со вторым примером (u»\u00B2″).
Возвращает True , если строка является допустимым идентификатором, определенным в разделе «Идентификаторы и ключевые слова» документации Python.
Совет: для проверки зарезервированных идентификаторов, таких как def , for и class , используйте keyword.iskeyword() .
Возвращает True , если все символы строки являются строчными (т. е., стоят в нижнем регистре), а в строке есть как минимум один символ. В противном случае возвращает False .
Речь идет о символах, которые в принципе могут быть как в нижнем, так и в верхнем регистре, т. е., относящихся к одной из общих категорий «Lu», «Ll» или «Lt».
Чтобы перевести строку в нижний регистр, можно использовать метод casefold() (это показано в последнем примере).
Возвращает True , если все символы в строке являются числовыми, и в строке есть хотя бы один символ. Иначе возвращает False .
К числовым символам относятся все цифры, а также все символы, имеющие в Unicode значение свойства Numeric_Type=Digit , Numeric_Type=Decimal или Numeric_Type=Numeric .
Возвращает True , если все символы в строке являются печатаемыми (и при этом в строке есть хотя бы один символ). Иначе возвращает False .
К непечатаемым символам относятся символы, определенные в базе данных Unicode как «Other» или «Separator», за исключением пробела ASCII (0x20), который считается печатаемым.
В этом контексте к печатаемым символам относятся те, которые не должны экранироваться при вызове метода repr() для этой строки. Это не касается обработки строк, записанных в sys.stdout или sys.stderr .
Возвращает True , если строка состоит из одних пробелов (и строка при этом не пустая). В противном случае возвращает False .
К символам пробелов относятся те, который в базе данных Unicode определены как «Other» или «Separator» и имеют двунаправленное свойство «WS», «B» или «S».
Возвращает True , если строка написана в title case (т. е., каждое слово написано с заглавной буквы, а все остальные буквы в словах строчные; это один из возможных вариантов набор заголовков, отсюда название).
Чтобы метод вернул True , строка также не должна быть пустой. В противном случае возвращается False .
Этот метод возвращает True , если все символы в строке стоят в верхнем регистре (т. е., заглавные), при этом строка содержит хотя бы один символ. В противном случе возвращается False .
Речь идет о символах, которые в принципе могут быть как в нижнем, так и в верхнем регистре, т. е., относящихся к одной из общих категорий «Lu», «Ll» или «Lt».
Возвращает строку, которая является конкатенацией строк в итерируемом объекте.
Если в итерируемом объекте будут любые нестроковые значения, включая байтовые объекты, вы получите TypeError .
Разделителем между элементами служит заданная строка.
Возвращает строку, выровненную по левому краю в рамках большей строки (ее ширина в символах задается при помощи параметра width ).
Для заполнения места, не занятого оригинальной строкой, используются ASCII пробелы, но можно и указать желаемый символ — при помощи параметра fillchar .
Если заданная ширина строки меньше или равна длине оригинальной строки (определяется при помощи len(s) ), то возвращается оригинальная строка.
Здесь все по аналогии с методом center() , только там строка выравнивается по центру.
Возвращает копию строки, в которой все символы переведены в нижний регистр.
Разумеется, речь идет о символах, которые в принципе могут быть как в верхнем, так и в нижнем регистре.
В плане замены символов этот метод менее агрессивен, чем casefold() . Для иллюстрации различия часто приводится пример с немецкой буквой ß , которая эквивалентна ss . Поскольку эта буква уже стоит в нижнем регистре, метод lower() ее просто пропустит, а вот метод casefold() преобразует в ss .
Возвращает копию строки с удаленными первыми символами (т.е., символами, стоящими слева).
В аргументе chars задается набор символов, которые нужно удалить. Если не задавать этот аргумент или установить его в None , по умолчанию будут удалены все пробелы слева.
Обратите внимание, что в качестве аргумента задается не префикс, а именно набор символов, т. е., их порядок не имеет значения. Метод будет удалять все символы из набора, двигаясь слева направо, пока не достигнет первого символа, не входящего в набор.
Это статический метод, возвращающий таблицу преобразования символов, которую затем можно применить для метода translate() .
Если передается только один аргумент, он должен быть словарем, в котором целые числа или символы (строки с длиной, равной 1) Unicode отражены на целые числа Unicode или строки (любой длины) или установлены на None . В таком случае ключи символов будут преобразованы в числа.
Если передается два аргумента, это должны быть строки одинаковой длины. В результате получится словарь, в котором каждый символ строки x будет отражен на символ в строке y , стоящий на такой же позиции.
Если задается третий аргумент, это должна быть строка, символы которой в результате будут отражены в None .
Разделяет строку в месте первого вхождения заданного разделителя ( sep ) и возвращает кортеж из трех элементов: части строки до разделителя, самого разделителя и части строки после него.
Если заданный разделитель не найден, метод опять же возвращает кортеж из трех элементов, где первым элементом будет вся неразделенная строка, за которой будут идти две пустые строки.
Coffee bag. Coffee cup. Coffee leaves.
Coffee bag. Coffee cup. Tea leaves.Возвращает самый большой индекс в строке, на котором была найдена указанная подстрока.
При помощи опциональных аргументов start и end можно задать диапазон для поиска подстроки в строке (эти аргументы интерпретируются как срез). Если подстрока в строке не найдена, возвращается -1 .
Работа этого метода аналогична работе метода find() , только find() ищет индекс первого вхождения подстроки.
Этот метод похож на приведенный выше метод rfind() , но если он не находит заданную подстроку sub , то выдает ValueError , а не -1.
В общем, как rfind() можно считать зеркальным отражением find() , так и rindex() , по сути, отражение index() .
0
8
10
9
ValueError: substring not found
ValueError: substring not found
ValueError: substring not foundВозвращает строку, выровненную по правому краю в рамках большей строки (ее ширина в символах задается при помощи параметра width ).
Для заполнения места, не занятого оригинальной строкой, используются символы, заданные при помощи параметра fillchar .
Если символ-заполнитель не задан, по умолчанию будут использоваться ASCII пробелы.
В случае, если заданная ширина строки меньше или равна длине оригинальной строки (определяется при помощи len(s) ), возвращается оригинальная строка.
Здесь все по аналогии с методом center() , где строка выравнивается по центру, и с методом ljust() , где строка выравнивается по левому краю.
Разделяет строку в месте последнего вхождения заданного разделителя ( sep ) и возвращает кортеж из трех элементов: части строки до разделителя, самого разделителя и части строки после него.
Если заданный разделитель не найден, метод опять же возвращает кортеж из трех элементов, где двумя первыми элементами будут пустые строки, а последним — неразделенная исходная строка.
Работа этого метода как бы зеркально отражает работу метода partition() .
Возвращает список слов в строке, используя sep в качестве разделителя.
Если задан параметр maxsplit , будет отделено указанное число слов, причем с правого края строки.
Разделитель можно не задавать или указать None — в таком случае разделителем будет считаться любой пробел (или подстрока из пробелов).
Работа rsplit() — зеркальное отражение работы метода split() , о котором еще будет идти речь ниже.
Возвращает копию строки с удаленными последними символами (т.е., символами, стоящими справа).
В аргументе chars задается набор символов, которые нужно удалить. Если не задавать этот аргумент или установить его в None , по умолчанию будут удалены все пробелы справа.
Обратите внимание, что в качестве аргумента задается не суффикс, а именно набор символов, т. е., их порядок не имеет значения. Метод будет удалять все символы из набора, двигаясь справа налево, пока не достигнет первого символа, не входящего в набор.
Работа этого метода — зеркальное отражение работы lstrip() .
Этот метод разбивает заданную строку на отдельные слова и возвращает список этих слов.
Строка-разделитель задается при помощи параметра sep.
Если разделитель указан, то последовательно расположенные разделители не группируются вместе. В этом случае считается, что они разделяют пустые строки. Например, ‘1,,2’.split(‘,’) вернет [‘1’, », ‘2’] .
Заданный разделитель может состоять из нескольких символов. Например, ‘1<>2<>3’.split(‘<>’) вернет [‘1’, ‘2’, ‘3’] .
Если метод split() применить к пустой строке и при этом указать разделитель, метод вернет [»] .
Если разделитель не задан или задан None , применяется особый алгоритм разбиения. Последовательно расположенные пробелы трактуются как один разделитель. Вследствие этого, если строка начинается с ряда пробелов или заканчивается ими, в итоговый список не попадут пустые строки.
Если исходная строка состоит исключительно из пробелов или пуста, а в качестве разделителя будет указан None , то метод вернет [] .
Если у вас есть многострочная строка, где строчки разделены, например, символами переноса строки, этот метод может вернуть список строчек, из которых состоит ваша строка.
Сами символы, отделяющие строчки, не будут входить в итоговый список, если не указать keepends=True .
Этот метод делит строку по следующим экранированным последовательностям:
\n — перевод строки;
\r — возврат каретки;
\r\n — возврат каретки + перевод строки;
\v или \x0b — вертикальная табуляция;
\f или \x0c — разрыв страницы;
\x1c — разделитель файлов;
\x1d — разделитель групп;
\x1e — разделитель записей;
\x85 — следующая строка;
\u2028 — разделитель строк;
\u2029 — разделитель абзацев.
Возвращает True , если строка начинается с указанного префикса; в противном случае возвращает False .
Префикс также может быть кортежем префиксов.
Если указывается аргумент start , проверка начинается с указанной позиции. При указании аргумента end проверка останавливается на указанном символе. Оба аргумента опциональны.
Этот метод — зеркальное отражение метода endswith() , о котором мы уже говорили.
Возвращает копию строки, в начале и конце которой удалены заданные символы. Этот набор символов, подлежащих удалению, задается в аргументе chars . Если не задавать этот аргумент или установить его в None , по умолчанию будут удалены все пробелы слева и справа.
Обратите внимание, что в качестве аргумента задается не префикс или суффикс, а именно набор символов, т. е., их порядок не имеет значения. Метод будет удалять все символы из набора, двигаясь и слева направо, и справа налево, пока с каждой стороны не достигнет первого символа, не входящего в набор.
Работа этого метода — своего рода комбинация работы методов lstrip() и rstrip() .
Возвращает копию строки, в которой все символы, стоящие в верхнем регистре, переведены в нижний, и наоборот.
Обратите внимание, что повторное применение метода swapcase() не всегда вернет строку в первоначальном виде.
Есть такие комбинации, когда двум разным символам в нижнем регистре соответствует один символ в верхнем, так что «переключение» регистра может дать неожиданный эффект. Примеры можно посмотреть в обсуждении на Stack Overflow.
Возвращает копию строки в формате заголовка (когда каждое слово в строке начинается с заглавной буквы, а все остальные — строчные).
Совет: если хотите сделать заглавной только первую букву строки, используйте метод capitalize() .
Tea And Coffee
Tea And CoffeeВозвращает переведенную копию строки, в которой каждый символ преобразован по правилам, прописанным в таблице перевода.
Для создания таблицы перевода можно воспользоваться вспомогательной функцией maketrans() .
Возвращает копию строки, которая приведена к указанной длине (задается при помощи параметра width ).
Если исходная строка короче указанной длины, «пустота» заполняется нулями ASCII слева.
Знаки +/- указываются в исходной строке и учитываются при подсчете ее длины.
Если длина исходной строки больше или равна width , будет возвращена просто исходная строка.
Строки в python 3: методы, функции, форматирование
В уроке по присвоению типа переменной в Python вы могли узнать, как определять строки: объекты, состоящие из последовательности символьных данных. Обработка строк неотъемлемая частью программирования на python. Крайне редко приложение, не использует строковые типы данных.
Из этого урока вы узнаете: Python предоставляет большую коллекцию операторов, функций и методов для работы со строками. Когда вы закончите изучение этой документации, узнаете, как получить доступ и извлечь часть строки, а также познакомитесь с методами, которые доступны для манипулирования и изменения строковых данных.
Ниже рассмотрим операторы, методы и функции, доступные для работы с текстом.
Строковые операторы
Вы уже видели операторы + и * в применении их к числовым значениям в уроке по операторам в Python . Эти два оператора применяются и к строкам.
Оператор сложения строк +
+ — оператор конкатенации строк. Он возвращает строку, состоящую из других строк, как показано здесь:
Оператор умножения строк *
* — оператор создает несколько копий строки. Если s это строка, а n целое число, любое из следующих выражений возвращает строку, состоящую из n объединенных копий s :
Вот примеры умножения строк:
Значение множителя n должно быть целым положительным числом. Оно может быть нулем или отрицательным, но этом случае результатом будет пустая строка:
Если вы создадите строковую переменную и превратите ее в пустую строку, с помощью ‘py’ * -6 , кто-нибудь будет справедливо считать вас немного глупым. Но это сработает.
Оператор принадлежности подстроки in
Python также предоставляет оператор принадлежности, который можно использоваться для манипуляций со строками. Оператор in возвращает True , если подстрока входит в строку, и False , если нет:
Есть также оператор not in , у которого обратная логика:
Встроенные функции строк в python
Python предоставляет множество функций, которые встроены в интерпретатор. Вот несколько, которые работают со строками:
Функция Описание chr() Преобразует целое число в символ ord() Преобразует символ в целое число len() Возвращает длину строки str() Изменяет тип объекта на string Более подробно о них ниже.
Функция ord(c) возвращает числовое значение для заданного символа.
На базовом уровне компьютеры хранят всю информацию в виде цифр. Для представления символьных данных используется схема перевода, которая содержит каждый символ с его репрезентативным номером.
Самая простая схема в повседневном использовании называется ASCII . Она охватывает латинские символы, с которыми мы чаще работает. Для этих символов ord(c) возвращает значение ASCII для символа c :
ASCII прекрасен, но есть много других языков в мире, которые часто встречаются. Полный набор символов, которые потенциально могут быть представлены в коде, намного больше обычных латинских букв, цифр и символом.
Unicode — это современный стандарт, который пытается предоставить числовой код для всех возможных символов, на всех возможных языках, на каждой возможной платформе. Python 3 поддерживает Unicode, в том числе позволяет использовать символы Unicode в строках.
Функция ord() также возвращает числовые значения для символов Юникода:
Функция chr(n) возвращает символьное значение для данного целого числа.
chr() действует обратно ord() . Если задано числовое значение n , chr(n) возвращает строку, представляющую символ n :
chr() также обрабатывает символы Юникода:
Функция len(s) возвращает длину строки.
len(s) возвращает количество символов в строке s :
Функция str(obj) возвращает строковое представление объекта.
Практически любой объект в Python может быть представлен как строка. str(obj) возвращает строковое представление объекта obj :
Индексация строк
Часто в языках программирования, отдельные элементы в упорядоченном наборе данных могут быть доступны с помощью числового индекса или ключа. Этот процесс называется индексация.
В Python строки являются упорядоченными последовательностями символьных данных и могут быть проиндексированы. Доступ к отдельным символам в строке можно получить, указав имя строки, за которым следует число в квадратных скобках [] .
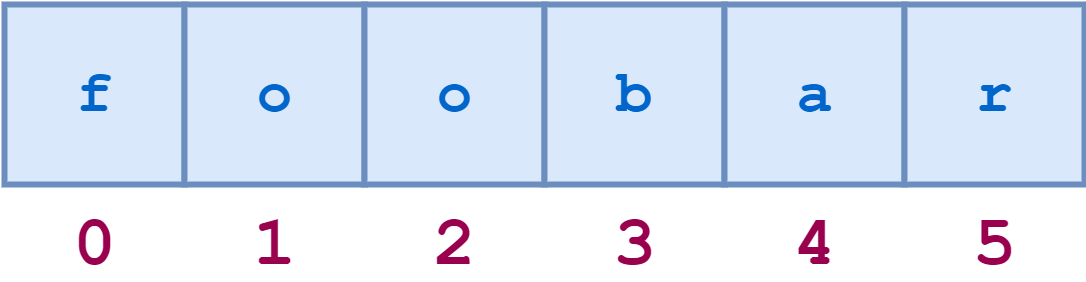
Индексация строк начинается с нуля: у первого символа индекс 0 , следующего 1 и так далее. Индекс последнего символа в python — ‘‘длина строки минус один’’.
Например, схематическое представление индексов строки ‘foobar’ выглядит следующим образом:
Отдельные символы доступны по индексу следующим образом:
Попытка обращения по индексу большему чем len(s) — 1 , приводит к ошибке IndexError :
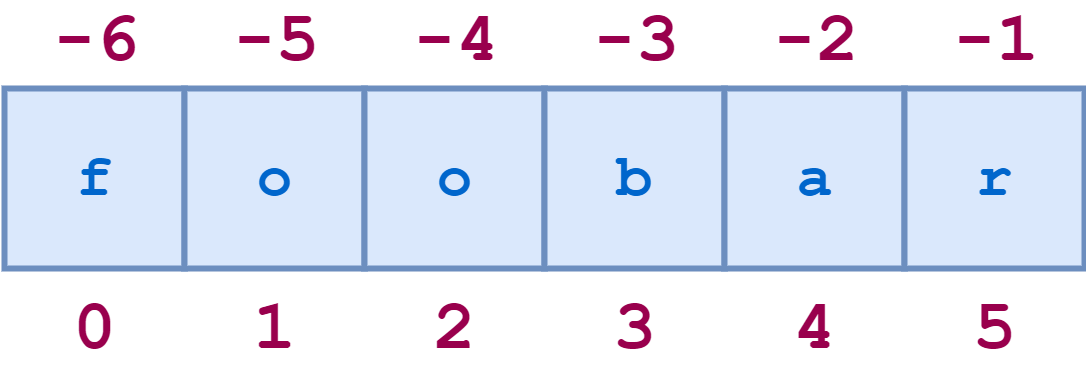
Индексы строк также могут быть указаны отрицательными числами. В этом случае индексирование начинается с конца строки: -1 относится к последнему символу, -2 к предпоследнему и так далее. Вот такая же диаграмма, показывающая как положительные, так и отрицательные индексы строки ‘foobar’ :
Вот несколько примеров отрицательного индексирования:
Попытка обращения по индексу меньшему чем -len(s) , приводит к ошибке IndexError :
Для любой непустой строки s , код s[len(s)-1] и s[-1] возвращают последний символ. Нет индекса, который применим к пустой строке.
Срезы строк
Python также допускает возможность извлечения подстроки из строки, известную как ‘‘string slice’’. Если s это строка, выражение формы s[m:n] возвращает часть s , начинающуюся с позиции m , и до позиции n , но не включая позицию:
Помните: индексы строк в python начинаются с нуля. Первый символ в строке имеет индекс 0 . Это относится и к срезу.
Опять же, второй индекс указывает символ, который не включен в результат. Символ ‘n’ в приведенном выше примере. Это может показаться немного не интуитивным, но дает результат: выражение s[m:n] вернет подстроку, которая является разницей n — m , в данном случае 5 — 2 = 3 .
Если пропустить первый индекс, срез начинается с начала строки. Таким образом, s[:m] = s[0:m] :
Аналогично, если опустить второй индекс s[n:] , срез длится от первого индекса до конца строки. Это хорошая, лаконичная альтернатива более громоздкой s[n:len(s)] :
Для любой строки s и любого целого n числа ( 0 ≤ n ≤ len(s) ), s[:n] + s[n:] будет s :
Пропуск обоих индексов возвращает исходную строку. Это не копия, это ссылка на исходную строку:
Если первый индекс в срезе больше или равен второму индексу, Python возвращает пустую строку. Это еще один не очевидный способ сгенерировать пустую строку, если вы его искали:
Отрицательные индексы можно использовать и со срезами. Вот пример кода Python:
Шаг для среза строки
Существует еще один вариант синтаксиса среза, о котором стоит упомянуть. Добавление дополнительного : и третьего индекса означает шаг, который указывает, сколько символов следует пропустить после извлечения каждого символа в срезе.
Например , для строки ‘python’ срез 0:6:2 начинается с первого символа и заканчивается последним символом (всей строкой), каждый второй символ пропускается. Это показано на следующей схеме:
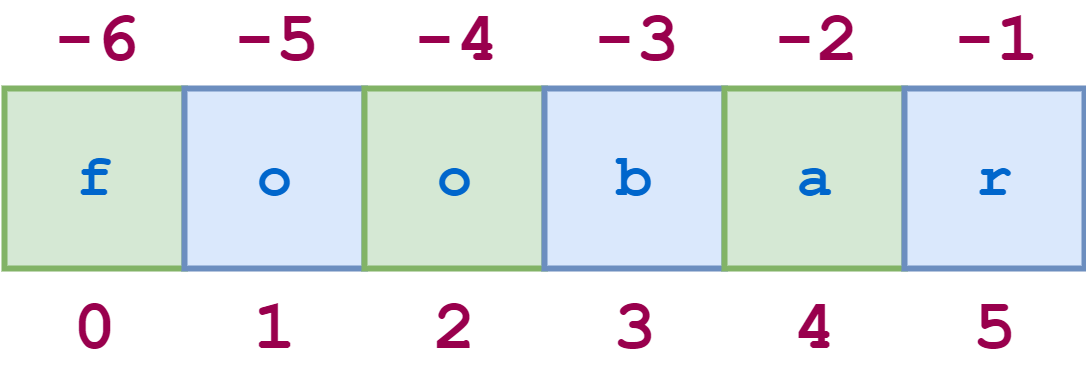
Иллюстративный код показан здесь:
Как и в случае с простым срезом, первый и второй индексы могут быть пропущены:
Вы также можете указать отрицательное значение шага, в этом случае Python идет с конца строки. Начальный/первый индекс должен быть больше конечного/второго индекса:
В приведенном выше примере, 5:0:-2 означает «начать с последнего символа и делать два шага назад, но не включая первый символ.”
Когда вы идете назад, если первый и второй индексы пропущены, значения по умолчанию применяются так: первый индекс — конец строки, а второй индекс — начало. Вот пример:
Это общая парадигма для разворота (reverse) строки:
Форматирование строки
В Python версии 3.6 был представлен новый способ форматирования строк. Эта функция официально названа литералом отформатированной строки, но обычно упоминается как f-string.
Возможности форматирования строк огромны и не будут подробно описана здесь.
Одной простой особенностью f-строк, которые вы можете начать использовать сразу, является интерполяция переменной. Вы можете указать имя переменной непосредственно в f-строковом литерале ( f’string’ ), и python заменит имя соответствующим значением.Например, предположим, что вы хотите отобразить результат арифметического вычисления. Это можно сделать с помощью простого print() и оператора , , разделяющего числовые значения и строковые:
Но это громоздко. Чтобы выполнить то же самое с помощью f-строки:
- Напишите f или F перед кавычками строки. Это укажет python, что это f-строка вместо стандартной.
- Укажите любые переменные для воспроизведения в фигурных скобках ( <> ).
Код с использованием f-string, приведенный ниже выглядит намного чище:
Любой из трех типов кавычек в python можно использовать для f-строки:
Изменение строк
Строки — один из типов данных, которые Python считает неизменяемыми, что означает невозможность их изменять. Как вы ниже увидите, python дает возможность
изменять(заменять и перезаписывать) строки.Такой синтаксис приведет к ошибке TypeError :
На самом деле нет особой необходимости изменять строки. Обычно вы можете легко сгенерировать копию исходной строки с необходимыми изменениями. Есть минимум 2 способа сделать это в python. Вот первый:
Есть встроенный метод string.replace(x, y) :
Читайте дальше о встроенных методах строк!
Встроенные методы строк в python
В руководстве по типам переменных в python вы узнали, что Python — это объектно-ориентированный язык. Каждый элемент данных в программе python является объектом.
Вы также знакомы с функциями: самостоятельными блоками кода, которые вы можете вызывать для выполнения определенных задач.
Методы похожи на функции. Метод — специализированный тип вызываемой процедуры, тесно связанный с объектом. Как и функция, метод вызывается для выполнения отдельной задачи, но он вызывается только вместе с определенным объектом и знает о нем во время выполнения.
Синтаксис для вызова метода объекта выглядит следующим образом:
Этот код вызывает метод .foo() объекта obj . <args> — аргументы, передаваемые методу (если есть).
Вы узнаете намного больше об определении и вызове методов позже в статьях про объектно-ориентированное программирование. Сейчас цель усвоить часто используемые встроенные методы, которые есть в python для работы со строками.
В приведенных методах аргументы, указанные в квадратных скобках ( [] ), являются необязательными.
Изменение регистра строки
Методы этой группы выполняют преобразование регистра строки.
string.capitalize() приводит первую букву в верхний регистр, остальные в нижний.
s.capitalize() возвращает копию s с первым символом, преобразованным в верхний регистр, и остальными символами, преобразованными в нижний регистр:
Не алфавитные символы не изменяются:
string.lower() преобразует все буквенные символы в строчные.
s.lower() возвращает копию s со всеми буквенными символами, преобразованными в нижний регистр:
string.swapcase() меняет регистр буквенных символов на противоположный.
s.swapcase() возвращает копию s с заглавными буквенными символами, преобразованными в строчные и наоборот:
string.title() преобразует первые буквы всех слов в заглавные
s.title() возвращает копию, s в которой первая буква каждого слова преобразуется в верхний регистр, а остальные буквы — в нижний регистр:
Этот метод использует довольно простой алгоритм. Он не пытается различить важные и неважные слова и не обрабатывает апострофы, имена или аббревиатуры:
string.upper() преобразует все буквенные символы в заглавные.
s.upper() возвращает копию s со всеми буквенными символами в верхнем регистре:
Найти и заменить подстроку в строке
Эти методы предоставляют различные способы поиска в целевой строке указанной подстроки.
Каждый метод в этой группе поддерживает необязательные аргументы <start> и <end> аргументы. Они задают диапазон поиска: действие метода ограничено частью целевой строки, начинающейся в позиции символа <start> и продолжающейся вплоть до позиции символа <end> , но не включая его. Если <start> указано, а <end> нет, метод применяется к части строки от <start> конца.
string.count(<sub>[, <start>[, <end>]]) подсчитывает количество вхождений подстроки в строку.
s.count(<sub>) возвращает количество точных вхождений подстроки <sub> в s :
Количество вхождений изменится, если указать <start> и <end> :
string.endswith(<suffix>[, <start>[, <end>]]) определяет, заканчивается ли строка заданной подстрокой.
s.endswith(<suffix>) возвращает, True если s заканчивается указанным <suffix> и False если нет:
Сравнение ограничено подстрокой, между <start> и <end> , если они указаны:
string.find(<sub>[, <start>[, <end>]]) ищет в строке заданную подстроку.
s.find(<sub>) возвращает первый индекс в s который соответствует началу строки <sub> :
Этот метод возвращает, -1 если указанная подстрока не найдена:
Поиск в строке ограничивается подстрокой, между <start> и <end> , если они указаны:
string.index(<sub>[, <start>[, <end>]]) ищет в строке заданную подстроку.
Этот метод идентичен .find() , за исключением того, что он вызывает исключение ValueError , если <sub> не найден:
string.rfind(<sub>[, <start>[, <end>]]) ищет в строке заданную подстроку, начиная с конца.
s.rfind(<sub>) возвращает индекс последнего вхождения подстроки <sub> в s , который соответствует началу <sub> :
Как и в .find() , если подстрока не найдена, возвращается -1 :
Поиск в строке ограничивается подстрокой, между <start> и <end> , если они указаны:
string.rindex(<sub>[, <start>[, <end>]]) ищет в строке заданную подстроку, начиная с конца.
Этот метод идентичен .rfind() , за исключением того, что он вызывает исключение ValueError , если <sub> не найден:
string.startswith(<prefix>[, <start>[, <end>]]) определяет, начинается ли строка с заданной подстроки.
s.startswith(<suffix>) возвращает, True если s начинается с указанного <suffix> и False если нет:
Сравнение ограничено подстрокой, между <start> и <end> , если они указаны:
Классификация строк
Методы в этой группе классифицируют строку на основе символов, которые она содержит.
string.isalnum() определяет, состоит ли строка из букв и цифр.
s.isalnum() возвращает True , если строка s не пустая, а все ее символы буквенно-цифровые (либо буква, либо цифра). В другом случае False :
string.isalpha() определяет, состоит ли строка только из букв.
s.isalpha() возвращает True , если строка s не пустая, а все ее символы буквенные. В другом случае False :
string.isdigit() определяет, состоит ли строка из цифр (проверка на число).
s.digit() возвращает True когда строка s не пустая и все ее символы являются цифрами, а в False если нет:
string.isidentifier() определяет, является ли строка допустимым идентификатором Python.
s.isidentifier() возвращает True , если s валидный идентификатор (название переменной, функции, класса и т.д.) python, а в False если нет:
Важно: .isidentifier() вернет True для строки, которая соответствует зарезервированному ключевому слову python, даже если его нельзя использовать:
Вы можете проверить, является ли строка ключевым словом Python, используя функцию iskeyword() , которая находится в модуле keyword . Один из возможных способов сделать это:
Если вы действительно хотите убедиться, что строку можно использовать как идентификатор python, вы должны проверить, что .isidentifier() = True и iskeyword() = False .
string.islower() определяет, являются ли буквенные символы строки строчными.
s.islower() возвращает True , если строка s не пустая, и все содержащиеся в нем буквенные символы строчные, а False если нет. Не алфавитные символы игнорируются:
string.isprintable() определяет, состоит ли строка только из печатаемых символов.
s.isprintable() возвращает, True если строка s пустая или все буквенные символы которые она содержит можно вывести на экран. Возвращает, False если s содержит хотя бы один специальный символ. Не алфавитные символы игнорируются:
Важно: Это единственный .is****() метод, который возвращает True , если s пустая строка. Все остальные возвращаются False .
string.isspace() определяет, состоит ли строка только из пробельных символов.
s.isspace() возвращает True , если s не пустая строка, и все символы являются пробельными, а False , если нет.
Наиболее часто встречающиеся пробельные символы — это пробел ‘ ‘ , табуляция ‘\t’ и новая строка ‘\n’ :
Тем не менее есть несколько символов ASCII, которые считаются пробелами. И если учитывать символы Юникода, их еще больше:
‘\f’ и ‘\r’ являются escape-последовательностями для символов ASCII; ‘\u2005’ это escape-последовательность для Unicode.
string.istitle() определяет, начинаются ли слова строки с заглавной буквы.
s.istitle() возвращает True когда s не пустая строка и первый алфавитный символ каждого слова в верхнем регистре, а все остальные буквенные символы в каждом слове строчные. Возвращает False , если нет:
string.isupper() определяет, являются ли буквенные символы строки заглавными.
s.isupper() возвращает True , если строка s не пустая, и все содержащиеся в ней буквенные символы являются заглавными, и в False , если нет. Не алфавитные символы игнорируются:
Выравнивание строк, отступы
Методы в этой группе влияют на вывод строки.
string.center(<width>[, <fill>]) выравнивает строку по центру.
s.center(<width>) возвращает строку, состоящую из s выровненной по ширине <width> . По умолчанию отступ состоит из пробела ASCII:
Если указан необязательный аргумент <fill> , он используется как символ заполнения:
Если s больше или равна <width> , строка возвращается без изменений:
string.expandtabs(tabsize=8) заменяет табуляции на пробелы
s.expandtabs() заменяет каждый символ табуляции ( ‘\t’ ) пробелами. По умолчанию табуляция заменяются на 8 пробелов:
tabsize необязательный параметр, задающий количество пробелов:
string.ljust(<width>[, <fill>]) выравнивание по левому краю строки в поле.
s.ljust(<width>) возвращает строку s , выравненную по левому краю в поле шириной <width> . По умолчанию отступ состоит из пробела ASCII:
Если указан аргумент <fill> , он используется как символ заполнения:
Если s больше или равна <width> , строка возвращается без изменений:
string.lstrip([<chars>]) обрезает пробельные символы слева
s.lstrip() возвращает копию s в которой все пробельные символы с левого края удалены:
Необязательный аргумент <chars> , определяет набор символов, которые будут удалены:
string.replace(<old>, <new>[, <count>]) заменяет вхождения подстроки в строке.
s.replace(<old>, <new>) возвращает копию s где все вхождения подстроки <old> , заменены на <new> :
Если указан необязательный аргумент <count> , выполняется количество <count> замен:
string.rjust(<width>[, <fill>]) выравнивание по правому краю строки в поле.
s.rjust(<width>) возвращает строку s , выравненную по правому краю в поле шириной <width> . По умолчанию отступ состоит из пробела ASCII:
Если указан аргумент <fill> , он используется как символ заполнения:
Если s больше или равна <width> , строка возвращается без изменений:
string.rstrip([<chars>]) обрезает пробельные символы справа
s.rstrip() возвращает копию s без пробельных символов, удаленных с правого края:
Необязательный аргумент <chars> , определяет набор символов, которые будут удалены:
string.strip([<chars>]) удаляет символы с левого и правого края строки.
s.strip() эквивалентно последовательному вызову s.lstrip() и s.rstrip() . Без аргумента <chars> метод удаляет пробелы в начале и в конце:
Как в .lstrip() и .rstrip() , необязательный аргумент <chars> определяет набор символов, которые будут удалены:
Важно: Когда возвращаемое значение метода является другой строкой, как это часто бывает, методы можно вызывать последовательно:
string.zfill(<width>) дополняет строку нулями слева.
s.zfill(<width>) возвращает копию s дополненную ‘0’ слева для достижения длины строки указанной в <width> :
Если s содержит знак перед цифрами, он остается слева строки:
Если s больше или равна <width> , строка возвращается без изменений:
.zfill() наиболее полезен для строковых представлений чисел, но python с удовольствием заполнит строку нулями, даже если в ней нет чисел:
Методы преобразование строки в список
Методы в этой группе преобразовывают строку в другой тип данных и наоборот. Эти методы возвращают или принимают итерируемые объекты — термин Python для последовательного набора объектов.
Многие из этих методов возвращают либо список, либо кортеж. Это два похожих типа данных, которые являются прототипами примеров итераций в python. Список заключен в квадратные скобки ( [] ), а кортеж заключен в простые ( () ).
Теперь давайте посмотрим на последнюю группу строковых методов.
string.join(<iterable>) объединяет список в строку.
s.join(<iterable>) возвращает строку, которая является результатом конкатенации объекта <iterable> с разделителем s .
Обратите внимание, что .join() вызывается строка-разделитель s . <iterable> должна быть последовательностью строковых объектов.
Примеры кода помогут вникнуть. В первом примере разделителем s является строка ‘, ‘ , а <iterable> список строк:
В результате получается одна строка, состоящая из списка объектов, разделенных запятыми.
В следующем примере <iterable> указывается как одно строковое значение. Когда строковое значение используется в качестве итерируемого, оно интерпретируется как список отдельных символов строки:
Таким образом, результатом ‘:’.join(‘corge’) является строка, состоящая из каждого символа в ‘corge’ , разделенного символом ‘:’ .
Этот пример завершается с ошибкой TypeError , потому что один из объектов в <iterable> не является строкой:
Это можно исправить так:
Как вы скоро увидите, многие объекты в Python можно итерировать, и .join() особенно полезен для создания из них строк.
string.partition(<sep>) делит строку на основе разделителя.
s.partition(<sep>) отделяет от s подстроку длиной от начала до первого вхождения <sep> . Возвращаемое значение представляет собой кортеж из трех частей:
- Часть s до <sep>
- Разделитель <sep>
- Часть s после <sep>
Вот пара примеров .partition() в работе:
Если <sep> не найден в s , возвращаемый кортеж содержит s и две пустые строки:
s.rpartition(<sep>) делит строку на основе разделителя, начиная с конца.
s.rpartition(<sep>) работает как s.partition(<sep>) , за исключением того, что s делится при последнем вхождении <sep> вместо первого:
string.rsplit(sep=None, maxsplit=-1) делит строку на список из подстрок.
Без аргументов s.rsplit() делит s на подстроки, разделенные любой последовательностью пробелов, и возвращает список:
Если <sep> указан, он используется в качестве разделителя:
Если <sep> = None , строка разделяется пробелами, как если бы <sep> не был указан вообще.
Когда <sep> явно указан в качестве разделителя s , последовательные повторы разделителя будут возвращены как пустые строки:
Это не работает, когда <sep> не указан. В этом случае последовательные пробельные символы объединяются в один разделитель, и результирующий список никогда не будет содержать пустых строк:
Если указан необязательный параметр <maxsplit> , выполняется максимальное количество разделений, начиная с правого края s :
Значение по умолчанию для <maxsplit> — -1 . Это значит, что все возможные разделения должны быть выполнены:
string.split(sep=None, maxsplit=-1) делит строку на список из подстрок.
s.split() ведет себя как s.rsplit() , за исключением того, что при указании <maxsplit> , деление начинается с левого края s :
Если <maxsplit> не указано, между .rsplit() и .split() в python разницы нет.
string.splitlines([<keepends>]) делит текст на список строк.
s.splitlines() делит s на строки и возвращает их в списке. Любой из следующих символов или последовательностей символов считается границей строки:
Разделитель Значение \n Новая строка \r Возврат каретки \r\n Возврат каретки + перевод строки \v или же \x0b Таблицы строк \f или же \x0c Подача формы \x1c Разделитель файлов \x1d Разделитель групп \x1e Разделитель записей \x85 Следующая строка \u2028 Новая строка (Unicode) \u2029 Новый абзац (Unicode) Вот пример использования нескольких различных разделителей строк:
Если в строке присутствуют последовательные символы границы строки, они появятся в списке результатов, как пустые строки:
Если необязательный аргумент <keepends> указан и его булевое значение True , то символы границы строк сохраняются в списке подстрок:
Заключение
В этом руководстве было подробно рассмотрено множество различных механизмов, которые Python предоставляет для работы со строками, включая операторы, встроенные функции, индексирование, срезы и встроенные методы.
Python есть другие встроенные типы данных. В этих урока вы изучите два наиболее часто используемых: