Как печатать скобки в Python?

Python имеет очень простой синтаксис. Python как язык удобен для начинающих. Программист, новичок в этой области, может бояться программирования из-за всех этих сложных синтаксисов в таких языках, как C и Java. Но Python также приносит некоторые сложности из-за его короткого и простого синтаксиса. Одной из таких проблем является печать скобок.
В этой статье мы собираемся проверить, как мы можем печатать скобки в Python.
Что означают скобки в Python?
Скобки почти во всех языках программирования являются метасимволами. Это означает, что они используются для указания чего-либо. В Python мы используем отступы вместо фигурных скобок, но фигурные скобки по-прежнему используются только не для отступов. Они используются для обозначения набора или словаря. Квадратные скобки используются для обозначения списка или используются для индексации в индексированных итерациях, таких как списки и кортежи. Круглые скобки используются для указания порядка операций и при вызове функции или создании экземпляра класса или обозначают кортеж.
Печать скобок
Скобки «()». Они используются для вызова функции или создания кортежа. print сама функция использует круглые скобки. Давайте посмотрим, как вы можете печатать скобки.
Связанный: Что такое кортежи в Python?
С использованием print() функция.
print() function — это стандартная функция, используемая для печати строк и чего угодно в Python. Он очень прост в использовании. Просто введите print(«<String you want to print>») .

Печать скобок
Первая строка блока кода печатает открывающую скобку «(». Вторая строка печатает закрывающую скобку «)» и так далее третья строка печатает парные скобки «()».
Использование конкатенации строк
Конкатенация строк — это добавление строк вместо чисел. Когда мы объединяем две строки, обе строки объединяются и образуют одну строку.
Теперь давайте посмотрим, как мы можем напечатать скобки, объединив строки.

Печать скобок Конкатенация строк
Здесь мы использовали пустую строковую переменную для вывода скобок. Мы объединили скобку с пустой строкой и напечатали ее. Здесь вместо пустой строки можно использовать любую строку.

Печать в скобках конкатенации строк с текстом в ней
Использование форматированных строк
Строка формата может быть создана с помощью format() метод. В строке формата фигурные скобки используются для представления динамического значения. Мы также можем использовать форматированные строки для печати скобок. Давайте посмотрим, как мы можем это сделать.
Выход :
Parentheses: (hello)
Мы использовали метод format() для печати круглых скобок в приведенном выше коде. Мы разместили фигурные скобки там, где хотели, и в format() функция, замененная <> на () или круглые скобки.
Печать квадратных скобок
Квадратные скобки используются для создания списков. Давайте посмотрим, как мы можем напечатать квадратные скобки в Python.
Связанный: Что такое списки в Python?
С использованием print() функция.

Печать квадратных скобок
Первая строка блока кода выводит открывающую квадратную скобку «[“. The second line prints a closing square bracket “]” и так далее в третьей строке печатается парная квадратная скобка “[]».
Использование конкатенации строк
Теперь давайте посмотрим, как мы можем напечатать квадратные скобки, объединив строки.

квадратные скобки с использованием конкатенации строк
Здесь мы использовали пустую строковую переменную для вывода скобок. Мы объединили скобку с пустой строкой и напечатали ее. Здесь вместо пустой строки можно использовать любую строку.

Печать квадратных скобок со строкой внутри
Использование форматированных строк
Мы также можем использовать форматированные строки для вывода квадратных скобок. Давайте посмотрим, как мы можем это сделать.
Выход :
Square brackets: [hello]
Мы использовали метод format() для печати квадратных скобок в приведенном выше коде. Мы разместили фигурные скобки там, где хотели, и в format() функция, замененная <> на [] или квадратные скобки.
Печать фигурных скобок
Фигурные скобки используются для создания словаря и наборов. Они также используются для получения динамических значений в форматированных строках. Давайте посмотрим, как мы можем напечатать фигурные скобки в Python.
Связанный: Что такое словарь в Python?
С использованием print() функция.

Печать фигурных скобок
Первая строка блока кода выводит открывающую фигурную скобку «<». Во второй строке выводится закрывающая фигурная скобка «>», а в третьей строке выводятся парные фигурные скобки «<>».
Использование конкатенации строк
Теперь давайте посмотрим, как мы можем напечатать фигурные скобки, объединив строки.

Печать фигурных скобок с конкатенацией строк
Здесь мы использовали пустую строковую переменную для вывода фигурных скобок. Мы объединили фигурные скобки с пустой строкой и напечатали ее. Здесь вместо пустой строки можно использовать любую строку.

Печать фигурных скобок со строкой внутри
Использование форматированных строк
Мы также можем использовать форматированные строки для вывода фигурных скобок. Давайте посмотрим, как мы можем это сделать.
Выход :
Curly Braces:
Мы использовали метод format() для печати фигурными. фигурные скобки в приведенном выше коде. Мы разместили фигурные скобки там, где хотели, и в format() функция, замененная <> на <> или фигурные скобки.
Заключение
Это было для этой статьи. Это был простой, но интересный вопрос. Хорошо продолжать задавать вопросы. Это то, что делает нас хорошими программистами. Другой важной частью программирования является практика. Практики никогда не бывает достаточно; чем больше вы практикуетесь, тем лучше у вас получается программировать.
8. Списки
Список (англ.: list) есть упорядоченный набор значений, где каждое значение доступно по индексу. Значения, входящие в список, называются элементами.
Списки похожи на строки, так как строки тоже являются упорядоченными наборами элементов — символов. Но в отличие от строк, элементы списка могут быть любых типов. Списки и строки, а также другие типы, являющиеся упорядоченными наборами, называются последовательностями.
8.2. Списочные значения
Есть несколько способов создать новый список, простейший из них — заключить элементы в квадратные скобки, [ и ] :
В первом примере у нас список из четырех целых чисел. Во втором — список из трех строк. Элементы списка не обязательно относятся к одному типу. Следующий список содержит строку, число с плавающей точкой, целое число и. еще один список:
Список внутри другого списка называют вложенным.
Наконец, список может вовсе не содержать элементов. Такой список называют пустым и обозначают [] .
В логическом выражении пустой список, так же, как 0 или пустая строка, считается ложью:
Мы можем присваивать списочные значения переменным и передавать списки в качестве аргументов при вызове функций:
8.3. Доступ к элементам
Для доступа к элементам списка используется тот же оператор [] , что и для доступа к символам строки. Выражение в квадратных скобках задает индекс. Не забывайте, что индексы начинаются с 0:
В качестве индекса можно использовать любое целочисленное выражение:
Если попытаться получить доступ к несуществующему элементу, то получим ошибку выполнения:
Если индекс отрицательный, то счет идет от конца списка:
Выражение numbers[-1] дает последний элемент списка, numbers[-2] — второй от конца, а элемента numbers[-3] не существует.
Часто в качестве индекса используется переменная цикла.
Этот цикл while считает от 0 до 4. Когда переменная цикла i становится равна 4, условие становится ложным и цикл завершается. Таким образом, тело цикла выполняется для i со значениями 0, 1, 2 и 3.
В каждой итерации переменная i используется как индекс для списка, чтобы вывести i -тый элемент. Этот прием называется обход списка.
8.4. Длина списка
Функция len возвращает длину списка, то есть, количество элементов в списке. В качестве верхней границы в цикле удобно использовать возвращаемое этой функцией значение, а не константу. При этом, если размер списка изменится, вам не придется просматривать программу и вносить изменения во все циклы, работающие с этим списком; они будут работать корректно со списком любого размера:
В последней итерации i равно len(horsemen) - 1 , то есть, индексу последнего элемента списка. Когда i становится равным len(horsemen) , условие цикла становится ложным и тело цикла не выполняется. И это правильно, поскольку len(horsemen) недопустимый для данного списка индекс.
Хотя список может содержать другой список, вложенный список считается одним элементом. Длина этого списка равна 4:
8.5. Проверка вхождения в список
Оператор in проверяет вхождение элемента в последовательность и дает в результате логическое значение. Мы уже использовали его со строками, но он также работает со списками и другими последовательностями:
Поскольку ‘pestilence’ входит в список horsemen , то оператор in возвращает True . Поскольку ‘debauchery’ не входит в список, in возвращает False .
Используя not вместе с in , можно проверить, что элемент не является элементом списка:
8.6. Операции над списками
Оператор + конкатенирует списки:
Оператор * повторяет элементы списка заданное число раз:
В первом примере 0 повторяется четыре раза. Во втором три раза повторяются элементы 1, 2, 3 .
8.7. Срезы списков
Мы выполняли срезы строк, но срезы также работают для списков:
8.8. Функция range 
В программировании часто требуются списки последовательных целых чисел, и Python предоставляет простой способ для их создания:
Функция range принимает два аргумента и возвращает список целых, начиная от числа, заданного первым аргументом, и до числа, заданного вторым аргументом, не включая последнее.
Можно вызывать range и по-другому. При вызове с единственным аргументом функция возвращает список, начинающийся с 0:
Третий аргумент, если он указан, задает шаг между соседними значениями в списке. Получим список чисел от 1 до 10 с шагом 2:
Если шаг задан отрицательным числом, то начальное число должно быть больше конечного:
Иначе результатом будет пустой список:
8.9. Списки изменяемы
В отличие от строк, списки изменяемы. Это означает, мы можем изменять их элементы. Используя оператор [] в левой части присваивания, можно избирательно обновить один из элементов:
Оператор [] может использоваться со списком в любом месте выражения. Если он появляется слева от оператора присваивания, он изменяет элемент списка. В приведенном примере первый элемент списка fruit изменяется с 'banana' на 'pear' , а последний — с 'quince' на 'orange' . Присваивание отдельному элементу не работает для строк:
Но работает для списков:
Используя срез, можно изменить несколько элементов сразу:
Можно также удалить элементы из списка, присвоив им пустой список:
А можно добавить элементы в список, втиснув их в пустой срез в нужном месте:
8.10. Удаление списка
Удаление элементов с помощью присваивания срезов довольно вычурно, и потому чревато ошибками. Python предлагает альтернативный способ, более легкий для чтения и понимания, и, к тому же, более универсальный.
del удаляет элемент из списка:
Как и следовало ожидать, del работает с отрицательными индексами, и генерирует ошибку выполнения, если заданный индекс выходит за границы разрешенного диапазона.
С del можно использовать срез:
8.11. Объекты и значения
Выполним предложения присваивания:
Теперь мы знаем, что и a и b указывают на строку "banana" . Но мы не можем сказать, указывают ли они на одну и ту же строку.
Есть два варианта:
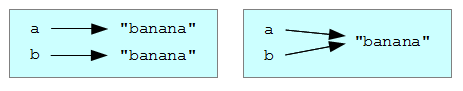
В первом случае a и b указывают на два разных объекта с одинаковыми значениями. Во втором случае они ссылаются на один и тот же объект. Объект — это что-то, с чем может быть связано имя переменной.
У каждого объекта имеется уникальный идентификатор, который можно получить с помощью функции id . Отобразив идентификаторы объектов, на которые указывают a и b , мы узнаем, связаны ли эти переменные с одним и тем же объектом:
Мы два раза получили один и тот же идентификатор, а это значит, что Python создал только одну строку, и обе переменные, a и b , связаны с ней. Вы, вероятно, получите другое значение идентификатора.
Интересно, что списки ведут себя иначе. Если создать два списка, то мы получим два объекта:
На диаграмме это выглядит так:
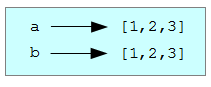
Переменные a и b ссылаются на разные объекты, имеющие одинаковые значения.
8.12. Альтернативные имена
Поскольку переменные ссылаются на объекты, то, если мы присвоим одну переменную другой, обе переменные будут ссылаться на один и тот же объект:
На диаграмме это выглядит так:
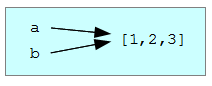
Поскольку два разных имени, a и b , связаны с одним и тем же списком, будем называть их альтернативными именами. Изменения, сделанные с использованием одного имени, оказывают влияние и на другое:
Хотя такое поведение может быть полезным, иногда оно оказывается нежелательным. Вообще говоря, лучше избегать альтернативных имен, работая с изменяемыми объектами. А вот для неизменяемых объектов альтернативные имена не представляют никаких проблем. Поэтому Python создает альтернативные имена для строк, когда представляется случай сэкономить память компьютера.
8.13. Клонирование списков
Если нужно изменить список и при этом сохранить копию оригинального списка, то понадобится сделать копию самого списка, а не ссылки на него. Этот процесс иногда называют клонированием.
Простейший способ клонировать список — воспользоваться оператором среза:
Получение любого среза списка a приводит к созданию нового списка. В данном случае срез включает весь список.
Теперь можно изменять список b , не беспокоясь об a :
8.14. Списки и циклы for 
Цикл for также работает со списками. Синтаксис такой:
Это предложение эквивалентно следующему фрагменту кода:
Цикл for более лаконичен, поскольку мы можем обойтись без переменной цикла i . Вот рассмотренный выше цикл, переписанный с помощью for .
Он читается почти по-английски: для (каждого) horseman (англ.: всадник) в (списке) horsemen (англ.: всадники) напечатать horseman.
Любое списочное выражение может быть использовано в цикле for :
В первом примере выводятся все числа, кратные 3, между 0 и 19. Во втором примере выражается энтузиазм по поводу разных видов фруктов.
Поскольку списки изменяемы, часто выполняется обход списка с изменением каждого из его элементов. Следующий пример возводит в квадрат все числа в списке от 1 до 5 :
Подумайте над выражением range(len(numbers)) и разберитесь, как оно работает. В данном случае нам нужно как значение, так и индекс элемента списка для того, чтобы мы могли присвоить ему новое значение.
Такой прием довольно распространен в программировании, поэтому Python предлагает более красивый способ реализовать его:
Здесь функция enumerate в каждой итерации возвращает очередной индекс и связанное с ним значение. Еще один пример того, как работает enumerate :
8.15. Списочные параметры
При передаче списка в качестве аргумента передается ссылка на список, а не его копия. А поскольку списки изменяемы, то изменение параметра внутри функции означает также и изменение аргумента. Например, функция ниже принимает список в качестве аргумента и умножает каждый элемент списка на 2:
Если поместить функцию double_stuff в файл ch08.py , то сможем так протестировать ее:
Параметр a_list и переменная things являются альтернативными именами одного и того же объекта.
Если функция модифицирует списочный параметр, изменения будут видны в вызывающем коде.
8.16. Чистые и модифицирующие функции
Функции, которые принимают списки как аргументы и изменяют эти списки в ходе выполнения, называются модифицирующими, а изменения, которые они делают, называются побочным эффектом.
Чистая функция не производит побочных эффектов. Все ее связи с вызывающей программой сводятся к параметрам, которых она не изменяет, и возвращаемому значению. Вот чистая функция double_stuff :
Эта версия double_stuff не изменяет своих аргументов:
При использовании чистой функции double_stuff , для изменения things вам понадобится присвоить возвращаемое значение things :
8.17. Какая функция лучше?
Все, что можно сделать с помощью модифицирующих функций, может быть сделано и при помощи чистых функций. На самом деле, некоторые языки программирования поддерживают только чистые функции. Есть мнение, что программы, использующие только чистые функции, быстрее разрабатывать и в них закрадывается меньше ошибок. И все же, иногда модифицирующие функции удобны, а в отдельных случаях программы с чистыми функциями менее эффективны.
Вообще, мы рекомендуем писать чистые функции всегда, когда это разумно, и прибегать к модифицирующим только в случаях, когда их использование дает несомненное преимущество.
8.18. Вложенные списки
Вложенный список — это список, являющийся элементом другого списка. В следующем списке элемент с индексом 3 есть вложенный список:
Если ввести nested[3] , то получим [10, 20] . Извлечь элемент из вложенного списка можно за два шага:
А можно объединить эти два шага в выражение:
Оператор квадратная скобка вычисляется слева направо, так что это выражение берет 3-й элемент списка nested и извлекает из него 1-ый элемент.
8.19. Матрицы
Вложенные списки часто используют для того, чтобы представлять матрицы. Например, матрицу
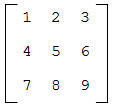
можно представить так:
matrix есть список из трех элементов, в котором каждый элемент задает строку матрицы. Можно получить целую строку матрицы, как обычно:
Также можно извлечь отдельный элемент матрицы, используя два индекса:
Первый индекс выбирает строку, а второй — столбец. Хотя этот способ представления матриц самый распространенный, он не является единственным. Его вариацией является список столбцов вместо списка строк. Позднее мы увидим более радикальную альтернативу, использующую словарь.
8.20. Разработка через тестирование
Разработка через тестирование (англ.: Test-driven development, TDD) — это практика разработки программ, в которой программа создается серией небольших итераций, в каждой из которых сначала пишутся автоматические тесты, а затем код, реализующий тестируемую функциональность. От итерации к итерации растет реализованная и оттестированная функциональность.
Продемонстрируем разработку через тестирование с помощью доктестов. Скажем, нам нужна функция, которая создает матрицу с rows строк и columns столбцов, принимая аргументы для rows и columns .
Сначала подготовим тест для этой функции в файле matrices.py :
Выполнив скрипт, видим, что тест не прошел:
Тест не проходит, поскольку тело функции не содержит ничего, кроме строки в тройных кавычках, и поэтому возвращает None . Наш тест требует, чтобы функция возвращала матрицу 3 x 5, заполненную нулями.
Правила разработки через тестирование говорят, что для начала нужно написать самый простой вариант, который бы удовлетворял тест. Так что, в этом случае, просто вернем ожидаемый результат:
Теперь при выполнении скрипта тест успешно проходит, но наша реализация make_matrix всегда возвращает один и тот же результат, а это явно не то, что имелось в виду. В качестве мотивации дальнейших улучшений добавим тест:
Как и следовало ожидать, тест не проходит:
Этот процесс называется разработкой через тестирование, потому что код пишется только тогда, когда имеется тест, который не проходит. Мотивированные последним тестом, теперь напишем более общее решение:
Это решение, похоже, работает, поскольку тесты проходят. Однако, начав пользоваться новой функцией, быстро обнаружим баг:
Мы хотели присвоить значение 7 элементу во второй строке и третьем столбце, но, вместо этого, значение 7 получили все элементы третьего столбца!
По размышлении становится ясно, что в нашем текущем решении каждая строка матрицы — всего лишь ссылка на один и тот же список. Это определенно не то, что нам нужно. Приступая к исправлению бага, сначала напишем тест, демонстрирующий наличие этого бага:
Теперь, имея тест, который демонстрирует баг в программе, мы должны найти лучшее решение:
Процесс разработки через тестирование имеет ряд преимуществ. Этот процесс:
- заставляет конкретно думать о задаче, которую нужно решить, прежде чем пытаться ее решить,
- поощряет разбивать сложные задачи на более мелкие и простые, и пошагово приближаться к решению задачи в целом,
- дает набор автоматических тестов для программы, облегчая внесение в нее изменений и дополнений в дальнейшем.
8.21. Строки и списки
В Python есть функция list , которая принимает значение некоторой последовательности как аргумент и создает список из ее элементов.
Также существует функция str , которая берет любое значение Python как аргумент и возвращает его строковое представление.
Как видно из последнего примера, с помощью str не удается соединить вместе элементы списка символов. Это можно сделать с помощью функции join из модуля string :
Две очень полезные функции модуля string имеют дело со списками строк. Функция split разбивает строку на слова, возвращая список слов. По умолчанию считается, что слова отделяются друг от друга одним или более пробельными символами:
Необязательный аргумент позволяет указать, какие символы считать разделителями слов. В следующем примере в качестве разделителя указана последовательность двух символов ai :
Заметьте, что ai не попадает в список.
Функция string.join делает обратное функции string.split . Она принимает два аргумента: список строк и разделитель, который будет разделять элементы списка в результирующей строке.
8.22. Глоссарий
8.23. Упражнения
Напишите цикл, который обходит список
и выводит длину каждого элемента. Что происходит, когда вы передаете целое число функции len ? Замените 1 на 'one' и выполните вашу программу снова.
Создайте файл ch08e02.py следующего содержания:
Добавляйте следующие наборы доктестов в докстроку в начале файла и пишите код Python, который обеспечит прохождение доктестов. Добавляйте по одному набору доктестов за один раз.
Литералы
Литералы в Python можно определить как данные, которые задаются в переменной или константе.
Python поддерживает следующие литералы:
Строковые литералы:
Строковые литералы могут быть сформированы путем заключения текста в кавычки. Для создания строки мы можем использовать как одинарные, так и двойные кавычки.
Типы строк:
В Python поддерживаются два типа строк:
Однострочные строки — строки, которые заканчиваются в пределах одной строки, называются однострочными.
Многострочная строка — часть текста, написанная в несколько строк, называется многострочной строкой.
Существует два способа создания многострочных строк:
- Добавление черной косой черты в конце каждой строки.
- Использование тройных кавычек:
Числовые литералы:
Числовые литералы неизменяемы. Числовые литералы могут принадлежать к следующим четырем различным числовым типам.
| Int(целые числа со знаком) | Long(большие числа) | float(с плавающей запятой) | Complex(комплексные) |
|---|---|---|---|
| Числа (могут быть как положительными, так и отрицательными) без дробной части. например: 100 | Целые числа неограниченного размера, за которыми следует строчная или прописная буква L, например: 87032845L | Вещественные числа с целой и дробной частью, например: -26,2 | В виде a+bj, где a — действительная часть, а b — мнимая часть комплексного числа. например: 3.14j . |
Пример — Числовые литералы
Булевы (логические) литералы:
Логический литерал может иметь любое из двух значений: True или False .
Пример — Логические литералы
Специальные литералы.
Python содержит один специальный литерал — None.
None используется для указания на поле, которое не создается. Он также используется для конца списков в Python.
*Пример — Специальные литералы *
Литералы коллекций.
Python предоставляет четыре типа коллекции литералов, такие как литералы List, литералы Tuple, литералы Dict и литералы Set.
Список: (List)
Список содержит элементы различных типов данных. Списки являются мутабельными, то есть изменяемыми. Значения, хранящиеся в списке, разделяются запятой , и заключаются в квадратные скобки [] . В списке можно хранить данные различных типов.
Пример — литералы списка
Словарь (Dictionary)
Словарь в Python хранит данные в паре ключ-значение. Он заключен в фигурные скобки <> , а каждая пара отделяется запятыми , .
Кортеж (Tuple)
Кортеж в Python — это коллекция данных разного типа. Он неизменяем, т.е. его нельзя изменить после создания. Он заключен в круглые скобки () , а каждый элемент разделен запятой , .
Множество (Set):
Множество в Python — это коллекция неупорядоченных наборов данных. Он заключен в <> , а каждый элемент отделяется запятой , .
Подробное руководство по индексам и срезам в Python
Материал дает понимание того, как связан индекс элемента и срез последовательности, объясняется работа с объектом среза и его применение на практике.
Содержание:
Введение в индексы и срезы.
В Python некоторые объекты, такие как строки или списки, можно нарезать. Например, можно получить первый элемент списка или строку с помощью индекса элемента:
Python использует квадратные скобки [ и ] для доступа к отдельным элементам объектов, которые можно разбить на части. Внутри этих квадратных скобок можно указать нечто большее, чем просто доступ к отдельным элементам.
Python поддерживает указание отрицательных индексов, их можно использовать следующим образом:
Выражение my_list[-1] представляет последний элемент списка, my_list[-2] представляет предпоследний элемент и так далее.
Что делать, если нужно извлечь более одного элемента последовательности? Например, необходимо извлечь все от начала до конца, за исключением самого последнего элемента:
Или, если нужен каждый четный элемент списка, то есть элемент 0, 2 и т. д.? Для этого нужно перейти от первого элемента к последнему, но пропустить каждый второй элемент. Например:
Объект среза slice() .
За кулисами, индекс, который используется для доступа к отдельным элементам последовательности представляет собой объект среза slice() принимающий три аргумента: slice(start, stop, step) .
Проверим это утверждение:
Примечание: буква P является первым элементом в списке ( list("Python") ), поэтому она индексируется как 0. Список имеет длину 6, и, следовательно, первый элемент также может быть проиндексирован как -6.
Если использовать начало start и конец stop объекта среза, то каждый элемент между этими числами покрывается срезом. Некоторые примеры:
Это способ запомнить, что начальное значение является инклюзивным, а конечное — исключающим.
Значения по умолчанию.
В большинстве случаев приходится делить список:
- начиная с 0 (первый элемент последовательности);
- с захватом нужного последнего элемента;
- с определенным шагом.
Следовательно, значения по умолчанию можно опустить и использовать синтаксис : :
Технически, всякий раз, когда опускается число между двоеточиями, пропущенные числа будут иметь значение None .
И, в свою очередь, объект slice() заменит None на:
- 0 для начального значения;
- len(list) для конечного значения;
- 1 для значения шага.
Но, если значение шага отрицательное, то числа заменяются на:
- -1 для начального значения;
- -len(list) — 1 для конечного значения.
Например, 'Python'[::-1] технически совпадает с 'Python'[-1:-7:-1]
Особый случай среза: копия последовательности.
Существует специальный случай для среза, который можно использовать в качестве поверхностного копирования. Если использовать только значения по умолчанию, т. е. my_list[:] , то это выражение создаст точно такие же элементы:
Элементы в списке действительно совпадают. Однако новый объект списка не является ссылкой на оригинал. Можно проверить это утверждение, используя встроенный идентификатор:
Обратите внимание, что каждая операция среза возвращает новый объект. Копия последовательности создается при использовании только [:] .
Пример, иллюстрирующий разницу:
Примеры часто используемые срезов:
- [:] — копия последовательности;
- [::2] — четные элементы последовательности начиная с первого;
- [1::2] — нечетные элементы последовательности начиная со второго;
- [1:] — все элементы, кроме первого;
- [:-1] — все элементы, кроме последнего;
- [1:-1] — все элементы, кроме первого и последнего;
- [::-1] — все элементы в обратном порядке (реверс последовательности);
- [-2:0:-1] — все элементы, кроме первого и последнего, в обратном порядке;
- [-2:0:-2] — каждый второй элемент, кроме первого и последнего, в обратном порядке;
Метод среза .indices .
Каждый объект slice() в Python имеет метод slice.indices() . Этот метод возвращает кортеж (start, end, step) , с помощью которой можно перестроить цикл, эквивалентный операции среза. Звучит сложно? Начнем разбираться с последовательности:
Затем создадим объект slice() . Например возьмем каждый второй элемент, т.е. sequence[::2] .
Так как в качестве некоторых аргументов используется None , то объект slice() должен вычислять фактические значения индекса на основе длины последовательности. Следовательно, чтобы получить кортеж индексов, необходимо передать длину последовательности методу slice.indices() , например:
Теперь можно воссоздать цикл следующим образом:
Этот цикл позволяет получить доступ к тем же элементам последовательности, что и сам срез.
Собственные классы с возможностью применения срезов.
Python не был бы Python, если бы невозможно было использовать объект среза в своих собственных классах. Более того, срезы не обязательно должны быть числовыми значениями. Например, можно создать адресную книгу, которую потом можно нарезать по алфавитным индексам.
Разбираемся в созданном классе AddressBook .
Этот метод фильтрует все адреса, принадлежащие имени, которые начинаются с любой буквы в аргументе letters . Во-первых, эта функция нечувствительна к регистру, так как преобразует буквы в верхний регистр. Затем используется генератор списка поверх внутреннего списка адресов. Условие внутри генератора списка проверяет, соответствует ли какая-либо из предоставленных букв первой букве, соответствующее значению имени.
Чтобы сделать объекты адресной книги доступными для использования среза, необходимо переопределить магический метод Python __getitem__ .
Сначала проверяется, является ли ключ строкой. Это будет иметь место, если получаем доступ к объекту с помощью одной буквы в квадратных скобках, например так: address_book['A'] . Для этого тривиального случая можно просто вернуть любые адреса, имя которых начинается с данной буквы.
Интересная часть, когда ключ является объектом среза. Например, этому условию будет соответствовать обращение типа address_book['A':'H'] . Во-первых, идентифицируются все буквы в алфавитном порядке между буквами A и H . Модуль string перечисляет все латинские буквы в string.ascii_uppercase . Далее используется срез для извлечения букв между заданными буквами. Обратите внимание на +1 во втором параметре среза. Таким образом, гарантируется, что последняя буква является включающей, а не исключающей.
После того, как определили все буквы в последовательности, используется метод get_addresses_by_first_letters() , о котором говорилось выше.