Словари и множества в Python
Множество в языке Python — это структура данных, эквивалентная множествам в математике. Элементы могут быть различных типов. Порядок элементов не определён.
Действия, которые можно выполнять с множеством:
- добавлять и удалять элементы,
- проверять принадлежность элемента множеству,
- перебирать его элементы,
- выполнять операции над множествами (объединение, пересечение, разность).
Операция “проверить принадлежность элемента” выполняется в множестве намного быстрее, чем в списке.
Элементами множества может быть любой неизменяемый тип данных: числа, строки, кортежи.
Изменяемые типы данных не могут быть элементами множества, в частности, нельзя сделать элементом множества список (вместо этого используйте неизменяемый кортеж) или другое множество. Требование неизменяемости элементов множества накладывается особенностями представления множества в памяти компьютера.
Задание множеств
Множество задается перечислением в фигурных скобках. Например:
Исключением явлеется пустое множество:
Если функции set передать в качестве параметра список, строку или кортеж, то она вернет множество, составленное из элементов списка, строки, кортежа. Например:
Каждый элемент может входить в множество только один раз.
Работа с элементами множеств
| Операция | Значение |
|---|---|
| x in A | принадлежит ли элемент x множеству A (возвращают значение типа bool ) |
| x not in A | то же, что not x in A |
| A.add(x) | добавить элемент x в множество A |
| A.discard(x) | удалить элемент x из множества A |
| A.remove(x) | удалить элемент x из множества A |
| A.pop() | удаляет из множества один случайный элемент и возвращает его |
Поведение discard и remove различается тогда, когда удаляемый элемент отсутствует в множестве: discard не делает ничего, а метод remove генерирует исключение KeyError . Метод pop также генерирует исключение KeyError , если множество пусто.
При помощи цикла for можно перебрать все элементы множества:
Из множества можно сделать список при помощи функции list :
Упражнение №1
Вывести на экран все элементы множества A, которых нет в множестве B.
Операции с множествами, обычные для математики
Упражнение №2
Даны четыре множества:
Найти элементы, принадлежащие множеству E :

Словарь (ассоциативный массив)
В массиве или в списке индекс — это целое число. Традиционной является следующая ситуация:
А как реализовать обратное соответствие?
При помощи списка или массива это сделать невозможно, нужно использовать ассоциативный массив или словарь.
В словаре индекс может быть любого неизменяемого типа! Индексы, как и сами хранимые значения, задаются явно:
При попытке обратиться к несуществующему элементу ассоциативного массива мы получаем исключение KeyError .
Особенностью ассоциативного массива является его динамичность: в него можно добавлять новые элементы с произвольными ключами и удалять уже существующие элементы.
При этом размер используемой памяти пропорционален размеру ассоциативного массива. Доступ к элементам ассоциативного массива выполняется хоть и медленнее, чем к обычным массивам, но в целом довольно быстро.
Значения ключей уникальны , двух одинаковых ключей в словаре быть не может. А вот значения могут быть одинаковыми.
Ключом может быть произвольный неизменяемый тип данных: целые и действительные числа, строки, кортежи. Ключом в словаре не может быть множество, но может быть элемент типа frozenset: специальный тип данных, являющийся аналогом типа set, который нельзя изменять после создания. Значением элемента словаря может быть любой тип данных, в том числе и изменяемый.
Создание словаря
Пустой словарь можно создать при помощи функции dict() или пустой пары фигурных скобок <> (вот почему фигурные скобки нельзя использовать для создания пустого множества).
Для создания словаря с некоторым набором начальных значений можно использовать следующие конструкции:
Также можно использовать генерацию словаря через Dict comprehensions:
Это особенно полезно, когда нужно «вывернуть» словарь наизнанку:
Операции с элементами словарей
Перебор элементов словаря по ключу
Представления элементов словаря
Представления во многом похожи на списки, но они остаются связанными со своим исходным словарём и изменяются, если менять значения элементов словаря.
- Метод keys возвращает представление ключей всех элементов.
- Метод values возвращает представление всех значений.
- Метод items возвращает представление всех пар (кортежей) из ключей и значений.
Учтите что итерироваться по представлениям изменяя словарь нельзя
Можно, если в начале скопировать представление в список
Пример использования словаря
Когда нужно использовать словари
Словари нужно использовать в следующих случаях:
- Подсчет числа каких-то объектов. В этом случае нужно завести словарь, в котором ключами являются объекты, а значениями — их количество.
- Хранение каких-либо данных, связанных с объектом. Ключи — объекты, значения — связанные с ними данные. Например, если нужно по названию месяца определить его порядковый номер, то это можно сделать при помощи словаря Num[‘January’] = 1; Num[‘February’] = 2; .
- Установка соответствия между объектами (например, “родитель—потомок”). Ключ — объект, значение — соответствующий ему объект.
- Если нужен обычный массив, но при этом масимальное значение индекса элемента очень велико, но при этом будут использоваться не все возможные индексы (так называемый “разреженный массив”), то можно использовать ассоциативный массив для экономии памяти.
Практическая работа по использованию словарей
Упражнение №3. Подсчет слов
Дан текст на некотором языке. Требуется подсчитать сколько раз каждое слово входит в этот текст и вывести десять самых часто употребяемых слов в этом тексте и количество их употреблений.
В качестве примера возьмите файл с текстом лицензионного соглашения Python /usr/share/licenses/python/LICENSE .
Подсказка №1: Используйте словарь, в котором ключ — слово, а знчение — количество таких слов.
Подсказка №2: Точки, запятые, вопросы и восклицательные знаки перед обработкой замените пробелами(используйте punctuation из модуля string).
Подсказка №3: Все слова приводите к нижнему регистру при помощи метода строки lower() .
Подсказка №4: По окончании сбора статистики нужно пробежать по всем ключам из словаря и найти ключ с максимальным значением.
Упражнение №4. Перевод текста
Дан словарь task4/en-ru.txt с однозначным соответствием английских и русских слов в таком формате:
cat — кошка
dog — собака
mouse — мышь
house — дом
eats — ест
in — в
too — тоже
Здесь английское и русское слово разделены двумя табуляциями и минусом: ‘\t-\t’ .
В файле task4/input.txt дан текст для перевода, например:
Требуется сделать подстрочный перевод с помощью имеющегося словаря и вывести результат в output.txt . Незнакомые словарю слова нужно оставлять в исходном виде.
Упражнение №5. Страны и Языки
Дан список стран и языков на которых говорят в этой стране в формате <Название Страны> : <язык1> <язык2> <язык3> . в файле task5/input.txt. На ввод задается N — длина списка и список языков. Для каждого языка укажите, в каких странах на нем говорят.
| Ввод | Вывод |
|---|---|
| 3 | |
| азербайджанский | Азербайджан |
| греческий | Кипр Греция |
| китайский | Китай Сингапур |
Упражнение №6. Сделать русско-английский словарь
В файле task6/en-ru.txt находятся строки англо-русского словаря в таком формате:
Здесь английское слово (выражение) и список русских слов (выражений) разделены двумя табуляциями и минусом: ‘\t-\t’ .
Требуется создать русско-английский словарь и вывести его в файл ru-en.txt в таком формате:
Порядок строк в выходном файле должен быть словарным с человеческой точки зрения (так называемый лексикографический порядок слов). То есть выходные строки нужно отсортировать.
Упражнение №7. Синхронизация словарей
Даны два файла словарей: task7/en-ru.txt и task7/ru-en.txt (в формате, описанном в упражнении №6).
Требуется синхронизировать и актуализировать их содержимое.
Упражнение №8. Добродушные соседи
В одном очень дружном доме, где живет Фёдор, многие жильцы оставляют ключи от квартиры соседям по дому, например на случай пожара или потопа, да и просто чтобы покормили животных или полили цветы.
Вернувшись домой после долгих странствий, Фёдор обнаруживает, что потерял свои ключи и соседей дома нет. Но вдруг у домофона он находит чужие ключи. Помогите Федору найти ключи от своей квартиры в квартирах соседей.
На ввод подается файл input.txt, в котором в первой строке записано три числа через пробел N — номер квартиры Фёдора, M — номер квартиры от которой Федор нашел ключи, K — ключ от этой квартиры. Далее i-я строка хранит описание ключей запертых в i-й квартире в формате <m_i0 — номер квартиры> <k_i0 — ключ>,<m_i1 — номер квартиры> <k_i1 — ключ>. , причем реальные номера квартир «зашифрованы» ключем от i-й квартиры(Ki) и находятся по формуле m_ij’ = m_ij — Ki. Номера квартир начинаются с 0 (кпримеру вторая строка файла соответствует 0-й квартире).
Нужно вывести ключ от квартиры Федора или None если его найти не получилось.
| Ввод | Вывод |
|---|---|
| 4 0 1 | 1 |
| 1 1,2 0,3 1,4 0 | |
| 3 0 | |
| 5 1,6 0 | |
| 1 1 | |
| 2 1 |
Подсказка: используйте словарь для хранения ключей от еще не открытых комнат и множество для уже проверенных комнат.
Упражнение №9. Факультативно: генератор бреда
Дан текст-образец, по которому требуется сделать генератор случайного бреда на основе Марковских цепей.
Исчерпывающее руководство по множествам в Python
Класс set (множество) — это одна из ключевых структур данных в Python. Она представляет собой неупорядоченную коллекцию уникальных элементов. Класс set , в некоторой степени, соответствует математическому множеству. Многие широко используемые математические операции, применимые к множествам, существуют и в Python. Часто вычисления, производимые над множествами, оказываются гораздо быстрее, чем альтернативные операции со списками. В результате, для того чтобы писать эффективный код, Python-программисту просто необходимо уметь пользоваться множествами. В этой статье я расскажу об особенностях работы с классом set в Python.
Инициализация множеств
Существует два способа создания объекта set : с использованием конструкции set(iterable) и путём помещения элементов, разделённых запятыми, в фигурные скобки — < . >. Если же при инициализации множества попытаться воспользоваться пустыми фигурными скобками — <> — тогда будет создан словарь, а не пустое множество. Для создания пустых множеств используется команда set() . Обратите внимание на то, что при инициализации множеств порядок элементов неважен, и на то, что дублирующиеся элементы в множество добавить не получится.
Какие элементы можно включить в состав множества? Это могут быть только элементы иммутабельных типов. Сюда входят такие типы, как float , int , string , bool и прочие подобные. А вот мутабельные типы — списки, словари, да и сами множества, в состав множеств включать нельзя. Если вас интересуют подробности о типах данных в Python — рекомендую почитать эту статью. Учитывая вышесказанное — следующая конструкция вызовет ошибку:
Но что если случается так, что в множествах надо хранить некие уникальные последовательности значений? Подробнее об этом мы поговорим в конце статьи.
Примечание об иммутабельности
Иммутабельность — это ограничение, касающееся лишь встроенных типов. На практике, чтобы объект можно было добавить в множество, или чтобы его можно было использовать в качестве ключа в словаре, этот объект всего лишь должен быть хешируемым. По умолчанию объекты пользовательских классов обладают хешем, основанным на их идентификаторах. Равенство объектов определяется по их идентификаторам. Это значит, что два объекта, идентичные в плане атрибутов, будут равны друг другу только тогда, когда они представляют один и тот же объект, или в том случае, если для них определён пользовательский оператор eq .
Если для некоего класса определён пользовательский оператор eq , то объекты этого класса перестают быть хешируемыми, если только для них не будет определён пользовательский оператор hash . Тут важно то, что если два объекта равны, то их хеши тоже должны быть равны. В противном случае при добавлении подобных объектов в словарь или в множество возникнут проблемы. Дело в том, что при проверке наличия значения в составе ключей словаря или в составе множества, проверяются и хеши и равенство объектов.
Единственный случай, когда в множестве имеет смысл хранить мутабельный объект, или когда такой объект может играть роль ключа словаря, это когда оператор проверки равенства объекта не использует его мутабельные атрибуты. Предположим, у некоего объекта имеется оператор равенства и соответствующая хеш-функция, основанные на атрибутах этого объекта. Если такой объект сначала добавить в множество, а потом поменять его, тогда хеш-значение, использованное при его сохранении, будет отличаться от текущего хеш-значения. Это — плохая практика.
Добавление элементов в множества
Существует множество способов добавления элементов в множество. Для того чтобы осуществить изменение (мутацию) множества, отдельный элемент в него можно добавить командой .add() . Итерируемый объект добавляют командой .update() , или, что то же самое, используя оператор |= :
Под «мутацией» я понимаю изменение исходного объекта. Есть ещё команды, которые не изменяют исходное множество. Например — метод . union() , или его эквивалент — оператор | :
Явное различие поведения методов .update() и .union() можно продемонстрировать, разобрав следующий пример:
И наконец — два множества можно конкатенировать, использовав деструктурирование:
Этот приём будет работать аналогично методу .union() , но я рекомендую пользоваться именно .union() .
Обратите внимание на то, что в предыдущих примерах я пользовался методом .update() , но в них можно было бы применить и оператор |= . Это значит, что a |= b ( .update() ) — это НЕ то же самое, что a = a | b (.union()) . Дело в том, что в первом фрагменте кода осуществляется изменение объекта, хранящегося в a , а во втором примере a назначается новое значение.
Удаление элементов множеств
Мы рассмотрели команды для добавления элементов в множества. Существуют похожие на них команды, применяемые при удалении элементов. Вот как эти команды можно соотнести с уже известными вам командами:
Аналог .add() — .remove() .
Аналог .update() — .difference_update() или -= .
Аналог .union() — .difference() или — .
Снова хочу обратить ваше внимание на то, что надо помнить о разнице между конструкциями вида a -= b (исходное множество изменяется) и a = a — b (исходное множество не изменяется).
Имеется и ещё несколько методов, которые могут пригодиться для удаления объектов:
.clear() — очищает множество.
.remove() — удаляет элемент лишь в том случае, если он существует (в противном случае выдаёт ошибку); .discard() — работает похожим образом, но, если элемента не существует, ошибку не возвращает.
.pop() — удалит случайный элемент из множества и вернёт этот элемент.
Другие операции для работы с множествами
Одна из сильных сторон Python-множеств заключается в наличии большого количества стандартных операций, предназначенных для работы с ними. Мы обсудили команды для модификации множеств путём добавления и удаления элементов, но это — далеко не всё, что можно делать с множествами.
Пересечение множеств
Пересечением двух множеств является множество элементов, входящих в состав обоих множеств. Для выполнения этой операции используются следующие методы и операторы:
Команды, при выполнении которых множество не меняется: .intersection() или & . Например — a.intersection(b) или a & b .
Команды, при выполнении которых множество меняется: .intersection_update() или &= .
Симметрическая разность множеств или дизъюнктивное объединение
Симметрическая разность множеств — это противоположность их пересечению. Она даёт все элементы, которые не принадлежат одновременно обоим исходным множествам. Для нахождения симметрической разности множеств используются следующие методы и операторы:
Команды, при выполнении которых множество не меняется: . symmetric_difference() или ^ . Например — a.symmmetric_difference(b) или a ^ b .
Команды, при выполнении которых множество меняется: .symmetric_difference_update() или ^= .
Методы проверки наличия элементов в множествах, сравнение множеств
Я рассказал о том, как модифицировать множества, но они, в основном, используются для того, чтобы быстро проверять, имеются ли в них некие элементы, или нет. Подобные операции, выполняемые на списках, будут медленнее. Посмотрим на конструкции, используемые для проверки наличия элементов в множествах, и на некоторые другие полезные команды.
Проверка принадлежности элемента множеству
Вероятно, это — та операция, к которой вы будете прибегать чаще, чем к другим. Проверка наличия элемента в множестве выполняется с помощью оператора in . А проверка отсутствия элемента — с помощью оператора not in . Для таких операций над множествами, в отличие от подобных проверок, выполняемых в применении к спискам, характерна константная временная сложность — O(1). В результате, по мере роста размеров множества, не будет страдать скорость проверки наличия или отсутствия в нём неких элементов.
Проверка того, является ли одно множество подмножеством другого
Множество является подмножеством другого множества в том случае, если все элементы первого множества входят в состав второго. Например, (A, B, C) — это подмножество (A, B, C, D) . В Python подобную проверку можно провести, воспользовавшись методом .issubset() или оператором <= . Чтобы проверить, является ли одно множество истинным подмножеством другого, то есть — что одно множество — это подмножество другого, и что эти множества не равны, можно воспользоваться оператором < . Но учитывайте, что ещё можно пользоваться операторами >= и > .
Проверка того, что в двух множествах нет общих элементов
Если в множествах нет общих элементов, их называют непересекающимися множествами. В Python соответствующая проверка выполняется с помощью метода .isdisjoint() .
Абстракция множеств
Так же, как и в случае со списками и словарями, при работе с множествами можно воспользоваться так называемой абстракцией множеств (set comprehension). Делается это путём добавления обрабатываемого выражения в фигурные скобки и через возврат единственного мутабельного элемента на каждом проходе цикла: < <element>for . in . > .
Хранение в множествах данных более сложных типов
Представьте, что у нас имеется цикл, на каждой итерации которого мы обходим некоторое количество узлов графа. Предположим, мы обошли граф два раза, у нас получились следующие пути:
Потом надо быстро проверить, прошлись ли мы по определённому пути. Нужно, чтобы такая проверка проводилась бы быстро, поэтому совершенно естественным будет использовать для её реализации множество. Как это сделать, если список, из-за его мутабельности, нельзя добавить в множество? К нашему счастью, в подобных обстоятельствах можно воспользоваться кортежем, классом tuple , который, по сути, представляет собой иммутабельную версию списка. Рассмотрим пример.
Сначала создадим граф, используя словарь. Ключи словаря будут представлять узлы графа, а значения — списки узлов, в которые можно перейти из текущего узла.
Визуализировав это описание, я получил такой граф.
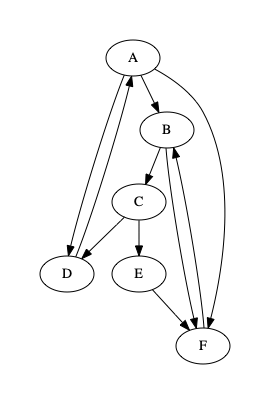
Граф
Если вы задаётесь вопросом о том, как я создал такой граф — знайте, что сделал я это, прибегнув к graphviz и написав следующий код:
Теперь я займусь случайным блужданием по графу, проходя от 1 до 10 узлов, после чего сохраню результирующие пути в объекте set в виде кортежей. Посмотрим, сколько уникальных путей мы сможем сгенерировать за 100 проходов по графу:
Из 100 случайных проходов по графу 83 оказались уникальными.
А что если нас не волнует порядок узлов, а нужно лишь сохранить сведения о посещённых узлах? Тогда будет смысл хранить отдельные пути в множествах, но, как уже было сказано, множества мутабельны, помещать их в другие множества нельзя. В такой ситуации, вместо обычных множеств, описываемых классом set , можно прибегнуть к неизменяемым множествам, представленным классом frozenset . Чтобы это сделать — поработаем с кодом цикла из предыдущего примера:
Итоги
Множества — это полезный инструмент Python-разработчика. Они позволяют очень быстро выполнять определённые операции, что способно значительно повысить эффективность кода. Кроме того, в Python имеется немало простых и полезных методов для работы с множествами, применение которых способствует упрощению кода.
О, а приходите к нам работать? �� ��
Мы в wunderfund.io занимаемся высокочастотной алготорговлей с 2014 года. Высокочастотная торговля — это непрерывное соревнование лучших программистов и математиков всего мира. Присоединившись к нам, вы станете частью этой увлекательной схватки.
Мы предлагаем интересные и сложные задачи по анализу данных и low latency разработке для увлеченных исследователей и программистов. Гибкий график и никакой бюрократии, решения быстро принимаются и воплощаются в жизнь.
Как из словаря сделать множество питон
В Python есть очень полезный тип данных для работы с множествами – это set. Об этом типе данных, примерах использования, и небольшой выдержке из теории множеств пойдёт речь далее.
Следует сразу сделать оговорку, что эта статья ни в коем случае не претендует на какую-либо математическую строгость и полноту, скорее это попытка доступно продемонстрировать примеры использования множеств в языке программирования Python.
Множество
Множество – это математический объект, являющийся набором, совокупностью, собранием каких-либо объектов, которые называются элементами этого множества. Или другими словами:
Что значит неупорядоченная? Это значит, что два множества эквивалентны, если содержат одинаковые элементы. 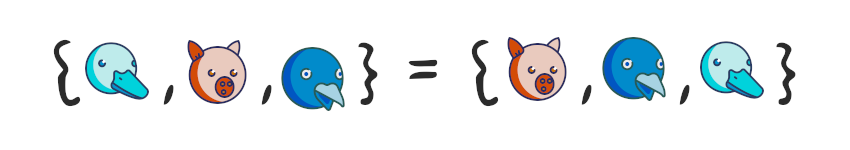
Элементы множества должны быть уникальными, множество не может содержать одинаковых элементов. Добавление элементов, которые уже есть в множестве, не изменяет это множество. 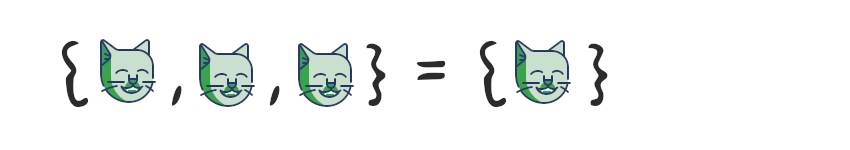
Множества, состоящие из конечного числа элементов, называются конечными, а остальные множества – бесконечными. Конечное множество, как следует из названия, можно задать перечислением его элементов. Так как темой этой статьи является практическое использование множеств в Python, то я предлагаю сосредоточиться на конечных множествах.
Множества в Python
Множество в Python можно создать несколькими способами. Самый простой – это задать множество перечислением его элементов в фигурных скобках:
Единственное ограничение, что таким образом нельзя создать пустое множество. Вместо этого будет создан пустой словарь:
Для создания пустого множества нужно непосредственно использовать set() :
Также в set() можно передать какой-либо объект, по которому можно проитерироваться (Iterable):
Ещё одна возможность создания множества – это использование set comprehension. Это специальная синтаксическая конструкция языка, которую иногда называют абстракцией множества по аналогии с list comprehension (Списковое включение).
Хешируемые объекты
Существует ограничение, что элементами множества (как и ключами словарей) в Python могут быть только так называемые хешируемые (Hashable) объекты. Это обусловлено тем фактом, что внутренняя реализация set основана на хеш-таблицах. Например, списки и словари – это изменяемые объекты, которые не могут быть элементами множеств. Большинство неизменяемых типов в Python (int, float, str, bool, и т.д.) – хешируемые. Неизменяемые коллекции, например tuple, являются хешируемыми, если хешируемы все их элементы.
Объекты пользовательских классов являются хешируемыми по умолчанию. Но практического смысла чаще всего в этом мало из-за того, что сравнение таких объектов выполняется по их адресу в памяти, т.е. невозможно создать два «равных» объекта.
Скорее всего мы предполагаем, что объекты City(«Moscow») должны быть равными, и следовательно в множестве cities должен находиться один объект.
Этого можно добиться, если определить семантику равенства для объектов класса City :
Чтобы протокол хеширования работал без явных и неявных логических ошибок, должны выполняться следующие условия:
- Хеш объекта не должен изменяться, пока этот объект существует
- Равные объекты должны возвращать одинаковый хеш
Свойства множеств
Тип set в Python является подтипом Collection (про коллекции), из данного факта есть три важных следствия:
- Определена операция проверки принадлежности элемента множеству
- Можно получить количество элементов в множестве
- Множества являются iterable-объектами
Принадлежность множеству
Проверить принадлежит ли какой-либо объект множеству можно с помощью оператора in . Это один из самых распространённых вариантов использования множеств. Такая операция выполняется в среднем за O(1) с теми же оговорками, которые существуют для хеш-таблиц.
Мощность множества
Мощность множества – это характеристика множества, которая для конечных множеств просто означает количество элементов в данном множестве. Для бесконечных множеств всё несколько сложнее.
Перебор элементов множества
Как уже было отмечено выше, множества поддерживают протокол итераторов, таким образом любое множество можно использовать там, где ожидается iterable-объект.
Отношения между множествами
Между множествами существуют несколько видов отношений, или другими словами взаимосвязей. Давайте рассмотрим возможные отношения между множествами в этом разделе.
Равные множества
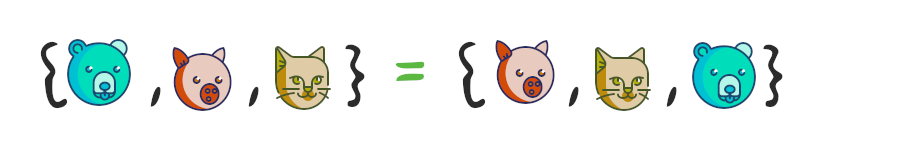
Тут всё довольно просто – два множества называются равными, если они состоят из одних и тех же элементов. Как следует из определения множества, порядок этих элементов не важен.
Непересекающиеся множества
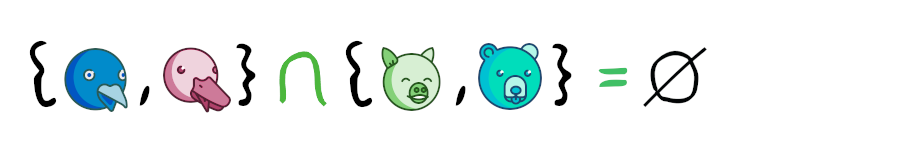
Если два множества не имеют общих элементов, то говорят, что эти множества не пересекаются. Или другими словами, пересечение этих множеств является пустым множеством.
Подмножество и надмножество
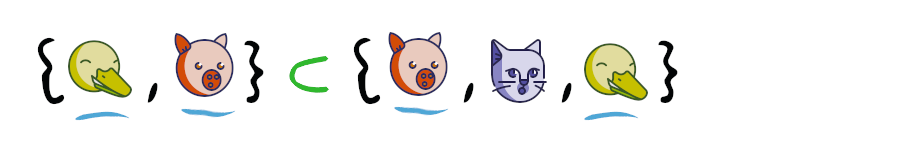
Подмножество множества S – это такое множество, каждый элемент которого является также и элементом множества S. Множество S в свою очередь является надмножеством исходного множества.
Пустое множество является подмножеством абсолютно любого множества.
Само множество является подмножеством самого себя.
Операции над множествами
Рассмотрим основные операции, опредяляемые над множествами.
Объединение множеств
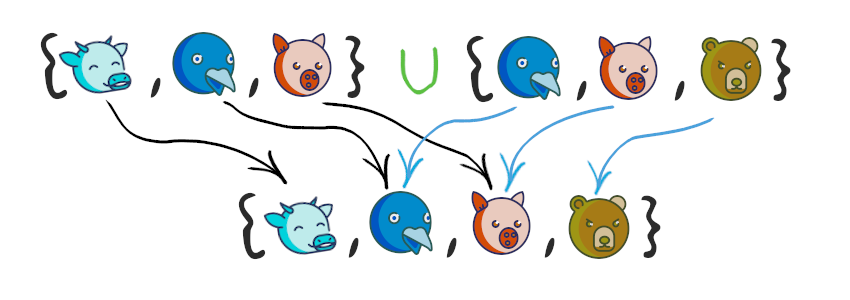
Объединение множеств – это множество, которое содержит все элементы исходных множеств. В Python есть несколько способов объединить множества, давайте рассмотрим их на примерах.
Добавление элементов в множество
Добавление элементов в множество можно рассматривать как частный случай объединения множеств за тем исключением, что добавление элементов изменяет исходное множество, а не создает новый объект. Добавление одного элемента в множество работает за O(1) .
Пересечение множеств
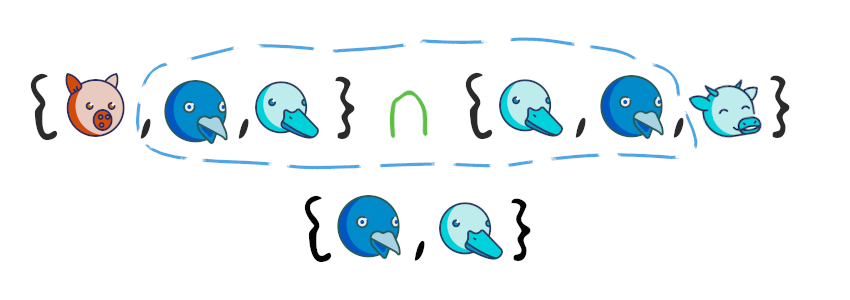
Пересечение множеств – это множество, в котором находятся только те элементы, которые принадлежат исходным множествам одновременно.
При использовании оператора & необходимо, чтобы оба операнда были объектами типа set . Метод intersection , в свою очередь, принимает любой iterable-объект. Если необходимо изменить исходное множество, а не возращать новое, то можно использовать метод intersection_update , который работает подобно методу intersection , но изменяет исходный объект-множество.
Разность множеств

Разность двух множеств – это множество, в которое входят все элементы первого множества, не входящие во второе множество.
Удаление элементов из множества
Удаление элемента из множества можно рассматривать как частный случай разности, где удаляемый элемент – это одноэлементное множество. Следует отметить, что удаление элемента, как и в аналогичном случае с добавлением элементов, изменяет исходное множество. Удаление одного элемента из множества имеет вычислительную сложность O(1) .
Также у множеств есть метод differenсe_update , который принимает iterable-объект и удаляет из исходного множества все элементы iterable-объекта. Этот метод работает аналогично методу difference , но изменяет исходное множество, а не возвращает новое.
Симметрическая разность множеств
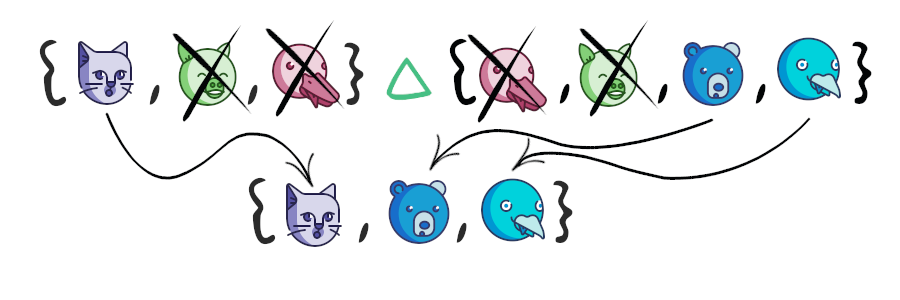
Симметрическая разность множеств – это множество, включающее все элементы исходных множеств, не принадлежащие одновременно обоим исходным множествам. Также симметрическую разность можно рассматривать как разность между объединением и пересечением исходных множеств.
Как видно из примера выше, число 0 принадлежит обоим исходным множествам, и поэтому оно не входит в результирующее множество. Для операции симметрической разности, помимо оператора ^ , также существует два специальных метода – symmetric_difference и symmetric_difference_update . Оба этих метода принимают iterable-объект в качестве аргумента, отличие же состоит в том, что symmetric_difference возвращает новый объект-множество, в то время как symmetric_difference_update изменяет исходное множество.
Заключение
Я надеюсь, мне удалось показать, что Python имеет очень удобные встроенные средства для работы с множествами. На практике это часто позволяет сократить количество кода, сделать его выразительнее и легче для восприятия, а следовательно и более поддерживаемым. Я буду рад, если у вас есть какие-либо конструктивные замечания и дополнения.
set — множества
Множества в языке Python позволяют хранить только уникальные объекты и во многом аналогичны математическим множествам. Допустим у нас есть строка ‘ABCABCABCABCDABCABC’ , если передать данную строку функции set() , то она будет преобразована в множество:
Как видите, в множество поали только уникальные символы. Причем, при быстром взгляде на эту строку, могло показаться, что она состоит только из символов‘A’, ‘B’ и ‘C’, но на самом деле в ней был спрятан еще один символ — ‘D’. Именно поэтому множества очень удобно использовать для поиска уникальных значений, например, в списках:
Множества крайне удобны еще и тем что поддерживают ряд специфичных для множеств операций. Допустим у нас есть две строки:
Что бы узнать, есть ли у данных строк общие символы, мы можем преобразовать их в множества:
А затем выполнить следующую операцию:
Еще мы можем посмотреть какие буквы есть в A но не содержатся в B :
Или взглянуть только на те символы, которые не являются общими для двух множеств:
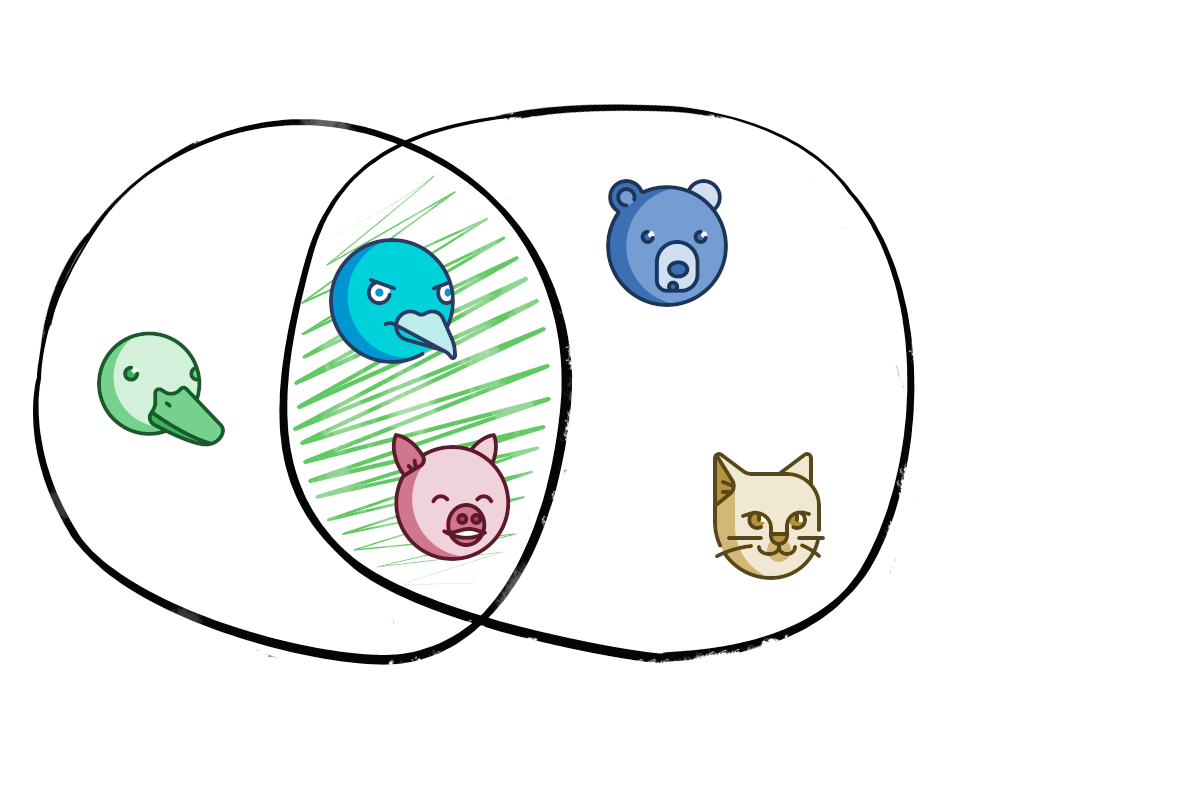
Поскольку A и B являются множествами, то изобразить эти операции можно с помощью привычных диаграмм Вена:

Создание множеств
Множество может быть создано путем перечисления его элементов через запятую и заключением их в фигурные скобки:
А вот создать пустое множество с помощью <> уже не получится, так как пустые фигурные скобки являются литералом словарей:
Создать пустое множество можно только с помощью функции set() :
Если передать функции set() некоторый объект, то она попытается преобразовать его в множество:
Если передать функции set() другое множество, то он будет возвращено как бы без изменений, но на самом деле будет возвращена его поверхностная копия:
Множества типа set являются изменяемыми и в них могут добавляться элементы. Это может привести к тому, что если две переменные ссылаются на одно и тоже, множество то изменение одной приведет к изменению другой:
Поверхностное копирование множеств позволяет избежать таких проблем:
Множества могут быть созданы с помощью генераторов множеств:
Элементы множеств
Элементами множеств могут быть только неизменяемые объекты таких типов как int, float, complex, str, frozenset, а чаще всего и объекты типа tuple
Но если попытаться создать множества из элементов изменяемого типа (list, set, dict), то это приведет к ошибке:
Объекты типа tuple могут быть элементами множеств, только если они сами состоят из неизменяемых объектов:
Это связано с тем, что на самом деле объектами множеств могут быть не просто неизменяемые объекты, они должны быть еще и хешируемыми. Хешируемые объекты имеют специальный метод __hash__() возвращаемое значение которого, у таких элементов не меняется с момента создания и до момента утилизации.
В том случае если кортеж состоит из неизменяемых элементов, то он является хешируемым (и неизменяемым):
Но если в кортеже есть изменяемые элементы, то эти элементы могут быть изменены:
Поэтому и хеш для таких кортежей не создается:
Но если ваши кортежи состоят из неизменяемых объектов, то можете смело создавать из них множество.
Обход множеств в цикле
Множества так же как последовательности (строки, списки и т.д) и отображения (словари) являются коллекциями, т.е. могут хранить сложные структуры данных (например, кортежи). Но так как элементы множеств не снабжены никакими идентификаторами (ни индексами, ни ключами), то множества не поддерживают операторы извлечения среза [START:STOP:STEP] и извлечения элемента по ключу [] . Тем не менее множества поддерживают оператор проверки на вхождение in (а так же not in ) и функцию определения размера len() :
Множества поддерживают механизм итерирования и их элементы могут быть получены перебором в цикле for. in. :
Чаще всего множества используются для итерирования уникальных элементов последовательностей. И тут возможны два случая. Давайте рассмотрим следующий список:
В первом случае, может быть неважно в каком порядке обрабатываются элементы, главное обрабатывать только уникальные:
Во втором случае, по прежнему нужно обрабатывать только уникальные элементы, но порядок следования элементов в списке может оказаться важен. В этом случае используют пустые множества:
Так же множества могут выступать в роли итерируемого объекта в любых генераторах:
frozenset — неизменяемые множества
Множества типа frozenset в отличие от set являются неизменяемыми и хешируемыми, т.е. могут быть ключами словарей и могут быть подмножествами других множеств. Создать фиксированное множество можно только с помощью функции frozenset() , без аргументов данная функция создает пустое фиксированное множество:
Если frozenset() передать итерируемый объект, то будет выполнена попытка преобразовать его в фиксированное множество:
Ну а если передать frozenset() другое множество, то будет возвращена его поверхностная копия:
Фиксированные множества действительно могут быть ключами словарей и подмножествами других множеств, что может быть удобно в некоторых ситуациях:
Фиксированные множества поддерживают только те операторы и методы которые не приводят к изменению объектов, но это не мешает делать ссылки переменных на резульат манипуляций над фиксированными множествами, например:
В этом смысле, множества похожи на строки или кортежи, которые тоже являются неизменяемыми, но которые могут служить «основой» для создания новых неизменяемых объектов.
Двухместные операторы множеств, могут быть применены к множествам типа set и frozenset одновременнно, но тип результата, будет зависеть от того, какой тип указан первым в этом операторе:
При этом множества и фиксированные множества могут проверяться на равенство состава элементов:
Поверхностное и глубокое копирование
Если несколько переменных ссылается на одно и то же множество, например вот так:
То изменение данных посредством одной из них, повлияет на все остальные переменные:
Что бы избежать подобного поведения необходимо создать поверхностную копию множества, передав его функции set() или вызвав метод .copy() :
Поскольку, множества могут хранить только хешируемые объекты (т.е. те которые точно не могут быть изменены), то проблем с глубоким копированием возникнуть не должно. Однако, чисто теоретически, кто-то может создать объекты, метод __hash__() которых переопределен по другому (если честно, даже не могу представить кому и зачем это может понадобиться). То в этом случае, в множестве могут оказаться нехешируемые (!) и даже одинаковые элементы. В этом случае, придется прибегать к глубокому копированию множеств с помощью функции deepcopy() из модуля copy() стандартной библиотеки.
Множества в Python
Множества (set) в Python — это встроенный тип, предлагающий широкий набор возможностей, которые повторяют теорию множеств из математики. Тем не менее интерпретация может отличаться от той, что принята в математике. Set импортировать не нужно. А в этом материале вы узнаете о нем все, что потребуется для работы.
Что это
Множества — это неупорядоченная коллекция уникальных элементов, сгруппированных под одним именем. Множество может быть неоднородным — включать элементы разных типов. Множество всегда состоит только из уникальных элементов (дубли запрещены) в отличие от списков и кортежей в Python. Объект set — это также коллекция уникальных хэшируемых объектов. Объект называется хэшируемым в том случае, если его значение хэша не меняется. Это используется в ключах словарей и элементах множеств, ведь значения хэшей применяются в их внутренних структурах.
Чаще всего множества в Python используются для проверки на принадлежность, удаления повторов из последовательности и выполнения математических операций, таких как пересечение, объединение, поиск разностей и симметрических разностей. Изображение ниже показывает два примера множеств (алфавит и цифры), каждый из которых включает уникальные неизменяемые объекты.
Создание множеств Python
Создать объект set в Python можно двумя путями:
- Использовать фигурные скобки <>
- Использовать встроенную функцию set()
Примечание: не используйте зарезервированные ключевые слова и названия встроенных классов в качестве имен для множеств. Это не поощряется в программировании на Python.
Множество создается при размещении всех элементов внутри фигурных скобок <> , как показано на примере ниже.
Еще один способ создать (или определить) множество Python — использовать функцию set() . Пример ниже.
Первый способ (с использованием фигурных скобок <> ) определенно проще.
Нет ограничений на количество элементов в объекте set , но запрещено добавлять элементы изменяемых типов, такие как список или словарь. Если попробовать добавить список (с набором элементов), интерпретатор выдаст ошибку.
Добавление элементов в множества Python
Объекты set в Python поддерживают добавление элементов двумя путями: по одному с помощью метода add() или группами с помощью update() . Оба описаны дальше.
Добавление одного элемента в множество Python
Один элемент можно добавить с помощью метода add() . Такой код выглядит следующим образом.
Добавление нескольких элементов в множество Python
Больше одного элемента можно добавить с помощью update() . Код следующий.
Удаление элементов из множеств Python
Один или несколько элементов можно удалить из объекта set с помощью следующих методов. Их отличие в виде возвращаемого значения.
- remove()
- discard()
- pop()
remove()
Метод remove() полезен в тех случаях, когда нужно удалить из множества конкретный элемент и вернуть ошибку в том случае, если его нет в объекте.
Следующий код показывает метод remove() в действии.
discard()
Метод discard() полезен, потому что он удаляет конкретный элемент и не возвращает ошибку, если тот не был найден во множестве.
Метод pop() удаляет по одному элементу за раз в случайном порядке. Set — это неупорядоченная коллекция, поэтому pop() не требует аргументов (индексов в этом случае). Метод pop() можно воспринимать как неконтролируемый способ удаления элементов по одному из множеств в Python.
Методы множеств Python
У объектов set есть несколько встроенных методов. Увидеть их все можно с помощью команды dir() . dir(object) в Python показывает самые важные атрибуты разных типов объектов.
Вот что выдаст функция для объекта set в Python.
Часто используемые функции множеств Python
Из всех методов, перечисленных в dir() , только несколько из них используются постоянно. Вы уже знакомы с add , update , remove , pop и discard .
Вот на какие также стоит обратить внимание.
Функция принадлежности (членства)
Она проверяет на наличие конкретного элемента в множестве.
Разные функции
len(num_set) — вернет количество элементов в объекте set .
copy() — создает копию существующего множества и сохраняет ее в новом объекте.
clear() —очищает множество (удаляет все элементы за раз)
del — удаляет множество целиком
Дальше речь пойдет об операциях union , issubset , issuperset , difference_update и других.
Операции множеств в Python
В этом разделе вы узнаете о разных операциях над множествами, которые являются частью теории множеств.
Объединение множеств
При использовании на двух множествах вы получаете новый объект, содержащий элементы обоих (без повторов). Операция объединения в Python выполняется двумя способам: с помощью символа | или метода union() .
Пересечение множеств
При использовании на двух множествах вы получаете новый объект, содержащий общие элементы обоих (без повторов). Операция пересечения выполняется двумя способами: с помощью символа & или метода intersection() .
Разность множеств
При использовании на двух множествах вы получаете новый объект, содержащий элементы, которые есть в первом, но не втором (в данном случае — в множестве “A”). Операция разности выполняется двумя способами: с помощью символа — или метода difference() .
Симметричная разность множеств
При использовании на двух множествах вы получаете новый объект, содержащий все элементы, кроме тех, что есть в обоих. Симметрическая разность выполняется двумя способами: с помощью символа ^ или метода symmetric_difference() .
Подмножество и надмножество в Python
Множество B ( SetB ) называется подмножество A ( SetA ), если все элементы SetB есть в SetA . Проверить на подмножество в Python можно двумя способами: с помощью символа <= или метода issubset() . Он возвращает True или False в зависимости от результата.
Множество A ( SetA ) называется надмножество B ( SetB ), если все элементы SetB есть в SetA . Проверить на надмножество в Python можно двумя способами: с помощью символа >= или метода issuperset() . Он возвращает True или False в зависимости от результата.
Бонус
А теперь бонус для тех, кто дочитал до этого места. Многие начинающие программисты задаются вопросом, как удалить повторяющиеся элементы из списка?
Ответ: просто передайте список функции set() и все дубли будут удалены автоматически. Результат потом можно снова передать в функцию list() , чтобы он снова стал списком.
Выводы
Теперь вы знакомы с объектами set в Python и теорией множеств на практике. Знаете как создавать множества, менять их, добавляя или удаляя элементы. Вы также знаете, как использовать метод dir и другие методы для множеств в Python. Наконец, познакомились с операциями union , intersection , difference , symmetric difference , subset и superset .
Множества в Python (set, frozenset)
Не слишком строгое определение множества, однако, с ним возникали проблемы даже у великих математиков.
В широком смысле, элементами множеств могут быть даже нематериальные вещи: чётные числа, несданные задачи по термодинамике, алгоритмы сортировки, любимые фильмы Юлии и Алексея и даже мысли об эклерах.
�� Возьмите в руки кота. Взяли? Хорошо. Теперь множество котов в ваших руках насчитывает ровно один мурлыкающий элемент. Если же пушистику вдруг не понравится, что вы его тискаете, и он выскочит из рук, то элементов внутри множества не останется. Множество, в котором нет ни одного элемента, называется пустым. Но что же там в Python?
Назначение в Python
Множества (set) в питоне появились не сразу, и здесь они представлены как неупорядоченные коллекции уникальных и неизменяемых объектов. Коллекции, которые не являются ни последовательностями (как списки), ни отображениями (как словари). Хотя с последними у множеств много общего.
Можно сказать, что set напоминает словарь, в котором ключи не имеют соответствующих им значений
- Дают возможность быстро удалять дубликаты, поскольку, по определению, могут содержать только уникальные элементы;
- Позволяют, в отличие от других коллекций, выполнять над собой ряд математических операций, таких как объединение, пересечение и разность множеств;
Пример set-ов в Python:
# множество натуральных чисел от 1 до 10 natural_num_set = <1, 2, 3, 4, 5, 6, 7, 8, 9, 10># множество персонажей Братства Кольца the_fellowship_of_the_ring_set = <'Гэндальф', 'Арагорн', 'Фродо', 'Сэм', 'Боромир', 'Леголас', 'Гимли', 'Мерри', 'Пиппин'># множество приближений math.sqrt(2) sqrt_approximation_set = <1.4142135623, 1.414213562, 1.41421356, 1.4142135, 1.414213># множество результатов какого-то голосования vote_result_set =
Особенности set
Одно из основных свойств множеств заключается в уникальности каждого из их элементов. Посмотрим, что получится, если сформировать set из строчки с заведомо повторяющимися символами:
strange_app = set('TikTok') print(strange_app) >
Из результата были удалены дублирующиеся в слове 'TikTok' символы. Так множества в очередной раз доказали, что содержат в себе только уникальные элементы.
�� Немаловажным является и тот факт, что при литеральном объявлении, итерируемые объекты сохраняют свою структуру.
pangram_second = set('съешь же ещё этих мягких французских булок, да выпей чаю') print(pangram_ second) # попить чаю с функцией set(), к сожалению, не выйдет >
Отдельное python множество может включать в себя объекты разных типов:
Здесь нет никакого противоречия с математической дефиницией, так как все составляющие we_are_the_py_objects имеют вполне конкретное общее свойство, являясь объектами языка Питон.
Но не стоит забывать и внутреннее определение set-ов. Важно помнить, что list-ы и dict-ы не подходят на роль элементов множества, из-за своей изменяемой природы.
glados = <['Great cake']>print(glados) > Traceback (most recent call last): glados = <['Great cake']>TypeError: unhashable type: 'list'
Функция set() , тем не менее, корректно обрабатывает случаи, когда ей на вход подаются списки или словари.
# словарь будет преобразован во множество его ключей, значения отбрасываются some_dict = <'key_one': 'val_one', 'key_two': 'val_two'>some_set = set(some_dict) print(some_set) > <'key_one', 'key_two'># элементы списка преобразуются в элементы множества, дубликаты удаляются card_suit = ['heart', 'diamond', 'club', 'spade', 'spade'] suit_set = set(card_suit) print(suit_set) >
Однако в списках не должно быть вложенных изменяемых элементов.
tricky_list = [<'jocker': 'black'>, <'jocker': 'red'>] sad_set = set(tricky_list) print(sad_set) > Traceback (most recent call last): sad_set = set(tricky_list) TypeError: unhashable type: 'dict'
Работа с set-ами
Создание
Объявим Python-множество S . Существует два способа это сделать:
Способ №1 . Воспользовавшись литералом:
Способ №2 . Применив встроенную функцию set() :
Чтобы получить аналогичный результат, необходимо передать итерируемый объект (список, строку или кортеж) в качестве аргумента:
# объявим список L L = ['1', '2', '3'] # и предоставим его в set() S_2 = set(L) print(S_2) # так как set — коллекция неупорядоченная, то результат вывода может отличаться > <'1', '2', '3'>print(type(S_2)) > <class 'set'>
�� Замечание: пустое множество создаётся исключительно через set()
empty_set = set() print(empty_set) > set() print(type(empty_set)) > <class 'set'>
Если же сделать так:
another_empty_set = <> print(another_empty_set) > <> print(type(another_empty_set)) > <class 'dict'>
То получим пустой словарь. А если внутри фигурных скобок поместить пустую строку:
maybe_empty_set = <''>print(maybe_empty_set) > <''>print(type(maybe_empty_set)) > <class 'set'>
То на выходе увидим множество, состоящее из одного элемента — этой самой пустой строки.
# количество элементов множества print(len(maybe_empty_set)) > 1
Вполне естественно, что пустое множество, при приведении его к логическому типу, тождественно ложно:
true_or_false = set() print(bool(true_or_false)) > False
Пересечение
В программировании нередки задачи, в которых требуется найти совпадающие элементы двух коллекций. Классическое решение основано на цикле for , но нас интересует другое — то, что строится на использовании set-ов.
# пусть есть два списка, и нужно отыскать и вывести их одинаковые компоненты unbreakable_diamond = ['Jotaro', 'Josuke', 'Koichi'] golden_wind = ['Jotaro', 'Koichi', 'Giorno'] # & — здесь оператор пересечения overlap = set(unbreakable_diamond) & set(golden_wind) print(overlap) >
Добавление элемента
Для добавления нового элемента в существующий набор используем метод add(x) .
Если среди исходных объектов, составляющих set, "x" уже был, то ничего не произойдёт, и начальное множество не изменится.
Удаление и очистка
Очистить и свести уже существующий сет к пустому не составит никаких проблем благодаря методу сlear() :
Для удаления одного единственного компонента из набора в Питоне определены аж три способа.
Способ №1 . Метод remove() . Метод удаляет элемент elem из set -а. В случае отсутствия elem в наборе интерпретатор выбрасывает исключение.
Способ №2 . Метод discard() . Производит предельно схожую с remove() операцию с той лишь разницей, что, в случае отсутствия элемента в коллекции, исключение не возникает:
triangle_coord = <(0, 4), (3, 0), (-3, 0)>print(triangle_coord) > <(3, 0), (-3, 0), (0, 4)>triangle_coord.discard((0, 4)) print(triangle_coord) > <(3, 0), (-3, 0)>triangle_coord.discard((54, 55)) print(triangle_coord) >
Способ №3 . Метод pop() .
Удаляет и возвращает случайный элемент множества:
Перебор элементов
Множество, как и любую другую коллекцию, итерируем циклом for :
iterate_me = <1.1, 1.2, 1.3, 1.4, 1.5>for num in iterate_me: print(num) > 1.1 1.4 1.3 1.2 1.5
Принадлежность объекта set-у
Оператор in даёт возможность проверить наличие элемента в наборе:
Сортировка множеств
Операция сортировки отсутствует для множеств Python по определению. Множество — неупорядоченный набор. Но не нужно расстраиваться. С помощью функции sorted() , вы всегда можете получить отсортированный список:
Длина множества
Размеры определенного set -а получаем функцией len() :
Операции на множествах
Самое важное в этой теме. Математические теоретико-множественные операции, что не доступны никаким другим коллекциям языка. Поехали.
Объединение
(оператор | , логическое ИЛИ )
Объединением двух множеств "X" и "Y" является такое третье множество "Z", каждый элемент которого принадлежит либо множеству "X", либо "Y".
Пересечение
(оператор & , логическое И )
Пересечением двух множеств "A" и "B" является такое третье множество "C", каждый элемент которого принадлежит и множеству "A", и множеству "B".
bats_enemies = <'Darkside', 'Jocker', 'Bane'>sups_enemies = <'General Zod', 'Darkside', 'Lobo'>JL_enemies = bats_enemies.intersection(sups_enemies) # или так JL_enemies = bats_enemies & sups_enemies print(JL_enemies) >
Разность множеств
Разностью двух множеств "O" и "P" является такое третье множество "S", каждый элемент которого принадлежит множеству "O" и не принадлежит множеству "P".
minuend = <23, 44, 1, 34, 98>subtrahend = <23, 44, 1, 55, 76>total = minuend.difference(subtrahend) # или так total = minuend — subtrahend print(total) >
Симметрическая разность
Симметрической разностью двух множеств "M" и "N" является такое третье множество "L", каждый элемент которого принадлежит либо множеству "M", либо "N", но не их пересечению.
Помимо теоретико-множественных операций, в питоне существуют и сугубо утилитарные производные методы.
isdisjoint()
Метод определяет, есть ли у двух set-ов общие элементы:
В Python нет оператора, который бы соответствовал этому методу.
issubset()
Показывает, является ли "I" подмножеством "J" (Метод вернет True, если все элементы "I" принадлежат "J"):
solar_system = <'Mercury', 'Venus', 'Earth', 'Mars', 'Jupiter', 'Saturn', 'Uranus', 'Neptune'>first_three_planets = <'Mercury', 'Venus', 'Earth'>poor_small_guy = <'Pluto'>emptyness = set() print(first_three_planets.issubset(solar_system)) # или так first_three_planets <= solar_system > True print(poor_small_guy.issubset(solar_system)) # poor_small_guy <= solar_system > False # как и в математике, пустое множество есть подмножество любого множества print(emptyness.issubset(solar_system)) # emptyness <= solar_system > True # также любое множество является подмножеством самого себя print(poor_small_guy.issubset(poor_small_guy)) # poor_small_guy <= poor_small_guy > True
Оператор < определяет, является ли одно множество строгим подмножеством другого. В большинстве ситуаций, он ведёт себя точно так же, как и <= , кроме последнего случая. Сравниваемые наборы не должны быть идентичными. Таким образом, для данного оператора не существует соответствующего метода.
print(poor_small_guy.issubset(poor_small_guy)) # poor_small_guy < poor_small_guy > False
issuperset()
Показывает, является ли "F" надмножеством "G":
print(solar_system.issuperset(first_three_planets)) # solar_system >= first_three_planets > True print(poor_small_guy.issuperset(solar_system)) # poor_small_guy >= solar_system > False # в сердечке Плутона лишь пустота… print(poor_small_guy.issuperset(emptyness)) # poor_small_guy >= emptyness > True
Особенности оператора строгого надмножества > идентичны таковым у < .
print(poor_small_guy > poor_small_guy) > False
И для него в языке Python тоже не существует соответствующего метода.
Квартет методов, которые присваивают set -у результат его объединения с другим множеством. "Другое множество" передаётся методу в качестве аргумента.
update()
Изменяет исходное множество по объединению:
dogs_in_first_harness = <'Lessie', 'Bork', 'Spark'>dogs_in_second_harness = <'Lucky'>dogs_in_second_harness.update(dogs_in_first_harness) # или так dogs_in_second_harness |= dogs_in_first_harness print(dogs_in_second_harness) >
intersection_update()
basin_measurements_west = <-8745, -9000, -7990>basin_measurements_east = <-7990, -6934, -8100>basin_measurements_west.intersection_update(basin_measurements_east) # или так basin_measurements_west &= basin_measurements_east print(basin_measurements_west) >
difference_update()
prices_may = <100, 200, 125>prices_june = <100, 200, 300>prices_may.difference_update(prices_june) # или так prices_may -= prices_june print(prices_may) >
symmetric_difference_update()
И, наконец, по симметрической разности:
Свойства методов и операторов
Как показано выше, данные операции, за некоторым исключением, выполнятся двумя способами: при помощи метода или соответствующего ему оператора (например union() и оператор | ). Главным и основным их различием является то, что метод может принимать в качестве аргумента не только set , но и любой итерируемый объект, в то время, как оператор требует в качестве операндов наличие фактических множеств.
list_of_years = [2019, 2018, 2017] set_of_years = <2009, 2010, 2011>print(set_of_years.union(list_of_years)) > <2017, 2018, 2019, 2009, 2010, 2011>print(set_of_years | list_of_years) > Traceback (most recent call last):> print(set_of_years | list_of_years) TypeError: unsupported operand type(s) for |: 'set' and 'list'
Но есть и сходства. Например, важным является то, что некоторые операторы и методы позволяют совершать операции над несколькими сетами сразу:
one = set('11111') two = set('22222') three = set('33333') four = set('44444') five = set('55555') uni_set_v1 = one.union(two, three, four, five) print(uni_set_v1) > <'2', '1', '5', '3', '4'>uni_set_v2 = one | two | three | four | five print(uni_set_v2) > <'2', '1', '5', '3', '4'>es1 = <11, 21, 31, 311, 3111>es2 = <111, 211, 311, 411>es3 = <1111, 2111, 3111, 4111># порядок выполнения операций слева —> направо print(es1 — es2 — es3) > <11, 21, 31>print(es1.difference(es2, es3)) >
Тем интереснее, что оператор ^ симметрической разности позволяет использовать несколько наборов, а метод symmetric_difference() — нет.
tc1 = <10.1, 20.2, 30.3, 40.4, 50.5>tc2 = <10.1, 20.2, 30.3, 40.4, 500>tc3 = <1, 50.1, 1000>print(tc1 ^ tc2 ^ tc3) # вы же помните про порядок операций (слева-направо)? > <1, 1000, 50.1, 50.5, 500>print(tc1.symmetric_difference(tc2, tc3)) > Traceback (most recent call last): print(tc1.symmetric_difference(tc2, tc3)) TypeError: symmetric_difference() takes exactly one argument (2 given)
Преобразования
Конвертация строки во множество
Чтобы перевести строку во множество, достаточно представить её в виде литерала этого множества.
my_string = 'Lorem ipsum dolor sit amet' sting_to_set =
Конвертация списка во множество
Со списком подобный трюк не пройдет, но здесь на помощь спешит функция set() :
my_list = [2, 4, 8, 16, 32] list_to_set = set(my_list) print(list_to_set) >
Frozenset
Закончим статью описанием такой структуры данных, что максимально близка Python-множествам. Она называется Frozenset .
Frozen set -ы, по сути, отличаются от обычных лишь тем, что являются неизменяемым типом данных, в то время, как простой set возможно изменять.