Зная, что кодировке ASCII десятичной код каждой строчной латинской буквы на 32 больше кода соответствующей прописанной буквы, декодируйте следующее сообщение :77 105 99 107 101 121 32 77 111 117 115 1?
Зная, что кодировке ASCII десятичной код каждой строчной латинской буквы на 32 больше кода соответствующей прописанной буквы, декодируйте следующее сообщение :
77 105 99 107 101 121 32 77 111 117 115 101.

В кодировке ASCII код английской буквы A = 65, коды остальных букв соответствуют их порядкув алфавите (B — 66, b — 98, C — 67, c — 99, D — 68, d — 100, E — 69, e — 101 и т.
расшифровка сообщения77 105 99 107 101 121 32 77 111 117 115 101 :

Закодируйте в двоичной форме свою фамилию, записанную латинскими буквами, используя таблицу «Стандартная часть кода ASCII»?
Закодируйте в двоичной форме свою фамилию, записанную латинскими буквами, используя таблицу «Стандартная часть кода ASCII».
(моя фамилия – Бажанова).

Определите десятичный ASCII — код символа «t», если известны следующие коды : A — 65, T — 84, a — 97?
Определите десятичный ASCII — код символа «t», если известны следующие коды : A — 65, T — 84, a — 97.

Для пяти букв латинского алфавита заданы их двоичные коды( для некоторых букв — из двух битов, для некоторых — из трёх битов )?
Для пяти букв латинского алфавита заданы их двоичные коды( для некоторых букв — из двух битов, для некоторых — из трёх битов ).
Эти коды представлены в таблице.

Буква «G»в таблице кодировки символов имеет десятичный код 71?
Буква «G»в таблице кодировки символов имеет десятичный код 71.
Что зашифровано последовательностью десятичных кодов : 77 63 78 85?

Код в кодировочной таблице ASCII английской буквы «A» — 65, код английской буквы «a» — 97?
Код в кодировочной таблице ASCII английской буквы «A» — 65, код английской буквы «a» — 97.
Закодировать слово Shift.
Дан символ?
Запиши десятичный код для данного символа, если используется таблица кодировки ASCII.

Пожалуйста скажите ?
Каждая буква исходного текста заменяется третьей после неё буквой в алфавите русского языка, который считается записанным по кругу!
Декодируй следующее сообщение :
еугйжг рз жзогзх жсдуг — .
Используя код Цезаря, закодируй следующее слово :
Каждая буква латинского алфавита закодирована двузначным шестнадцатеричным числом, причем код каждой последующей буквы на 1 больше кода предыдущей буквы?
Каждая буква латинского алфавита закодирована двузначным шестнадцатеричным числом, причем код каждой последующей буквы на 1 больше кода предыдущей буквы.
Известно что кодируется как 41.
Расшифруйте закодированное слово 424547494E.
Латинский алфавит : ABCDEFGHIJKLMNOPQRSTUVWXYZ.
Если латинская буква А имеет код 00001010, буква В — код 00001011, то какой код будет иметь следующая по порядку буква С?
Если латинская буква А имеет код 00001010, буква В — код 00001011, то какой код будет иметь следующая по порядку буква С?
Если латинская буква А имеет код 00001010, буква В — код 00001011, то какой код будет иметь следующая по порядку буква С?
Если латинская буква А имеет код 00001010, буква В — код 00001011, то какой код будет иметь следующая по порядку буква С?
На этой странице находится ответ на вопрос Зная, что кодировке ASCII десятичной код каждой строчной латинской буквы на 32 больше кода соответствующей прописанной буквы, декодируйте следующее сообщение :77 105 99 107 101 121 32 77 111 117 115 1?, из категории Информатика, соответствующий программе для 5 — 9 классов. Чтобы посмотреть другие ответы воспользуйтесь «умным поиском»: с помощью ключевых слов подберите похожие вопросы и ответы в категории Информатика. Ответ, полностью соответствующий критериям вашего поиска, можно найти с помощью простого интерфейса: нажмите кнопку вверху страницы и сформулируйте вопрос иначе. Обратите внимание на варианты ответов других пользователей, которые можно не только просмотреть, но и прокомментировать.
Ответы Учебник Информатика 7 класс — §4.6.Оценка количественных параметров текстовых документов Босова
Ответы (решебник) к учебнику по Информатике — 7 класс, параграф 4.6 — Босова Л.Л., Босова А.Ю. , задания 1-10
Глава 4. Обработка текстовой информации
§4.6. Оценка количественных параметров текстовых документов ГДЗ, Информатика 7 класс Босова ответы на «Вопросы и задания»
1. Ознакомьтесь с материалами презентации к параграфу, содержащейся в электронном приложении к учебнику. Дополняет ли презентация информацию, содержащуюся в тексте параграфа?
2. Почему кодировки, в которых каждый символ кодируется цепочкой из восьми нулей и единиц, называются иначе однобайтовыми?
1 байт = 8 битам, значит можно составить последовательность из 00000000 или 11111111, этой последовательностью можно закодировать 255 символов. Значит, каждый символ кодируется 1 байтом, по этому такую кодировку можно назвать однобайтовой
3. С какой целью была введена кодировка Unicode? Найдите дополнительную информацию об этой кодировке.
Восьмиразрядные кодировки обладают одним серьёзным ограничением: количество различных кодов символов в этих кодировках недостаточно велико, чтобы можно было одновременно пользоваться более чем двумя языками. Для устранения этого ограничения был разработан новый стандарт кодирования символов, получивший название Unicode. В Unicode каждый символ кодируется шестнадцатиразрядным двоичным кодом. Такое количество разрядов позволяет закодировать 65 536 различных символов:
2^16 = 65 536.
4. При работе в Интернете информация на одном из сайтов отобразилась так, как показано ниже.
Это произошло из-за:
1) установленной на компьютере системы контентной фильтрации 2) неправильных настроек монитора 3) неверного определения кодировки страницы
Ответ
Это произошло из-за. Неверного определение кодировки страницы.
5. Зная, что в кодировке ASCII десятичный код каждой строчной латинской буквы на 32 больше кода соответствующей прописной буквы, декодируйте следующее сообщение:
77 105 107 107 121 32 77 111 117 115 101
В кодировке ASCII код английской буквы A = 65, коды остальных букв соответствуют их порядку в алфавите (B — 66, b — 98, C — 67, c — 99, D — 68, d — 100, E — 69, e — 101 и т.д.) ⇒
расшифровка сообщения 77 105 99 107 101 121 32 77 111 117 115 101:
Mickey Mouse
6. Считая, что каждый символ кодируется одним байтом, определите, чему равен информационный объём следующего высказывания Алексея Толстого: Не ошибается тот, кто ничего не делает, хотя это и есть его основная ошибка.
1) 512 битов 2) 608 битов 3) 8 Кбайт 4) 123 байта
Во фразе 76 букв вместе со знаками и пробелами.
76*8 = 608 бит.
7. Считая, что каждый символ кодируется 16 битами, оцените информационный объем следующей фразы А. С. Пушкина в кодировке Unicode:
Привычка свыше нам дана: Замена счастию она.
1) 44 бита 2) 704 бита 3) 44 байта 4) 704 байта
В высказывании 44 символа.
44 * 16 = 704 бита.
Ответ: правильный вариант 2 — 704 бита.
8. В текстовом режиме экран монитора компьютера обычно разбивается на 25 строк по 80 символов в строке. Определите объём текста, занимающего весь экран монитора, в кодировке Unicode.
25 строк по 80 символов это 2580 = 2000 знаков.
В кодировке Unicode каждый знак кодируется 2 байтами.
Получается 20002 = 4000 байт.
9. Сообщение занимает 6 страниц по 40 строк, в каждой строке записано по 60 символов. Информационный объём всего сообщения равен 28 800 байтам. Сколько двоичных разрядов было использовано для кодирования одного символа?
60 * 40 * 6 = 14 400 символов со всем сообщении.
28 800 / 14 400 = 2 байта отводится на 1 символ.
2 байта = 16 битам.
Ответ: для кодирования одного символа использовано 16 двоичных разрядов.
10. Сообщение, информационный объём которого равен 5 Кбайт, занимает 4 страницы по 32 строки, в каждой из которых записано по 40 символов. Сколько символов в алфавите языка, на котором записано это сообщение?
40 * 32 * 4 = 5120 символов в сообщении.
5 Кбайт = 5120 байт.
5120 / 5120 = 1 байт, значит, на кодирование 1 символа отводится 8 бит.
Получается, в алфавите 2^8 = 256 символов.
На этой странице размещен вариант решения заданий с страниц учебника по информатике за 7 класс авторов Босова. Здесь вы сможете списать решение домашнего задания или просто посмотреть ответы. ГДЗ
Литература: Учебник по Информатике, 7 класс. Автор: Босова Л.Л., Босова А.Ю. Издательство: Бином. Год: 2016, 2017
Оценка количественных параметров текстовых документов

Текст состоит из символов — букв, цифр, знаков препинания и т. д., которые человек различает по начертанию. Компьютер различает вводимые символы по их двоичному коду. Вы нажимаете на клавиатуре символьную клавишу, и в компьютер поступает определённая последовательность электрических импульсов разной силы, которую можно представить в виде цепочки из восьми нулей и единиц (двоичного кода).
Мы уже говорили о том, что разрядность двоичного кода i и количество возможных кодовых комбинаций N связаны соотношением: 2 i = N. Восьмиразрядный двоичный код позволяет получить 256 различных кодовых комбинаций: 2 8 = 256.
С помощью такого количества кодовых комбинаций можно закодировать все символы, расположенные на клавиатуре компьютера, — строчные и прописные русские и латинские буквы, цифры, знаки препинания, знаки арифметических операций, скобки и т. д., а также ряд управляющих символов, без которых невозможно создание текстового документа (удаление предыдущего символа, перевод строки, пробел и др.).
Соответствие между изображениями символов и кодами символов устанавливается с помощью кодовых таблиц.
Все кодовые таблицы, используемые в любых компьютерах и любых операционных системах, подчиняются международным стандартам кодирования символов.
Кодовая таблица содержит коды для 256 различных символов, пронумерованных от О до 255. Первые 128 кодов во всех кодовых таблицах соответствуют одним и тем же символам:
• коды с номерами от О до 32 соответствуют управляющим символам;
• коды с номерами от 33 до 127 соответствуют изображаемым символам — латинским буквам, знакам препинания, цифрам, знакам арифметических операций и т. д.
Эти коды были разработаны в США и получили название ASCII (American Standart Code for Information Interchange — Американский стандартный код для обмена информацией).
В таблице 4.1 представлен фрагмент кодировки ASCII.
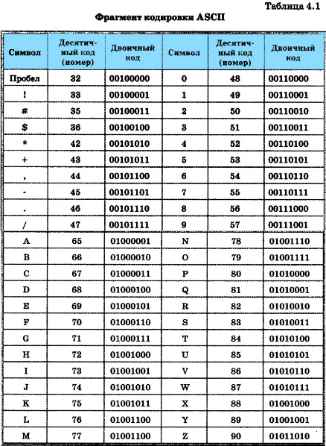
Коды с номерами от 128 до 255 используются для кодирования букв национального алфавита, символов национальной валюты и т. п. Поэтому в кодовых таблицах для разных языков одному и тому же коду соответствуют разные символы. Более того, для многих языков существует несколько вариантов кодовых таблиц (например, для русского языка их около десятка!).
В таблице 4.2 представлены десятичные и двоичные коды нескольких букв русского алфавита в двух различных кодировках.
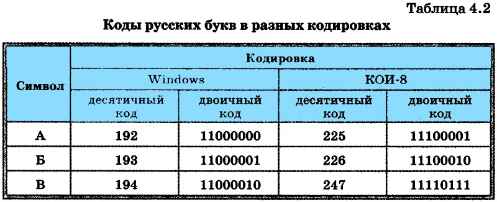
Например, последовательности двоичных кодов
11010010 11000101 11001010 11010001 11010010
в кодировке Windows будет соответствовать слово «ТЕКСТ», а в кодировке КОИ-8 — бессмысленный набор символов «рейяр».
Как правило, пользователь не должен заботиться о перекодировании текстовых документов, так как это делают специальные про- граммы-конверторы, встроенные в операционную систему и приложения.
Восьмиразрядные кодировки обладают одним серьёзным ограничением: количество различных кодов символов в этих кодировках недостаточно велико, чтобы можно было одновременно пользоваться более чем двумя языками. Для устранения этого ограничения был разработан новый стандарт кодирования символов, получивший название Unicode. В Unicode каждый символ кодируется шестнадцатиразрядным двоичным кодом. Такое количество разрядов позволяет закодировать 65 536 различных символов:
Первые 128 символов в Unicode совпадают с таблицей ASCII; далее размещены алфавиты всех современных языков, а также все математические и иные научные символьные обозначения. С каждым годом Unicode получает всё более широкое распространение.
В Единой коллекции цифровых образовательных ресурсов (http://sc.edu.ai) размещены анимации:
которые помогут вам наглядно увидеть, как формируется код символа, введённого с клавиатуры.
4.6.2. Информационный объём фрагмента текста
Вам известно, что информационный объём сообщения I равен произведению количества символов К в сообщении на информационный вес символа алфавита i:I = K • i.
 В зависимости от разрядности используемой кодировки информационный вес символа текста, создаваемого на компьютере, может быть равен:
• 8 битов (1 байт) — восьмиразрядная кодировка;
• 16 битов (2 байта) — шестнадцатиразрядная кодировка.
 Информационным объёмом фрагмента текста будем называть количество битов, байтов или производных единиц (килобайтов, мегабайтов и т. д.), необходимых для записи этого фрагмента заранее оговорённым способом двоичного кодирования.
Задача 1. Считая, что каждый символ кодируется одним байтом, определите, чему равен информационный объём следующего высказывания Жан-Жака Руссо:
Тысячи путей ведут к заблуждению, к истине — только один.
Решение. В данном тексте 57 символов (с учётом знаков препинания и пробелов). Каждый символ кодируется одним байтом. Следовательно, информационный объём всего текста — 57 байтов.
Ответ: 57 байтов.
Задача 2. В кодировке Unicode на каждый символ отводится два байта. Определите информационный объём текста из 24 символов в этой кодировке.
Решение. I = 24 • 2 = 48 байтов.
Ответ: 48 байтов.
Задача 3. Автоматическое устройство осуществило перекодировку информационного сообщения на русском языке, первоначально записанного в 8-битовом коде, в 16-битовую кодировку Unicode. При этом информационное сообщение увеличилось на 2048 байтов. Каков был информационный объём сообщения до перекодировки?
Решение. Информационный вес каждого символа в 16-битовой кодировке в два раза больше информационного веса символа в 8-битовой кодировке. Поэтому при перекодировании исходного блока информации из 8-битовой кодировки в 16-битовую его информационный объём должен был увеличиться вдвое, другими словами, на величину, равную исходному информационному объёму. Следовательно, информационный объём сообщения до перекодировки составлял 2048 байтов = 2 Кб.
Ответ: 2 Кб.
Задача 4. Выразите в мегабайтах объём текстовой информации в «Современном словаре иностранных слов» из 740 страниц, если на одной странице размещается в среднем 60 строк по 80 символов (включая пробелы). Считайте, что при записи использовался алфавит мощностью 256 символов.
Решение. Информационный вес символа алфавита мощностью 256 равен восьми битам (одному байту). Количество символов во всём словаре равно 740 • 80 • 60 = 3 552 ООО. Следовательно, объём этого текста в байтах равен 3 552 ООО байтов = 3 468,75 Кбайт ≈ 3,39 Мбайт.
Ответ: 3,39 Мбайт.
САМОЕ ГЛАВНОЕ
Текст состоит из символов — букв, цифр, знаков препинания и т. д., которые человек различает по начертанию. Компьютер различает вводимые символы по их двоичному коду. Соответствие между изображениями и кодами символов устанавливается с помощью кодовых таблиц.
В зависимости от разрядности используемой кодировки информационный вес символа текста, создаваемого на компьютере, может быть равен:
• 8 битов (1 байт) — восьмиразрядная кодировка;
• 16 битов (2 байта) — шестнадцатиразрядная кодировка.
Информационный объём фрагмента текста — это количество битов, байтов (килобайтов, мегабайтов), необходимых для записи фрагмента оговорённым способом кодирования.
Вопросы и задания
1. Ознакомьтесь с материалами презентации к параграфу, содержащейся в электронном приложении к учебнику. Используйте эти материалы при подготовке ответов на вопросы и выполнении заданий.
2. Почему кодировки, в которых каждый символ кодируется цепочкой из восьми нулей и единиц, называются иначе однобайтовыми?
3. С какой целью была введена кодировка Unicode? Найдите дополнительную информацию об этой кодировке.
4. При работе в Интернете информация на одном из сайтов отобразилась так. как показано ниже.

Это произошло из-за:
1) установленной на компьютере системы контентной фильтрации
2) неправильных настроек монитора
3) неверного определения кодировки страницы
5. Зная, что в кодировке ASCII десятичный код каждой строчной латинской буквы на 32 больше кода соответствующей прописной буквы, декодируйте следующее сообщение:
77 105 107 107 121 32 77 111 117 115 101
6. Считая, что каждый символ кодируется одним байтом, определите, чему равен информационный объём следующего высказывания Алексея Толстого:
Не ошибается тот, кто ничего не делает, хотя это и есть его основная ошибка.
7. Считая, что каждый символ кодируется 16 битами, оцените информационный объем следующей фразы А. С. Пушкина в кодировке Unicode:
Привычка свыше нам дана: Замена счастию она.
8. В текстовом режиме экран монитора компьютера обычно разбивается на 25 строк по 80 символов в строке. Определите объём текста, занимающего весь экран монитора, в кодировке Unicode.
9. Сообщение занимает 6 страниц по 40 строк, в каждой строке записано по 60 символов. Информационный объём всего сообщения равен 28 800 байтам. Сколько двоичных разрядов было использовано для кодирования одного символа?
10. Сообщение, информационный объём которого равен 5 Кбайт, занимает 4 страницы по 32 строки, в каждой из которых записано по 40 символов. Сколько символов в алфавите языка, на котором записано это сообщение?
Электронное приложение к учебнику
Презентация «Оценка количественных параметров текстовых документов» (Open Document Format)
Ссылки на ресурсы ЕК ЦОР
- тренажер «Интерактивный задачник. Раздел "Представление символьной информации"» (N 119265)
http://school-collection.edu.ru/catalog/res/c7f4d16f-4956-41fe-b3a4-562ee67db716/?
Ссылки на ресурсы ФЦИОР
- информационный модуль по теме «Представление текста в различных кодировках»
http://fcior.edu.ru/card/28666/predstavlenie-teksta-v-razlichnyh-kodirovkah.html - практический модуль теме «Представление текста в различных кодировках»
http://fcior.edu.ru/card/2524/predstavlenie-teksta-v-razlichnyh-kodirovkah.html - контрольный модуль по теме «Представление текста в различных кодировках»
http://fcior.edu.ru/card/10902/predstavlenie-teksta-v-razlichnyh-kodirovkah.html
Презентация «Оценка количественных параметров текстовых документов»
Единая коллекция цифровых образовательных ресурсов
 1) тренажер «Интерактивный задачник. Раздел "Представление символьной информации"» (N 119265).
http://sc.edu.ru/catalog/res/c7f4d16f-4956-41fe-b3a4-562ee67db716/? — Карточка ресурса на портале Единой коллекции ЦОР
Ресурсы ФЦИОР
(Внимание! Для воспроизведения модуля необходимо установить на компьютере проигрыватель ресурсов.) Скачать проигрыватель ресурсов ФЦИОР
1) информационный модуль по теме «Представление текста в различных кодировках»;
2) практический модуль теме «Представление текста в различных кодировках»;
3) контрольный модуль по теме «Представление текста в различных кодировках».
Практическая часть урока
1) Выполнить задания № 218, № 219, № 221, № 223, № 225, № 230 в РТ.
2) Работа учащихся с тренажером «Интерактивный задачник. Раздел "Представление символьной информации"» (N 119265) в режиме практики.
Практическая работа №12
"Сканирование и распознавание текстовых документов"
Задание 1. Сканирование
1. Откройте крышку подключенного к компьютеру планшетного сканера. Положите документ на стекло сканера сканируемой стороной (текстом) вниз. Аккуратно закройте крышку сканера.
2. Запустите программу сканирования, идущую в комплекте с вашим сканером. Исследуйте панель инструментов программы сканирования, найдите кнопкуСканировать и щелкните на ней.
3. Дождитесь окончания сканирования.
4. Сохраните отсканированный документ в личной папке виде графического файла с именем Скан и одним из расширений tif, bmb, jpg, png и др.
5. Завершите работу с программой сканирования.
Задание 2. Распознавание
1. Подключитесь к Интернету, запустив браузер Chrome.
2. Запустите бесплатный онлайн-сервис распознавания текстов (www.newocr.com).
Для работы с сайтом можете воспользоваться автоматическим переводом. Если переводчик не включен, то можно перевести страницу, нажав на ней правой кнопкой мыши и выбрав в контекстном меню Перевести на русский.
3. Нажмите на кнопку Выберите файл, найдите и откройте созданный в предыдущем задании файл.
4. Щелкните мышью на кнопке  . Дождитесь загрузки изображения (
 ); при необходимости поверните его (
 ).
5. Щелкните мышью на кнопке  . Дождитесь окончания распознавания ( ) и появления области с распознанным текстом.
6. Загрузите распознанный текст в текстовый процессор Word:

7. Включите режим отображения скрытых символов форматирования (  ). Проведите редактирование текстового документа: удалите лишние символы конца абзаца, обратите внимание на неуверенно распознанные слова и символы.
8. Сохраните результат работы в личной папке в файле Распознавание.
Теперь вы умеете:
• сканировать текстовые документы;
• выполнять распознавание отсканированных текстовых документов с помощью онлайн-сервиса.
Зная, что в кодировке ASCII десятичный код каждой строчной латинской буквы на 32 больше кода соответствующей прописной буквы, декодируйте следующее сообщение: 77. 105. 99. 107. 101. 121. 32. 77. 111. 117. 115. 101
⭐⭐⭐⭐⭐ Лучший ответ на вопрос «Зная, что в кодировке ASCII десятичный код каждой строчной латинской буквы на 32 больше кода соответствующей прописной буквы, декодируйте следующее сообщение: 77. 105. 99. 107. 101. 121. 32. 77. 111. 117. 115. 101» от пользователя Vasilisa Dmitrieva в разделе Экономика. Задавайте вопросы и делитесь своими знаниями.