Как подсчитать пропущенные значения в Pandas DataFrame
Часто вас может заинтересовать подсчет количества пропущенных значений в кадре данных pandas.
В этом руководстве показано несколько примеров подсчета пропущенных значений с использованием следующего кадра данных:
Подсчитайте общее количество пропущенных значений во всем DataFrame
В следующем коде показано, как рассчитать общее количество пропущенных значений во всем DataFrame:
Это говорит нам о том, что всего пропущено 5 значений.
Подсчитайте общее количество пропущенных значений в столбце
В следующем коде показано, как рассчитать общее количество пропущенных значений в каждом столбце DataFrame:
Это говорит нам:
- Столбец «а» имеет 2 пропущенных значения.
- Столбец «b» имеет 2 пропущенных значения.
- Столбец «c» имеет 1 пропущенное значение.
Вы также можете отобразить количество пропущенных значений в процентах от всего столбца:
Это говорит нам:
- 33,33% значений в столбце «а» отсутствуют.
- 33,33% значений в столбце «b» отсутствуют.
- 16,67% значений в столбце «c» отсутствуют.
Подсчитайте общее количество пропущенных значений в строке
В следующем коде показано, как рассчитать общее количество пропущенных значений в каждой строке DataFrame:
Finding the Percentage of Missing Values in a Pandas DataFrame

In this tutorial, we will cover an efficient and straightforward method for finding the percentage of missing values in a Pandas DataFrame. This tutorial is available as a video on YouTube.
Non-intuitive Solution
The final solution to this problem is not quite intuitive for most people when they first encounter it. We will slowly build up to it and also provide some other methods that get us a result that is close but not exactly what we want.
Flights Dataset
We begin by reading in the flights dataset, which contains US domestic flight information during the year 2015. Pandas defaults the number of visible columns to 20. Since there are 31 columns in this DataFrame, we change this option below.
After inspecting the first few rows of the DataFrame, it is generally a good idea to find the total number of rows and columns with the shape attribute.
The info method
Pandas comes with a couple methods that get us close to what we want without getting us all the way there. The info method prints to the screen the number of non-missing values of each column, along with the data types of each column and some other meta-data.
The count method
The count method returns the number of non-missing values for each column or row. By default, it operates column-wise. It doesn’t give us any more information that is already available with the info method. Below, we just output the last 5 values.
Работа с отсутствующими значениями в Pandas
Отсутствующее значение в наборе данных отображается как вопросительный знак, ноль, NaN или просто пустая ячейка. Но как можно справиться с недостающими данными?
Конечно, каждая ситуация отличается и должна оцениваться по-разному.
Есть много способов справиться с недостающими значениями. Рассмотрим типичные варианты на примере набора данных — ‘Titanic’. Эти данные являются открытым набором данных Kaggle.
Для анализа необходимо импортировать библиотеки Python и загрузить данные.
Для загрузки используется метод Pandas read.csv(). В скобках указывается путь к файлу в кавычках, чтобы Pandas считывал файл во фрейм данных (Dataframes — df) с этого адреса. Путь к файлу может быть URL адрес или вашим локальным адресом файла.

Показывает первые 2 строки загруженного фрейма данных
Посмотрим на размер данных (количество строк, колонок):
Для просмотра статистической сводки каждого столбца, чтобы узнать распределение данных в каждом столбце используется метод describe( ). Этот метод показывает нам количество строк в столбце — count, среднее значение столбца — mean, столбец стандартное отклонение — std, минимальные (min) и максимальные (max) значения, а также границу каждого квартиля — 25%, 50% и 75%. Любые значения NaN автоматически пропускаются.
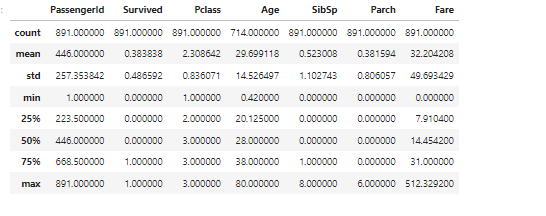
метод describe( )
По умолчанию, метод describe( ) пропускает строки и столбцы не содержащие чисел — категориальные признаки. Чтобы включить сводку по всем столбцам нужно в скобках добавить аргумент — include = «all».
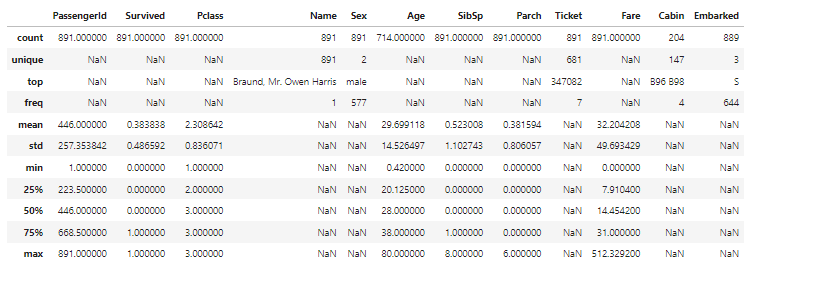
метод describe(include = «all»)
Для категориальных признаков этот метод показывает: — Сколько уникальных значений в наборе данных — unique; top значения; частота появления значений — freg.
Метод info( ) — показывает информацию о наборе данных, индекс, столбцы и тип данных, ненулевые значения и использование памяти.
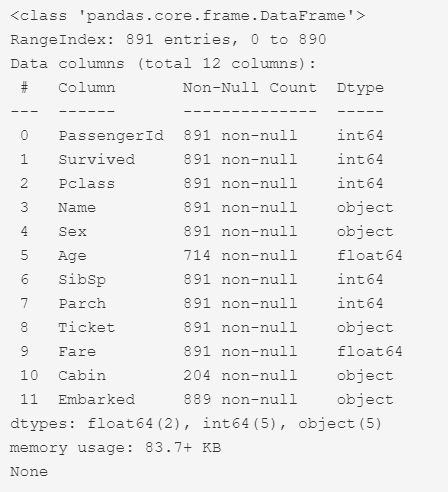
показывает информацию о наборе данных, индекс, столбцы и тип данных, ненулевые значения и использование памяти.
В результате мы видим, что все колонки, кроме колонок ‘Age’, ‘Cabin’ и ‘Embarked’, содержат по 891 строк.
Колонка ‘Survived’ — это целевое значение. Показывает, кто выжил, а кто — нет. Эта колонка заполнена бинарными значениями:
Метод — value_counts(). Подсчет значений — это хороший способ понять, сколько единиц каждой характеристики / переменной у нас есть.
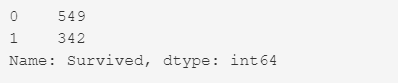
подсчет значений в колонке ‘Survived’
Из 891 пассажира выжило 342.
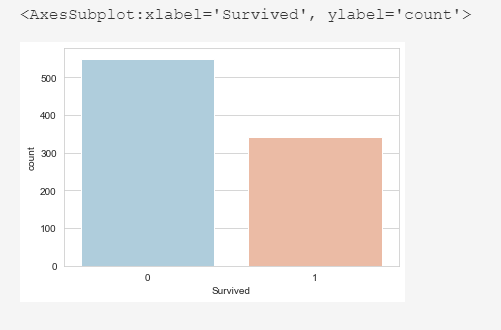
график подсчет значений в колонке ‘Survived’
Из 891 пассажира выжило 342 это 38%.
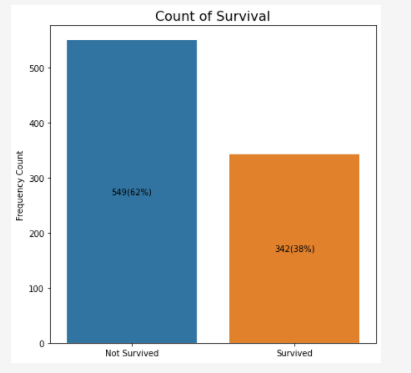
График подсчет значений в колонке ‘Survived’
Визуализация: Графики подсчета значений в колонках — «Survived», «Pclass», «Sex», «SibSp», «Parch», «Embarked»
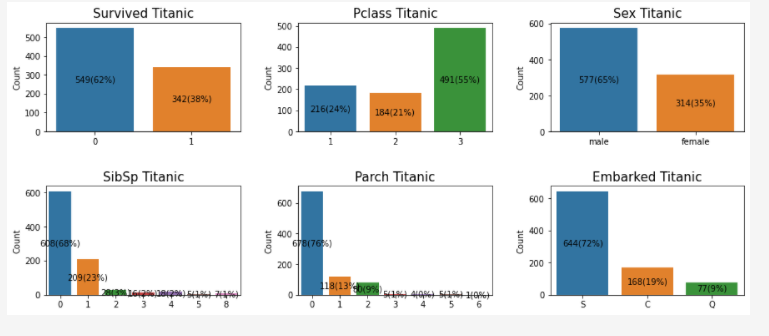
Графики подсчета значений в колонках — «Survived», «Pclass», «Sex», «SibSp», «Parch», «Embarked»
Теперь посмотрим на колонки которые имеют пропущенные значения.
Есть два метода обнаружения недостающих данных: — isnull() и notnull().
Результатом является логическое значение, указывающее, действительно ли значение, переданное в аргумент, отсутствует. «Истина» ( True ) означает, что значение является отсутствующим значением, а «Ложь» ( False ) означает, что значение не является отсутствующим.
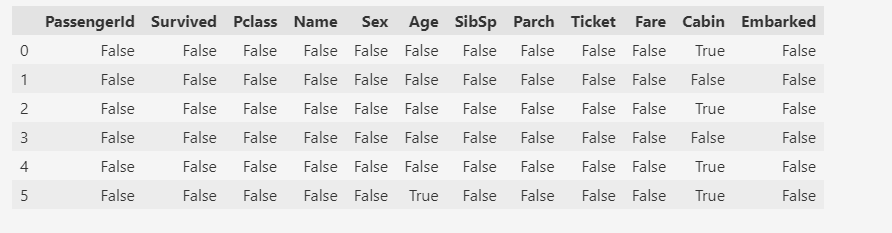
True — пропущенные значения
Используя цикл for в Python, мы можем быстро определить количество пропущенных значений в каждом столбце. Как упоминалось выше, «Истина» представляет отсутствующее значение, а «Ложь» означает, что значение присутствует в наборе данных. В теле цикла for метод «.value_counts ()» подсчитывает количество значений «True».
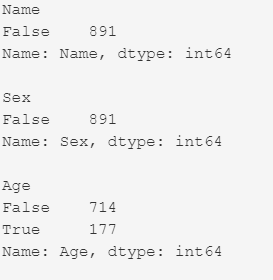 количество пропущенных значений в каждом столбце.
 количество пропущенных значений в каждом столбце.
Посмотрим — сколько пропущенных значений в каждой колонке.
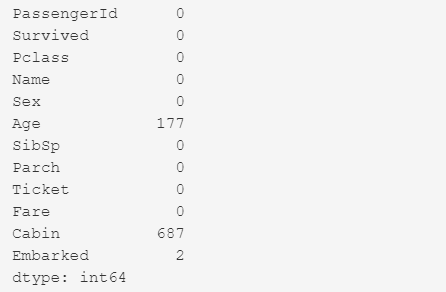
количество пропущенных значений в каждом столбце.
В колонке возраст — ‘Age’ не указано 177 значений. И нужно понять — это систематическая ошибка или какая-то случайная погрешность.
Н-р, может у пассажиров 1 класса (или у женщин) не спрашивали про возраст ( т. к. это было не прилично), или случайно пропустили. Понимание о причине пропущенных значений, определит — как работать с этими отсутствующими данными.
Нужно сгруппировать возраст, относительно того, отсутствует возраст или нет. Для группировки используем метод groupby().
True — отсутствует возраст
False — значение заполнено
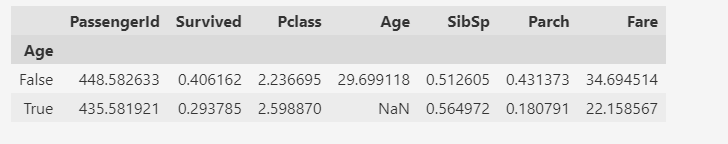
метод groupby(). True — отсутствует возраст, False — значение заполнено
Среди пассажиров, у которых значение возраста отсутствовало, были выжившие (около 30%) и погибшие (около 70%) — колонка ‘Survived’, True = 0.29 .
Эти пассажиры были в более низком классе:
колонка ‘Pclass’ — True = 2.59 (это среднее значение класса)
колонка ‘Fare’ — True = 22.15 (это среднее значение стоимости билета)
Подсчет значений в колонке ‘Pclass’:
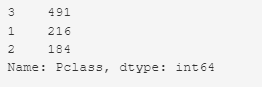
Подсчет значений в колонке ‘Pclass’
Например, в 3 классе было 491 пассажира (это 55%)
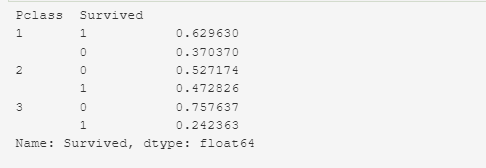
Выживаемость пассажиров по классам
Для более детального анализа, создадим новую колонку ‘Age_NaN’ (бинарный классификатор). Используем метод where(), где прописываем условие: — если значение в колонке ‘Age’ отсутствует, то присваиваем в колонке ‘Age_NaN’ — значение 0, если присутствует, то 1.

первые 6 строк фрейма данных с новой колонкой ‘Age_NaN’
Подсчет значений в колонке ‘Age_NaN’
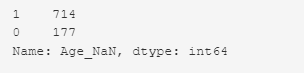
Подсчет значений в колонке ‘Age_NaN’
Выживаемость пассажиров в зависимости от наличия записи о возрасте.
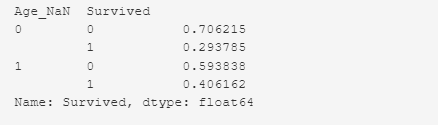
Выживаемость пассажиров в зависимости от наличия записи о возрасте.
И снова мы видим: — что, среди пассажиров, у которых значение возраста отсутствовало, были выжившие (около 30%) и погибшие (около 70%).
Выживаемость пассажиров в зависимости от наличия записи о возрасте и класса.
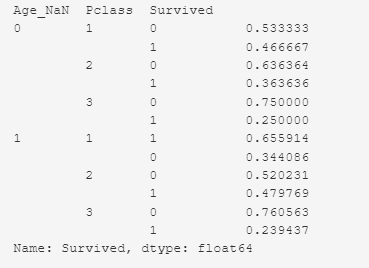 Выживаемость пассажиров в зависимости от наличия записи о возрасте и класса.
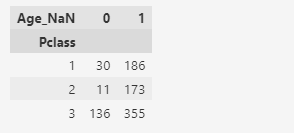 зависимость от наличия записи о возрасте и класса.
В первом классе запись отсутствует у 30 пассажиров. Из 30 пассажиров выжило — 46%(14 пассажиров), погибло — 53%(16 пассажиров). Всего пассажиров было в первом классе — 216 (в данном наборе данных).
Во втором классе запись отсутствует у 11 пассажиров. Из 11 пассажиров выжило — 36%(4 пассажира), погибло — 63% (7 пассажиров). Всего пассажиров было во втором классе — 184 (в данном наборе данных).
В третьем классе запись отсутствует у 136 пассажиров. Из 136 пассажиров выжило — 25% (34 пассажира), погибло — 75% (102 пассажира). Всего пассажиров было в третьем классе — 491 (в данном наборе данных).
Выживаемость пассажиров в зависимости от наличия записи о возрасте и пола.
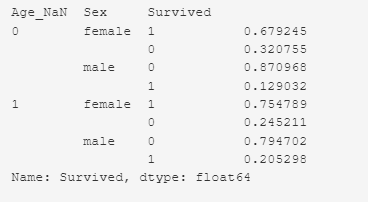 Выживаемость пассажиров в зависимости от наличия записи о возрасте и пола.
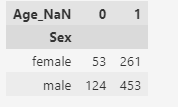 зависимость от наличия записи о возрасте и пола.
У 53 женщин нет записи о возрасте. Из 53 женщин выжило 68% (36 женщин), погибло 32% (17 женщин). Всего женщин было — 314 (в данном наборе данных).
У 124 мужчин нет записи о возрасте. Из 124 мужчин выжило 13% (16 мужчин), погибло 87% (108 мужчин). Всего мужчин было — 577 (в данном наборе данных)
Пассажиров было много в 3 классе и много погибло. Пассажиры — мужчины, у которых был более дешевый билет и более низкий класс — имели меньше шансов выжить.
Т.к. среди пассажиров, у которых значение возраста отсутствовало, были выжившие (около 30%) и погибшие (около 70%), и пассажиры были с разных классов( из 3 класса было значительно больше), и среди пассажиров были мужчины и женщины (мужчин было значительно больше), то при опросе у выживших и при осмотре тел погибших могли случайно пропустить возраст пассажира.
Следовательно делаем вывод, что возраст случайно не занесли.
Решение: Пропущенные значения заполнить средним значением.
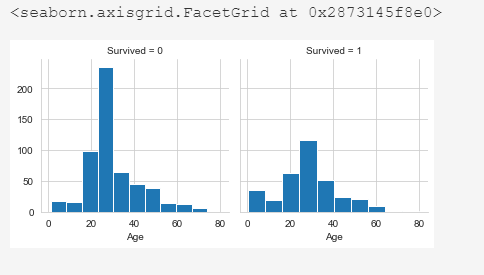
график выживаемости пассажиров в зависимости от возраста
Посмотрим на график выживаемости пассажиров в зависимости от класса и возраста
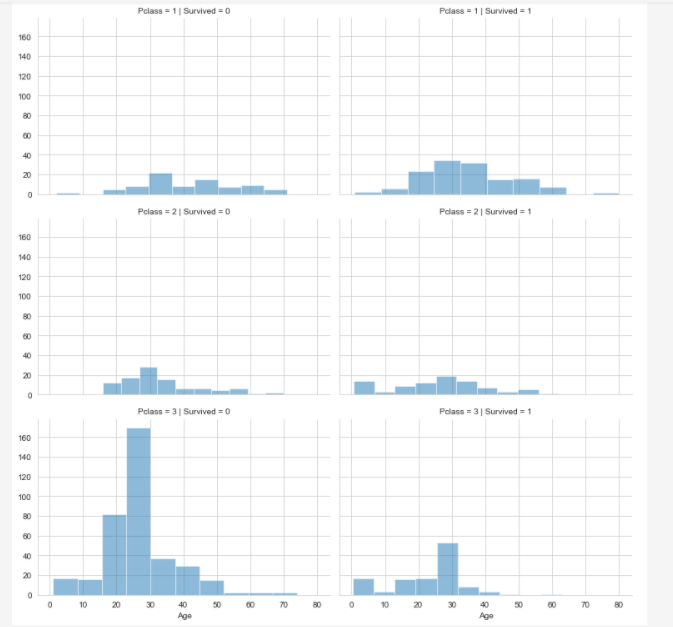
график выживаемости пассажиров в зависимости от класса и возраста
В колонке каюта ( ‘Cabin’) не указано 687 значений. Т. к. пропущенных значений много, можно удалить полностью колонку ‘Cabin’, а можно и оставить отсутствующие данные как — отсутствующие данные. Здесь важно понять: — Существует ли какая-то систематическая взаимосвязь между выживанием и тем, была ли у пассажира отдельная каюта.Для группировки используем метод groupby().
True — отсутствует упоминание о каюте
False — значение заполнено
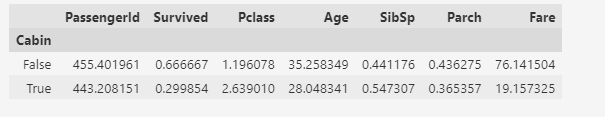
метод groupby(). True — отсутствует упоминание о каюте, False — значение заполнено
Те, пассажиры у кого запись отсутствует — выжили около 30%. А у кого запись о наличии каюты есть — выжило 67%.
Вывод: Есть взаимосвязь между выживанием и наличием каюты.
Создать новую колонку ‘Cabin_available’ (бинарный классификатор).Используем метод where(), где прописываем условие: — Если значение в колонке ‘Cabin’ отсутствует, то присваиваем в колонке ‘Cabin_available’ — значение 0, если присутствует, то 1.

показывает первые 6 строк фрейма данных с новой колонкой ‘Cabin_available’
Выживаемость пассажиров в зависимости от наличия записи о каюте:
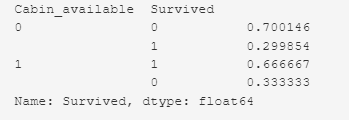 Выживаемость пассажиров в зависимости от наличия записи о каюте
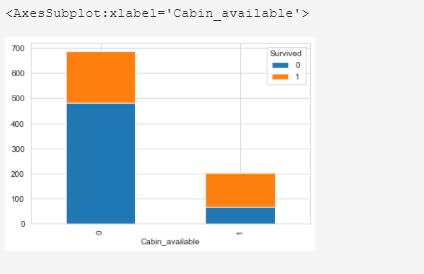 График выживаемости пассажиров в зависимости от наличия записи о каюте
Теперь колонку ‘Cabin’ можно удалить.
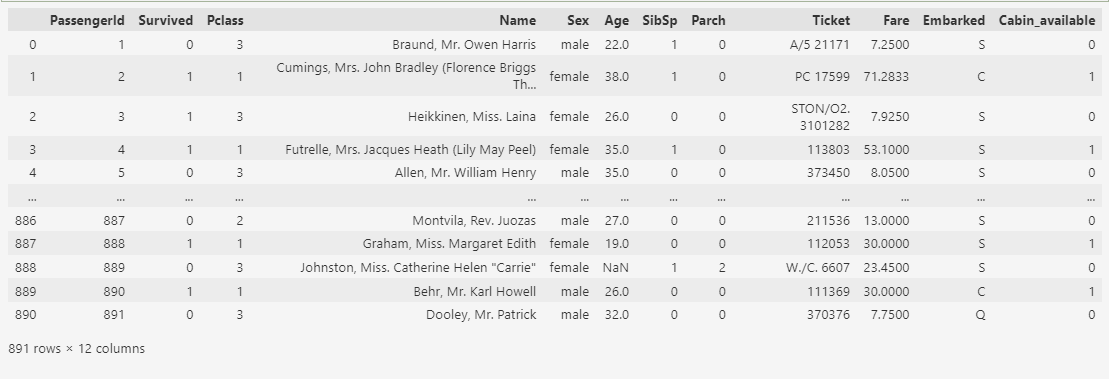
фрейм данных без колонки ‘Cabin’
В колонке порт посадки на борт (‘Embarked’) не указано два значения. Это категориальный признак.
Решение: Заменить пропущенные значения по частоте. Заменить отсутствующее значение значением, которым чаще всего встречается в конкретном столбце.
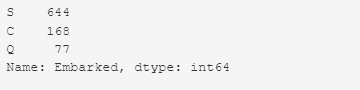
подсчет значений в колонке ‘Embarked’
Чаще всего встречается значение S — 644. Нужно заменить пропущенные значения на S.
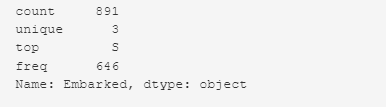
метод describe() для колонки ‘Embarked’, после замены пропущенных значений.
Good! Now, we have a dataset with no missing values. (Хорошо! Теперь у нас есть набор данных без пропущенных значений.)
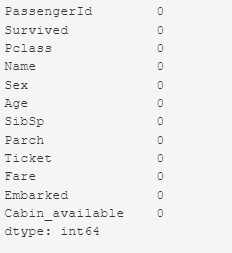 набор данных без пропущенных значений
pandas.DataFrame.value_counts#
Return a Series containing the frequency of each distinct row in the Dataframe.
Parameters : subset label or list of labels, optional
Columns to use when counting unique combinations.
normalize bool, default False
Return proportions rather than frequencies.
sort bool, default True
Sort by frequencies when True. Sort by DataFrame column values when False.
ascending bool, default False
Sort in ascending order.
dropna bool, default True
Don’t include counts of rows that contain NA values.
New in version 1.3.0.
Equivalent method on Series.
The returned Series will have a MultiIndex with one level per input column but an Index (non-multi) for a single label. By default, rows that contain any NA values are omitted from the result. By default, the resulting Series will be in descending order so that the first element is the most frequently-occurring row.