Метод аппроксимации в Microsoft Excel
Среди различных методов прогнозирования нельзя не выделить аппроксимацию. С её помощью можно производить приблизительные подсчеты и вычислять планируемые показатели, путем замены исходных объектов на более простые. В Экселе тоже существует возможность использования данного метода для прогнозирования и анализа. Давайте рассмотрим, как этот метод можно применить в указанной программе встроенными инструментами.
Выполнение аппроксимации
Наименование данного метода происходит от латинского слова proxima – «ближайшая» Именно приближение путем упрощения и сглаживания известных показателей, выстраивание их в тенденцию и является его основой. Но данный метод можно использовать не только для прогнозирования, но и для исследования уже имеющихся результатов. Ведь аппроксимация является, по сути, упрощением исходных данных, а упрощенный вариант исследовать легче.
Главный инструмент, с помощью которого проводится сглаживания в Excel – это построение линии тренда. Суть состоит в том, что на основе уже имеющихся показателей достраивается график функции на будущие периоды. Основное предназначение линии тренда, как не трудно догадаться, это составление прогнозов или выявление общей тенденции.
Но она может быть построена с применением одного из пяти видов аппроксимации:
- Линейной;
- Экспоненциальной;
- Логарифмической;
- Полиномиальной;
- Степенной.
Рассмотрим каждый из вариантов более подробно в отдельности.
Способ 1: линейное сглаживание
Прежде всего, давайте рассмотрим самый простой вариант аппроксимации, а именно с помощью линейной функции. На нем мы остановимся подробнее всего, так как изложим общие моменты характерные и для других способов, а именно построение графика и некоторые другие нюансы, на которых при рассмотрении последующих вариантов уже останавливаться не будем.
Прежде всего, построим график, на основании которого будем проводить процедуру сглаживания. Для построения графика возьмем таблицу, в которой помесячно указана себестоимость единицы продукции, производимой предприятием, и соответствующая прибыль в данном периоде. Графическая функция, которую мы построим, будет отображать зависимость увеличения прибыли от уменьшения себестоимости продукции.
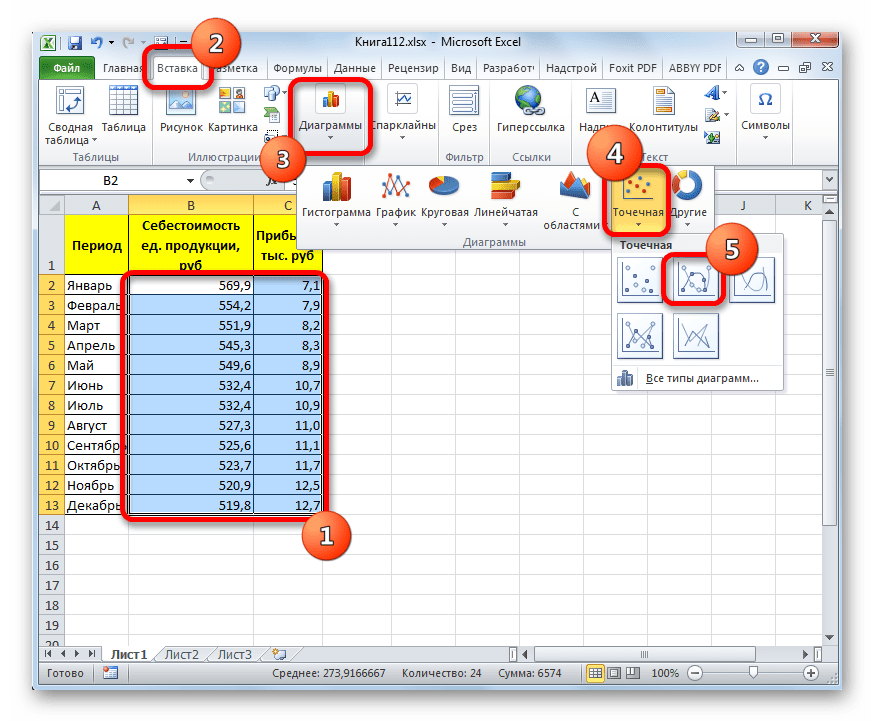
- Для построения графика, прежде всего, выделяем столбцы «Себестоимость единицы продукции» и «Прибыль». После этого перемещаемся во вкладку «Вставка». Далее на ленте в блоке инструментов «Диаграммы» щелкаем по кнопке «Точечная». В открывшемся списке выбираем наименование «Точечная с гладкими кривыми и маркерами». Именно данный вид диаграмм наиболее подходит для работы с линией тренда, а значит, и для применения метода аппроксимации в Excel.
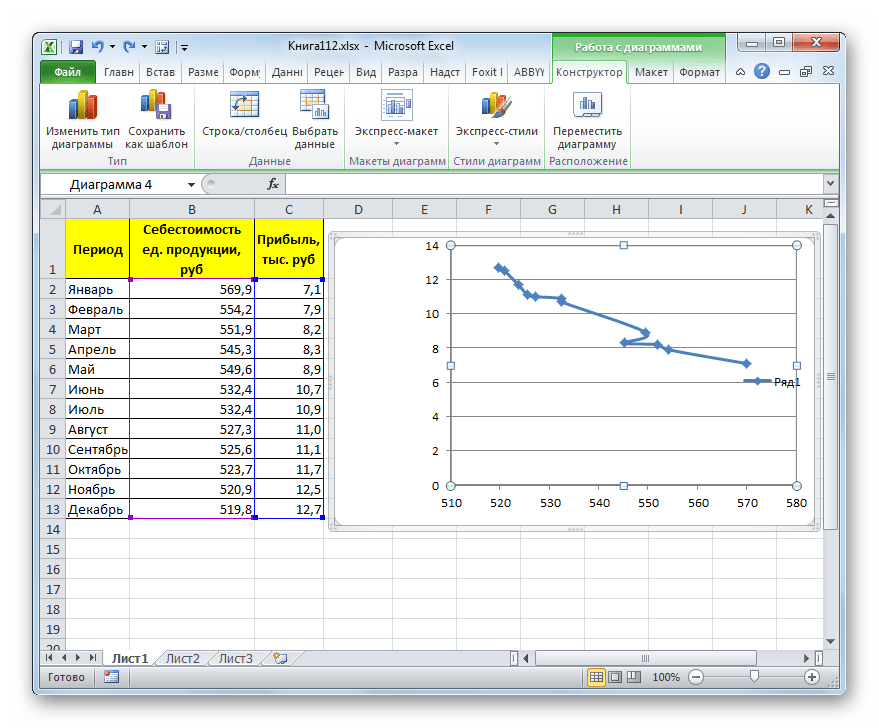
- График построен.
В блоке параметров «Построение линии тренда (аппроксимация и сглаживание)» устанавливаем переключатель в позицию «Линейная».
При желании можно установить галочку около позиции «Показывать уравнение на диаграмме». После этого на диаграмме будет отображаться уравнение сглаживающей функции.
Также в нашем случае для сравнения различных вариантов аппроксимации важно установить галочку около пункта «Поместить на диаграмму величину достоверной аппроксимации (R^2)». Данный показатель может варьироваться от 0 до 1. Чем он выше, тем аппроксимация качественнее (достовернее). Считается, что при величине данного показателя 0,85 и выше сглаживание можно считать достоверным, а если показатель ниже, то – нет.
Сглаживание, которое используется в данном случае, описывается следующей формулой:
В конкретно нашем случае формула принимает такой вид:
Величина достоверности аппроксимации у нас равна 0,9418, что является довольно приемлемым итогом, характеризующим сглаживание, как достоверное.
Способ 2: экспоненциальная аппроксимация
Теперь давайте рассмотрим экспоненциальный тип аппроксимации в Эксель.
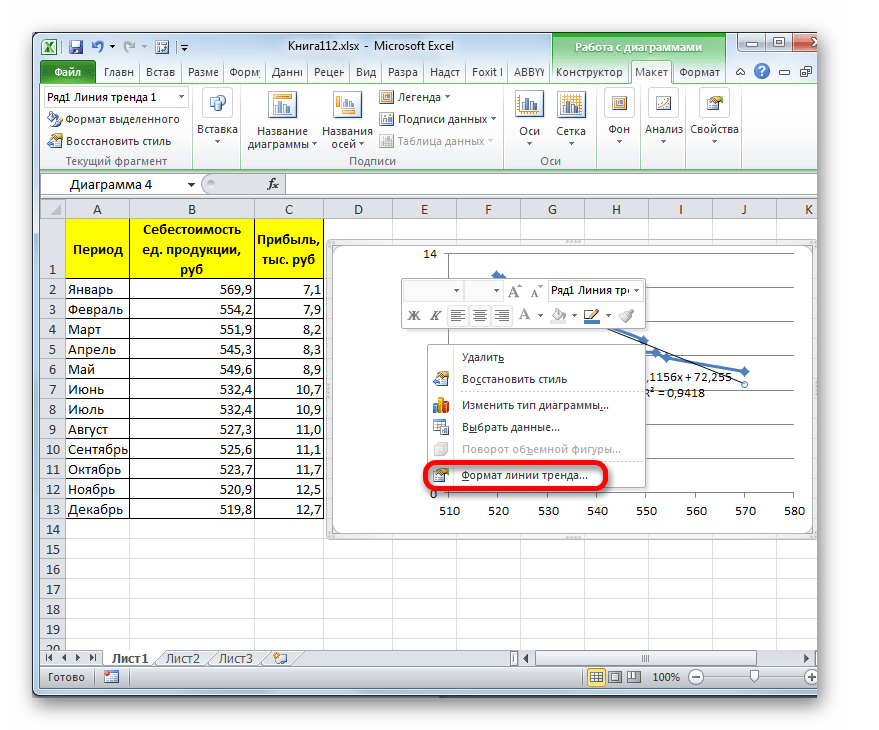
- Для того, чтобы изменить тип линии тренда, выделяем её кликом правой кнопки мыши и в раскрывшемся меню выбираем пункт «Формат линии тренда…».
- После этого запускается уже знакомое нам окно формата. В блоке выбора типа аппроксимации устанавливаем переключатель в положение «Экспоненциальная». Остальные настройки оставим такими же, как и в первом случае. Щелкаем по кнопке «Закрыть».
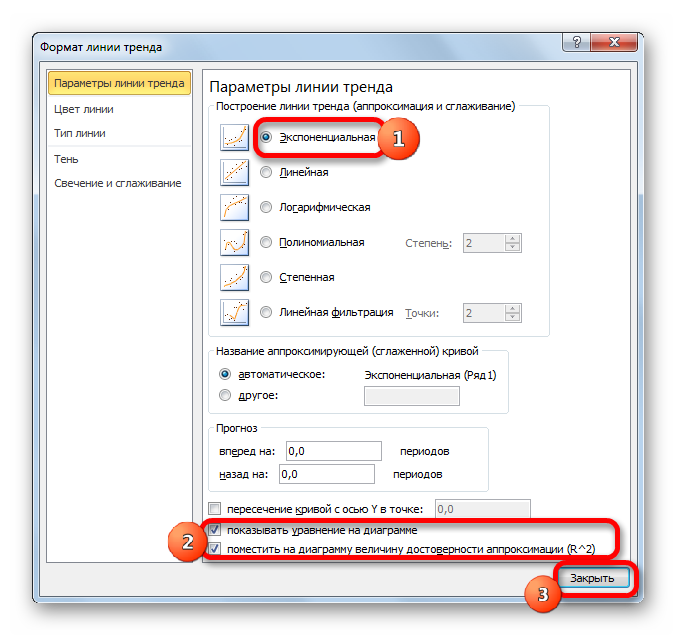
- После этого линия тренда будет построена на графике. Как видим, при использовании данного метода она имеет несколько изогнутую форму. При этом уровень достоверности равен 0,9592, что выше, чем при использовании линейной аппроксимации. Экспоненциальный метод лучше всего использовать в том случае, когда сначала значения быстро изменяются, а потом принимают сбалансированную форму.
Общий вид функции сглаживания при этом такой:
где e – это основание натурального логарифма.
В конкретно нашем случае формула приняла следующую форму:
Способ 3: логарифмическое сглаживание
Теперь настала очередь рассмотреть метод логарифмической аппроксимации.
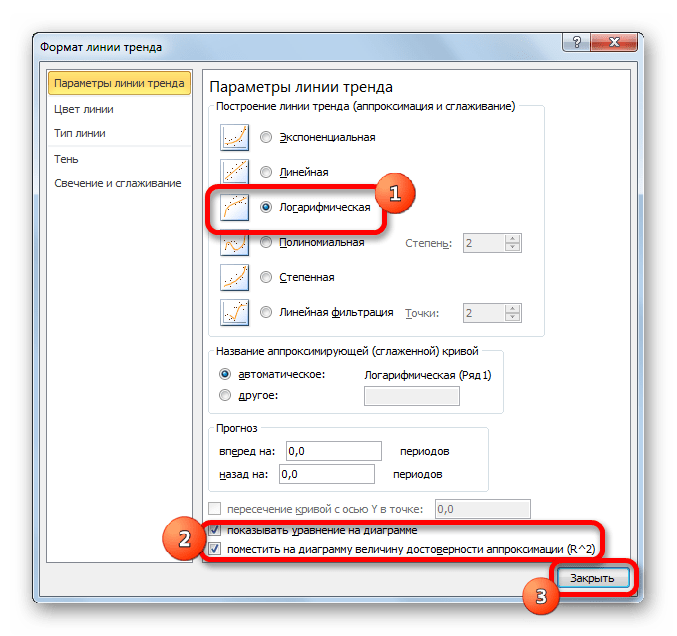
- Тем же способом, что и в предыдущий раз через контекстное меню запускаем окно формата линии тренда. Устанавливаем переключатель в позицию «Логарифмическая» и жмем на кнопку «Закрыть».
- Происходит процедура построения линии тренда с логарифмической аппроксимацией. Как и в предыдущем случае, такой вариант лучше использовать тогда, когда изначально данные быстро изменяются, а потом принимают сбалансированный вид. Как видим, уровень достоверности равен 0,946. Это выше, чем при использовании линейного метода, но ниже, чем качество линии тренда при экспоненциальном сглаживании.
В общем виде формула сглаживания выглядит так:
где ln – это величина натурального логарифма. Отсюда и наименование метода.
В нашем случае формула принимает следующий вид:
Способ 4: полиномиальное сглаживание
Настал черед рассмотреть метод полиномиального сглаживания.
- Переходим в окно формата линии тренда, как уже делали не раз. В блоке «Построение линии тренда» устанавливаем переключатель в позицию «Полиномиальная». Справа от данного пункта расположено поле «Степень». При выборе значения «Полиномиальная» оно становится активным. Здесь можно указать любое степенное значение от 2 (установлено по умолчанию) до 6. Данный показатель определяет число максимумов и минимумов функции. При установке полинома второй степени описывается только один максимум, а при установке полинома шестой степени может быть описано до пяти максимумов. Для начала оставим настройки по умолчанию, то есть, укажем вторую степень. Остальные настройки оставляем такими же, какими мы выставляли их в предыдущих способах. Жмем на кнопку «Закрыть».
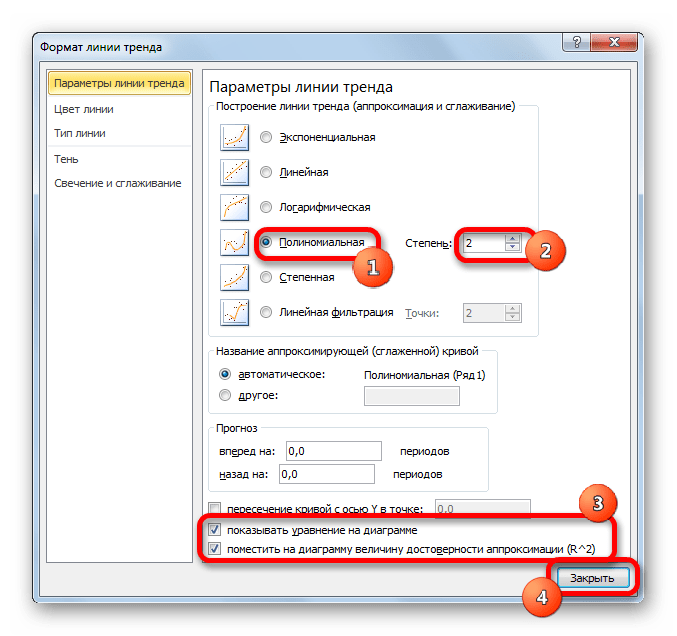
- Линия тренда с использованием данного метода построена. Как видим, она ещё более изогнута, чем при использовании экспоненциальной аппроксимации. Уровень достоверности выше, чем при любом из использованных ранее способов, и составляет 0,9724.
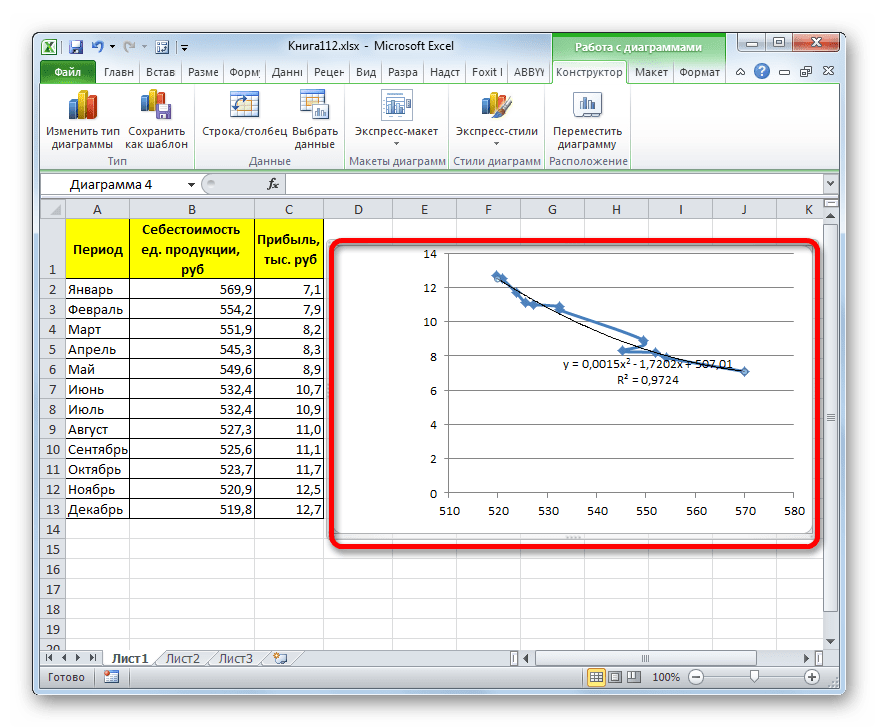
Данный метод наиболее успешно можно применять в том случае, если данные носят постоянно изменчивый характер. Функция, описывающая данный вид сглаживания, выглядит таким образом:
В нашем случае формула приняла такой вид:
Формула, которая описывает данный тип сглаживания, приняла следующий вид:
Способ 5: степенное сглаживание
В завершении рассмотрим метод степенной аппроксимации в Excel.
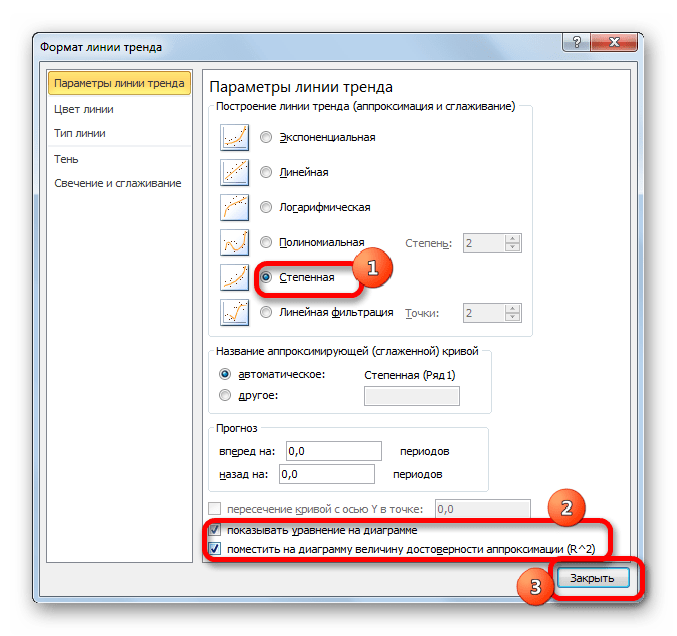
- Перемещаемся в окно «Формат линии тренда». Устанавливаем переключатель вида сглаживания в позицию «Степенная». Показ уравнения и уровня достоверности, как всегда, оставляем включенными. Жмем на кнопку «Закрыть».
- Программа формирует линию тренда. Как видим, в нашем случае она представляет собой линию с небольшим изгибом. Уровень достоверности равен 0,9618, что является довольно высоким показателем. Из всех вышеописанных способов уровень достоверности был выше только при использовании полиномиального метода.
Данный способ эффективно используется в случаях интенсивного изменения данных функции. Важно учесть, что этот вариант применим только при условии, что функция и аргумент не принимают отрицательных или нулевых значений.
Общая формула, описывающая данный метод имеет такой вид:
В конкретно нашем случае она выглядит так:
Как видим, при использовании конкретных данных, которые мы применяли для примера, наибольший уровень достоверности показал метод полиномиальной аппроксимации с полиномом в шестой степени (0,9844), наименьший уровень достоверности у линейного метода (0,9418). Но это совсем не значит, что такая же тенденция будет при использовании других примеров. Нет, уровень эффективности у приведенных выше методов может значительно отличаться, в зависимости от конкретного вида функции, для которой будет строиться линия тренда. Поэтому, если для этой функции выбранный метод наиболее эффективен, то это совсем не означает, что он также будет оптимальным и в другой ситуации.
Если вы пока не можете сразу определить, основываясь на вышеприведенных рекомендациях, какой вид аппроксимации подойдет конкретно в вашем случае, то есть смысл попробовать все методы. После построения линии тренда и просмотра её уровня достоверности можно будет выбрать оптимальный вариант.
Расчет величины достоверности аппроксимации

Для определения величины достоверности аппроксимации используем формулы:

Так как величина достоверности аппроксимации больше 0,9 следовательно, она входит в допустимый предел и можно считать, что мы описали объект с достаточной точностью.
Расчет передаточных функций датчика, преобразователя и исполнительного механизма
Определяем передаточные функции прочих известных частей системы.
Для того чтобы систему можно было считать линейной, будем исходить из того, что эти значения не выходят за предельные в процессе функционирования системы. Для определения коэффициента преобразования можно воспользоваться формулой:

Вместо постоянной времени в передаточную функцию подставляется значение инерционности.
аппроксимация управление передаточный датчик

Для датчика: Кд= =0,017; Тд=2

Для преобразователя: Кпр=; Тпр=0,1

Для исполнительного механизма: Кисп=; Тисп. м. = 0,8
Для объекта: К=68,9; Т=28.62
Если звено более чем в 10 раз менее инерционно, значит можно считать что оно усилительное Т/Тд=28,62/2=14,31>10, поэтому звено считаем усилительным
Wд (р) = =0,017

Т/Тпр=28,62/0,1=286,2>10. поэтому звено считаем усилительным
Wпр (р) ==0,16

Т/Тим=28,62/0,8=35,78>10. поэтому звено считаем усилительным
Wисп. м. (р) ==125

Датчик, преобразователь и исполнительный механизм в данной работе можно считать усилительными звеньями.
Расчет передаточной функции эквивалентного объекта управления, представляющего собой последовательное соединение всех известных звеньев системы
Передаточную функцию эквивалентного объекта получим, используя правила последовательного соединения звеньев, согласно которым передаточная функция представляет собой произведение передаточных функций всех соединенных звеньев.
Передаточная функция эквивалентного объекта управления будет равна:

Получили звено 3 порядка. Для упрощения вычислений отбрасываем члены с наименьшей инерционностью (0.5p+1). Получаем звено 2 порядка.
Расчет настроек регуляторов методом расширенных частотных характеристик, используя данные о переходном процессе и типе регулятора

Определение настроек регулятора ведем методом расширенных частотных характеристик пользуясь формулами:

Подставляем числа в формулы. РАЧХ приведена на рисунке 2, РФЧХ — на рисунке 3.

Рис. 2 Расширенная амплитудная характеристика


Рис. 3 Расширенная фазово-частотная характеристика
После получения формул для расширенных частотных характеристик мы переходим к определению настроек регулятора. Для этого необходимо построить на плоскости настроек кривую равной степени колебательности m. Для построения кривой используются формулы:


величина, обратная постоянной времени регулятора.


коэффициент преобразования регулятора.
Кривая представлена на рис.4.

Рис. 4 Кривая равной степени колебательности m=0,366

После построения кривой на плоскости настроек, находим точку S0=max и значение частоты, соответствующее этой точке. По методу расширенных частотных характеристик = 0,143. Результаты расчетов П, И, ПИ, ПИД-регуляторов в приведены в таблице 1:
Корреляция и регрессия
Когда вы исследуете закономерности в своих данных, как вы можете определить, насколько тесно связаны между собой две переменные? Можете ли вы использовать одну переменную для предсказания другой?
В этом модуле вы познакомитесь с концепциями корреляции и регрессии, которые могут помочь вам в дальнейшем изучении, понимании и обмене данными.
Цели
По завершении этого модуля вы сможете:
- Различать сильную и слабую корреляцию.
- Различать характеристики корреляции и линейной регрессии.
Раздел 1. Корреляция
В этом модуле вы познакомитесь с двумя концепциями, которые помогут вам в изучении взаимосвязей между переменными: корреляция и регрессия. Начнем с корреляции.
Что такое корреляция?
Корреляция – это техника, которая может показать, насколько сильно связаны пары количественных переменных. Например, количество ежедневно потребляемых калорий и масса тела взаимосвязаны, но эта связь не абсолютная.
Многие из нас знают кого-то, кто очень худой, несмотря на то, что он/она регулярно потребляет большое количество калорий, и мы также знаем кого-то, у кого есть проблемы с лишним весом, даже когда он/она сидит на диете с пониженным содержанием калорий.
Однако средний вес людей, потребляющих 2000 калорий в день, будет меньшим, чем средний вес людей, потребляющих 2500, а их средний вес будет еще меньше, чем у людей, потребляющих 3000, и так далее.
Корреляция может сказать вам, насколько тесно разница в весе людей связана с количеством потребляемых калорий.
Корреляция между весом и потреблением калорий – это простой пример, но иногда данные, с которыми вы работаете, могут содержать корреляции, которых вы никак не ожидаете. А иногда вы можете подозревать корреляции, не зная, какие из них самые сильные. Корреляционный анализ помогает лучше понять связи в ваших данных.
Диаграммы разброса или Точечные диаграммы используются для графического представления взаимосвязей между количественными показателями. Диаграмма показывает данные и позволяет нам проверить свои предположения, прежде чем устанавливать корреляции. Глядя на взаимосвязь между продажами и маркетингом, можно предположить наличие в них корреляции. По мере того, как одна переменная растет, другая, похоже, тоже увеличивается.
Диаграмма, указывающая на корреляцию между двумя количественными переменными
Корреляция против причинно-следственной связи
Теперь вы знаете, как определяется корреляция и как ее можно представить графически. Теперь давайте посмотрим, как понимать корреляцию.
Во-первых, важно понимать, что корреляция никогда не доказывает наличие причинно-следственной связи.
Корреляция говорит нам только о том, насколько сильно пара количественных переменных линейно связана. Она не объясняет, как и почему.
Например, продажи кондиционеров коррелируют с продажами солнцезащитных кремов. Люди покупают кондиционеры, потому что они купили солнцезащитный крем, или наоборот? Нет. Причина обеих покупок явно в чем-то другом, в данном случае – в жаркой погоде.
Измерение корреляции
Корреляция Пирсона, также называемая коэффициентом корреляции, используется для измерения силы и направления (положительного или отрицательного) линейной связи между двумя количественными переменными. Когда корреляция измеряется в выборке данных, используется буква r. Критерий Пирсона r может находиться в диапазоне от –1 до 1.
Когда r = 1, существует идеальная положительная линейная связь между переменными, это означает, что обе переменные идеально коррелируют с увеличением значений. Когда r = –1, существует идеальная отрицательная линейная связь между переменными, это означает, что обе переменные идеально коррелируют при уменьшении значений. Когда r = 0, линейная связь между переменными не наблюдается.
На графиках разброса ниже показаны корреляции, где r = 1, r = –1 и r = 0.
Переверните каждую карту ниже, чтобы увидеть значение для этой совокупности.
Идеальная положительная корреляция
Когда r = 1, есть идеальная положительная линейная связь между переменными, и это означает, что обе переменные идеально коррелируют с увеличением значений.
Идеальная отрицательная корреляция
Когда r = –1, существует идеальная отрицательная линейная связь между переменными, и это означает, что обе переменные идеально коррелируют при уменьшении значений.
Нет линейной корреляции
Когда r = 0, линейная зависимость между переменными не наблюдается.
С реальными данными вы никогда не увидите значений r «–1», «0» или «1».
Как правило, чем ближе r к 1 или –1, тем сильнее корреляция, это показано в следующей таблице.
r =
Сила корреляции
От 0.90 до 1
или
от -0.90 до -1
Очень сильная корреляция
От 0.70 до 0.89
или
от -0.70 до -0.89
От 0.40 до 0.69
или
от -0.40 или -0.69
От 0.20 до 0.39
или
от -0.20 до -0.39
От 0 to 0.19
до
от 0 до -0.19
Очень слабая корреляция или ее нет вообще
Условие корреляции
Чтобы корреляции были значимыми, они должны использовать количественные переменные, и описывать линейные отношения, при этом не может быть выбросов.
В 1973 году статистик по имени Фрэнсис Анскомб разработал показатель «квартет Анскомба», он показывает важность визуального представления данных в виде графиков, а не простого выполнения статистических тестов.
Выделенный график разброса в верхнем левом углу – единственный, который удовлетворяет условиям корреляции.
Четыре визуализации в его квартете показывают одну и ту же линию тренда, поэтому значение r будет одинаковым для всех четырех.
Что вы заметили? Только один из графиков рассеяния соответствует критериям линейности и отсутствия выбросов.
Другими словами, мы не должны проводить корреляции на трех из четырех примерах, потому что не имеет смысла устанавливать сильные отношения.
Проверка знаний
Силу корреляции при значении r, равному –0,52, лучше всего можно описать как:
- Очень сильная отрицательная корреляция
- Очень сильная положительная корреляция
- Умеренная отрицательная корреляция
- Умеренная положительная корреляция
Резюме
Итак, вы ознакомились с концепциями статистической техники корреляции. На следующем уроке вы узнаете о линейной регрессии.
Раздел 2. Линейная регрессия
На предыдущем уроке вы узнали, что корреляция относится к направлению (положительному или отрицательному) и силе связи (от очень сильной до очень слабой) между двумя количественными переменными.
Линейная регрессия также показывает направление и силу взаимосвязи между двумя числовыми переменными, но регрессия использует наиболее подходящую прямую линию, проходящую через точки на диаграмме рассеяния, чтобы предсказать, как X вызывает изменение Y. При корреляции значения X и Y взаимозаменяемы. При регрессии результаты анализа изменятся, если поменять местами X и Y.
Диаграмма рассеяния с линией регрессии
Линия регрессии
Как и в случае с корреляциями, для того, чтобы регрессии были значимыми, они должны:
- Использовать количественные переменные
- Быть линейными
- Не содержать выбросов
Как и корреляция, линейная регрессия отображается на диаграмме рассеяния
Линия регрессии на диаграмме рассеяния – это наиболее подходящая прямая линия, которая проходит через точки на диаграмме рассеяния. Другими словами, это линия, которая проходит через точки с наименьшим расстоянием от каждой из них до линии (поэтому в некоторых учебниках вы можете встретить название «регрессия наименьших квадратов»).
Почему эта линия так полезна? Мы можем использовать вычисление линейной регрессии для вычисления или прогнозирования нашего значения Y, если у нас есть известное значение X.
Чтобы было понятнее, давайте рассмотрим пример.
Пример регрессии
Представьте, что вы хотите предсказать, сколько вам нужно будет заплатить, чтобы купить дом площадью 1,500 квадратных футов.
Давайте используем для этого линейную регрессию.
- Поместите переменную, которую вы хотите прогнозировать, цену на жилье, на ось Y (зависимая переменная).
- Поместите переменную, на которой вы основываете свои прогнозы, квадратные метры, на ось x (независимая переменная).
Вот диаграмма рассеяния, показывающая цены на жилье (ось Y) и площадь в квадратных футах (ось x).
Вы можете видеть, что дома с большим количеством квадратных футов, как правило, стоят дороже, но сколько именно вам придется потратить на дом размером 1500 квадратных футов?
Диаграмма рассеяния цен на дома и квадратных метров
Чтобы помочь вам ответить на этот вопрос, проведите линию через точки. Это и будет линия регрессии. Линия регрессии поможет вам предсказать, сколько будет стоить типовой дом определенной площади в квадратных метрах. В этом примере вы можете видеть уравнение для линии регрессии.
Уравнение линии регрессии
Уравнение линии регрессии: Y = 113x + 98,653 (с округлением).
Что означает это уравнение? Если вы купили просто место без площади (пустой участок), цена составит 98,653 доллара. Вот как можно решить это уравнение:
Чтобы найти Y, умножьте значение X на 113, а затем добавьте 98,653. В этом случае мы не смотрим на квадратные метры, поэтому значение X равно «0».
- Y = (113 * 0) + 98,653
- Y = 0 + 98,653
- Y = 98,653
Значение 98,653 называется точкой пересечения по оси Y, потому что здесь линия пересекает ось Y. Это – значение Y, когда X равно «0».
Но что такое 113? Число «113» – это наклон линии. Наклон – это число, которое описывает как направление, так и крутизну линии. В этом случае наклон говорит нам, что за каждый квадратный фут цена дома будет расти на 113 долларов.
Итак, сколько вам нужно будет потратить на дом площадью 1500 квадратных футов?
Y = (113 * 1500) + 98,653 = $268,153
Взгляните еще раз на эту диаграмму рассеяния. Синие отметки – это фактические данные. Вы можете видеть, что у вас есть данные для домов площадью от 1100 до 2450 квадратных футов.
Насколько можно быть уверенным в результате, используя приведенное выше уравнение, чтобы спрогнозировать цену дома площадью в 500 квадратных футов? Насколько можно быть уверенным в результате, используя приведенное выше уравнение, чтобы предсказать цену дома площадью 10,000 квадратных футов?
Поскольку оба этих измерения находятся за пределами диапазона фактических данных, вам следует быть осторожными при прогнозировании этих значений.
Величина достоверности аппроксимации
Наведите курсор на линию регрессии, чтобы увидеть значение величины достоверности аппроксимации r.
В дополнение к уравнению в этом примере мы также видим значение величины достоверности аппроксимации r (также известная как коэффициент детерминации).
Это значение является статистической мерой того, насколько близки данные к линии регрессии или насколько хорошо модель соответствует вашим наблюдениям. Если данные находятся точно на линии, значение величины достоверности аппроксимации будет 1 или 100%, и это означает, что ваша модель идеально подходит (все наблюдаемые точки данных находятся на линии).
Для наших данных о ценах на жилье значение величины достоверности аппроксимации составляет 0,70, или 70%.
Корреляция против причинно-следственной связи
Теперь давайте рассмотрим, как отличить линейную регрессию от корреляции.
Линейная регрессия
- Показывает линейную модель и прогноз, прогнозируя Y из X.
- Использует величину достоверности аппроксимации для измерения процента вариации, которая объясняется моделью.
- Не использует X и Y как взаимозаменяемые значения (поскольку Y предсказывается из X).
Корреляция
- Показывает линейную зависимость между двумя значениями.
- Использует r для измерения силы и направления корреляции.
- Использует X и Y как взаимозаменяемые значения.
Готовы проверить свои знания? В следующем упражнении определите, чему соответствует каждое из описаний: корреляции или регрессии.
Варианты для категорий: «корреляция» или «регрессия».
Измеряется величиной достоверности аппроксимации
Прогнозирует значения Y на основе значений X.
Не предсказывает значения Y из значений X, только показывает взаимосвязь.
Переменные оси X и Y взаимозаменяемы.
Если поменять местами X и Y, результаты анализа изменятся.
Резюме
Итак, здесь вы познакомились со статистическими концепциями корреляции и регрессии. Это поможет вам лучше исследовать и понимать данные, с которыми вы работаете, путем изучения взаимосвязей в них.
Что такое достоверность аппроксимации в excel
Достоверность аппроксимации в Excel — это мера того, насколько точно математическая модель соответствует данным, на которых основывается. Более конкретно, это оценка ошибки аппроксимации или отклонения результата аппроксимации от фактических данных.
При использовании функций аппроксимации в Excel, таких как TREND, FORECAST или LINEST, программа выдает коэффициент корреляции (R-значение), который показывает, насколько сильна связь между аппроксимационной моделью и реальными данными. Чем ближе R к 1 или -1, тем более точным является результат аппроксимации.
Однако между высоким R-значением и достоверностью аппроксимации есть разница. Достоверность аппроксимации также зависит от количества данных, использованных в аппроксимации, и от того, насколько хорошо аппроксимационная функция соответствует реальным данным.
Некоторые полезные советы для улучшения достоверности аппроксимации в Excel:
— Используйте как можно больше данных для аппроксимационной модели
— Выбирайте правильную формулу аппроксимации в зависимости от типа данных (линейная, полиномиальная, экспоненциальная, логарифмическая и т. д.)
— Изучите и оцените результаты аппроксимации на предмет возможных ошибок или несоответствий
— Проверьте модель на других наборах данных, чтобы убедиться в ее сбалансированности и точности.