Как делать русификаторы для игр

| 3,057 | уникальных посетителей |
| 53 | добавили в избранное |
Создание русификатора с нуля — дело трудоемкое и долгое, однако несложное (при достаточном уровне английского), но таким заниматься нет смысла. Все перевели до вас, поэтому серьезно делать полный перевод не надо, ну только если и правда какой-то мод новый. Если вас что-то не устраивает в установленном у вас переводе, можно просто изменить его под себя.
- Использовать созданную для этого программу Mouse&Brain [rusmnb.ru]
- Использовать текстовый редактор (например Notepad++ [notepad-plus-plus.org] ).
Как текстовый редактор он, несомненно, могет. Однако, перевод файлов игры через него очень геморный. Если программа дает вам сразу две строки и с одной вы переводите, а в другую пишете, то через Notepad так не выйдет. Вам придется стирать английскую версию фразы и вписывать вместо нее русскую. Так вы можете прямо на ходу печати забыть/перепутать/пропустить слово и т.д. Ну и еще выделять в нем очень длинные фразы, ♥♥♥♥♥♥♥♥♥♥♥♥, какая трудная задача. Строка не переносится на начало следующей при упоре в край экрана, а бесконечно тянется вправо. Одно случайное движение мышью вверх/вниз и вы выделили полфайла сразу.
Все это знаю по себе. Но тут уж вам решать. Хотите помучаться, значит есть зачем.
Переводить M&B через Notepad, все равно что кодить на стандартном Блокноте.
Лучше всего изменять/переводить не оригинальные файлы, а их копии. Чтобы получить их выполняем следующие действия:
Запускаем игру в оконном режиме. Ставьте галочку "Запускать в окне".
После запуска игры, находясь на глобальной карте, смотрим в верхний левый угол экрана и жмякаем View — Create Language Template — Default
Теперь копии файлов, в которых хранится весь текст игры находятся по пути
Steam Library — steamapps — common — Mount and Blade Warband — new_language
Менять будем именно их, чтобы не накосячить в основных файлах, которые пока еще используются игрой.
После скачивания программы, открываем наши скопированные файлы.
Чтобы сделать полный русификатор с нуля придется перевести и отпечатать вручную весь список файлов на картинке. В некоторых файлах больше двух тысяч строк. Не дай Бог, таким заниматься.
Вот так выглядит открытый в программе текстовый файл. Строка "Оригинальный текст" не редактируется и служит для перевода с нее. Строка "Ваш перевод" соответственно редактируется вами. После ввода вашего перевода в строку не забывайте нажимать "Заменить".
Когда закончите с файлом сохраните его. Можно сохранить его как копию открытого, в любой закоулок памяти ПК, а можно сразу назвать его как оригинал и заменить в той же папке.
Когда вы закончите со всеми файлами, то назовите папку с ними ru и закиньте ее с заменой по пути Steam Library — steamapps — common — Mount and Blade Warband — Modules — тот модуль, который вы меняли — languages
Все, теперь вы можете открывать игру и выбирать русский язык для нужного вам модуля.
Как я уже говорил, переводить всю игру не нужно. Используйте эту программу для того чтобы поправить ошибки в фразах, перевести какую-то забытую строчку и изменить то, что вас раздражает.
К примеру, для себя я изменил манеру речи посредников в тавернах, убрав им немецкий акцент. Еще перевел вступительный отрывок при создании новой игры и исправил несколько опечаток в словах.
Работа непыльная, но способна доставить вам удовольствие на выходе.
Если вас заинтересовали мои гайдики, вы можете увидеть весь их список через менюшку или через обсуждения.
Сейчас я научу тебя переводить игры с одного языка на другой!
Для начала нужно сказать что приведенный мною способ подойдет только для игр на RPG maker (2000; 2003; vx; vx ace; mv; mz и все остальные версии этого движка), Ren Py, Tyrano Builder, и еще пара других (вроде как на юнити можно но я не проверял) Ниже на картинках все варианты:
Для перевода игр нам потребуется программа Translator, ее можно скачать бесплатно с официального сайта:
Запустив программу выбираем — новый проект
Далее выбираем движок нашей игры (его нужно знать, но не обязательно, можете методом тыка программа сама определит движок)
Для перевода игры логично что нам потребуется сама игра — я покажу на примере Flesh blood & concrete (рпг мейкер, я у этой игры официальный переводчик на укр яз). После выбора движка нам нужно выбрать ехе файл игры
Ждем компиляцию проекта
Когда будет готово жмем на кнопку закрыть
Когда закроете у вас будет такое окно — не создавайте джава скрипт файлы, это может игру сломать
Далее мы видим поля (слева) — это разделение по текстовым файлам и проценты — это процесс перевода (не особо нужная штука). Теперь при нажатии на поле у нас появится нужный нам текст.
Этот самый текст можно переводить 2 путями
И второй который я вам рекомендую
для этого нам нужно поставить галочки у тех полей что нам нужно перевести
Далее заходим в настройки:
Тут нам нужно выбрать вкладку language (язык) и выбрать то с какого языка на какой мы будем переводить — у меня это будет с русского на украинский (но можно на любой другой)
После этого сверху экрана нажимаем на кнопку со значком переводчика
У нас появляется окно где можно выбрать с помощью какого онлайн переводчика наш текст будет переведен, также тут указаны колонки 1 — из которой будут взяты слова 2 — куда будет помещен наш перевод(советую всегда выбирать колонку ближе к левой стороне в нашем случае это initial, потом расскажу почему).
После этого жмем на кнопку перевести.
Как вы видите наш текст перевелся, но в нем есть ошибки (род не тот):
Это уже придется исправлять в ручную, однако у различных онлайн переводчиков может быть разный результат, к примеру я использую гугл транслейтор, но также хорош и бинг (в нем вроде как нейросеть прикручена) и вроде бы я наслышан что яндекс переводчик хорош (я не уверен — он в моей стране не доступен).
Для ручного исправления просто кликаем на наш текст снизу и дописываем буквы.
Чтобы наш перевод был внедрен в игру жмем на иконку шприца
выбираем папку и жмем применить перевод — у вас создастся папка с переведенной игрой
Ну и запустив екзешник мы видим что игра переведена
Вот так и можно перевести игру.
НО ЧТО ДЕЛАТЬ если у вас вот такая ситуация?
У вас не одна строка с переводом а несколько — какой перевод будет применен при создании игры?
Ответ — самый правый, именно поэтому я рекомендую засовывать ваши переводы в левые столбцы (главное оригинальный текст не удалите каким то образом)
Можете ролик глянуть где я рассказывал как эту игру переводил — мне будет приятно!
Вот бы диско Элизиум так перевели
Я бы посмотрела на это
А на чем он сделан?
Так там есть русский язык
А в чём проблема? Несмотря на всю "сложность" текста ничего высоко-художественного в нём нет и даже тупой подстрочник не исправил бы впечатления от игры.
Ну все.
Пошел ставить МТЛ на все порнушные рпг мейкер игры с японским языком
Что за игра, срочно нужно название для друга
очень хорошая именно вот эта игра, и цель тоже хорошая
Если что, помоему на эту игру есть русик, но не уверен
Проще MTool поставить
Для перевода с английского посоветую DeepL, но в него надо вручную текст вставлять.
С автопереводом в проге-переводчике надо быть осторожным, т.к. он переводит всё, включая функции, ссылки, скрипты и т.д. Типа написано в реплике что-нибудь формата: "<NAME>, держи свои <Apple> в количестве <N>" и вот он всё это так и фигачит "<ИМЯ>, держи свои <Яблоки> в количестве <Н>" и у тебя либо выходит такой вот переведённый текст, либо вообще с ошибкой игра вылетает. Особенно когда видишь, что он перевёл, например ссылку к фону или к музыке формата "game\background\summer.png" или "game\background\club.mp3" в "игра\фон\лето.png" и "игра\фон\клуб.mp3". Это гарантированные потом проблемы, в т.ч. частенько в ренпай новеллах с ру-переводом из-за этого краши и непроходимые участки.
Удивлён что еще нет НОРМАЛЬНОЙ программы, которую как оверлей можно было бы вешать поверх игр, отмечая зону субтитров, и чтобы она в своём оверлее выводила перевод наэкранного текста любой игры, переводя через нейронку.
Видел какую-то кривую-косую кажется китайскую поделку, которая запердела когда я хотел её запустить в Halo MCC, и на этом всё.
Есть, почему? Я обычно «ёлку» юзал, но есть и более навороченные варианты. https://perevod-teksta-s-ekrana.blogspot.com
Хотя в последнее время я обленился и юзаю фотоперевод в яндексе с телефона в тех случаях, когда чего-то не понимаю 🙂
Всего-то:
1. Снимать видео с экрана;
2. На кадрах распознавать и переводить текст;
3. Выводить результат в оверлее на том же месте (в идеале по примеру живого перевода яндекс/гугл);
Тоже об этом думал и всё что придумал,это эмулировать гугл переводчик на пк, который будет через эмуль камеры видеть экран. В теории должно быть норм, но там проблема в том что текст сливается вместе, хотя это разные предложения.
Есть. Например, для игр на Юнити это:
BepInEx / XUnity Auto Translator
Даже отмечать ничего не надо, будет переводить весь текст на экране как Яндекс Переводчик на фото. Если будут ошибки, можно вручную поправлять перевод и включать отображение оригинала, чтобы сравнить.
https://youtu.be/_RbqjpXDPfw?t=234
Согласен, такой программы, чтобы поставил и всё работало, как ты описал, очень не хватает. Даже платной.
Из знакомых мне программ, такое умеет только Universal Game Translator, но там нужен Google Api. Чтобы в России с ним работать, надо пройти через 9 кругов ада, так что затестить у меня не получилось.
И VNR, у меня статья на тему есть, можешь читануть. Но я на своём опыте скажу, что для такого эту прогу не очень удобно использовать, ибо тессаракт там старенький, распознавание символов посасывает.
А так советую ёлочку, её старшего брата маверика и capture2text. Пиши через AutoHotkey макрос на скан с некоторой переодичностью и будет тебе счастье (да, костыль, но других вариантов особо и нет). Макросы научиться делать не так сложно, я осилил за часик другой, как сделать себе по нажатию одной кнопки геймпада скан текста, копирование распознанного и вставление в DeepL. Сейчас за тебя это может сделать ChatGPT, кстати, я проверял. В плане макрос написать, если что.
Как создать свой русификатор?
У Вас никогда не возникало желания создать русификатор? Нет? А вот у меня как-то раз возникло такое желание, правда до конца я так ничего не русифицировал. Но смысл я понял хорошо, поэтому хотел бы ознакомить Вас с ним. Вдруг кому-нибудь пригодится в жизни .
Итак, для русифицирования нам понадобится совсем немного, а именно:
1.Rescourse-хаковская прога. (я использую Restorator 2004).
2.Собственно то, что Вам нужно русифицировать.
3.Немного терпения.
Насчёт первого пункта. Rescourse-хаковская программа — это прога, которая умеет пробираться внутрь самого файла .exe, где зачастую хранятся все иконки и тексты. Теперь я надеюсь Вы поняли, зачем она нам нужна. Теперь о выборе. Таких программ много, но я остановил свой выбор именно на Restorator ( Скачать). Простой интерфейс, несколько функций, которых я не видел в других программах аналогичного назначения. Но есть и недостатки. Во-перывых, это размер, который составляет 3,5Mb. Впринципе это немного, но по сравнению опять же с аналогами – это много. За дополнительные возможности надо платить (в данном случае трафиком ). Также Restorаtor является платной программой. Скачать можно лишь Trial-версию, которая работает всего 10 дней, но никто не запрещает нам переводить компьютерные часы назад, поэтому этот недостаток не столь важный (тем более есть ключики, см. конец статьи).
Стоит сразу сказать, что не каждую программу можно перевести таким способом. На некоторых программах стоит защита (Download Master, CBId), из-за которой внутрь файла пролезть нельзя. В других можно, но после русификации они отказываются запускаться (CPU-Z). А, например, в браузере Opera (да и не только) совсем другой алгоритм русификации. Там нужно писать специальные файлы-переводы (.lng), что совсем не сложно. Главное знать язык, с которого переводишь. Но что-то я отклонился от темы. Пожалуй, начнём. Я буду экспериментировать над простенькой прогой для редактирования БИОСов ATI Bios Edit.

Как видите, всё на английском языке. Теперь открываем Restorator (или что Вы там выбрали), и уже в Рестораторе открываем exe.файл программы, перевод которой Вы хотите сделать (File>Open>. ). И видим такую картину:

Итак, мы в файле! В Ati Bios Edit в каталоге “Dialog” хранятся все окна, которые вообще есть в программе.

Займёмся переводом главного окна. Но сразу встаёт вопрос – как? Ведь мы видим только окошко с надписями, которые изменить не можем! Ответ прост – видите на скриншоте выноску? Нажмите на кнопочку RC Display Mode (от которой идёт прямая). Теперь Вы переключились в новый режим.

Как можно заметить на этом скрине, все слова, которые требуется перевести, находятся здесь. Но вот незадача, и здесь ничего нельзя изменить! Да, здесь нельзя, но можно вытащить файл из редактора, и уже в Блокноте править всё что нужно. Жмём в левой части правой кнопкой мыши по подкаталогу, в котором находятся нужные слова (в моём случае это 102 см. скрин выше). Там жмём Exreact>Extrarct as. Вуаля, и на Вашем рабочем столе появился файл 102.rc. Открыть этот файл можно с помощью Блокнота. После того, как Вы поправите файл, сохраните его. Теперь необходимо опять засунуть его в редактор. Для этого опять давим правой кнопкой по подкаталогу 102, жмём Assign>Assign to и указываем путь к файлу, который Вы только что правили в Блокноте.


Результат, как говорится, налицо. Вот и весь способ русификации. Я думаю смысл Вы поняли, и теперь будете разбираться сами, по ситуации. Ведь в любой другой программе каталоги будет построены немного по-другому, например так (ATI Tray Tools):

Здесь нет никаких окошек, здесь можно сразу вытаскивать файл, править его и засовывать обратно (я уверен, что Ray Adams будет рад переводу АТТ на русский язык ).
Ну вот собственно и всё. Как я уже сказал, не все программы можно русифицировать таким способом, но большинство (причём важное большинство) всё же поддаётся (WinAmp, ATT,SpeedFan, DivX. ). Вы, наверное, обратили внимание, что можно не только перевести текст, но и заменить иконки, шрифты, размеры окна и т.д. Вообщем Rescousre-редакторы дают много возможностей. С помощью них можно даже создавать темы для Windows XP. Пользуйтесь и экспериментируйте!
Любительский перевод игр: анатомия процесса, часть первая
 Любительская локализация — явление, затронувшее многих игроманов, и порой даже сыгравшее не последнюю роль в формировании их интересов и отношения к игровой индустрии в целом. Наверное, благодаря тому, что оно издавна преследовало в основном благие цели, у большинства любителей интерактивных развлечений при его упоминании возникают преимущественно положительные ассоциации, а порой даже и ностальгические эмоции.
В прошлый раз я излагал свой взгляд на явления как любительской, так и официальной локализации. Поскольку нашлись люди, которым эта тема близка или интересна, а также не обошлось и без желающих побольше узнать о технических деталях процесса, то мне ничего не остаётся, как об этом рассказать, пусть и в несколько специфичном стиле.
На картинке изображён логотип российского ромхакинг-сообщества по версии проекта Russian Romhacking.
Перед прочтением
Прежде всего, хочу сказать, что я обозреваю только тот опыт, который я имел возможность наблюдать или практиковать лично. Так что далеко не факт, что все неофициальные локализаторы придерживались описанных ниже методик и уж тем более это касается упомянутого инструментария. В первую очередь я буду рассказывать о подходе, который применял сам. Я считаю, что он в достаточной степени показателен и выигрывает у многих других методик, практикуемых иными энтузиастами. Впрочем, понятие методики тут довольно расплывчато и у многих оная отсутствует вовсе.
На всякий случай упомяну и о том, что мои действия, на которых основывается весь описанный опыт, никогда не преследовали корыстных целей и не носили деструктивный характер. Всё это делалось, в первую очередь, ради самого процесса и саморазвития, и было просто моим хобби.
Честно говоря, я долго думал, как именно структурировать статью и что именно в неё включить — сперва я хотел рассказать не только о технических особенностях процесса, но и расписать суть социальной составляющей. Однако, в какой-то момент я поймал себя на мысли, что из-за обилия критики статья пригодна скорей для несколько другого места, нежели для Хабра — корить большинство непрофессионалов за проявление непрофессионализма и отсутствие стремления к совершенствованию техник несколько цинично.
В итоге я решил описать только техническую часть и только в общем виде — подробного описания с примерами хватило бы на десяток таких статей, а то и на очередную бесполезную книгу, так что пока отложим это в долгий ящик. Несмотря на это, статья даже в незавершённом виде получилась довольно большая, и я решил разбить её на несколько постов. Насколько она вышла интересной или полезной — судить вам.
Техническая сторона вопроса
- Обратная разработка — процесс, многим более известный под термином реверс-инжиниринг. Игру исследуют, разбирают форматы, определяют алгоритмы, находят нужные данные.
- Извлечение ресурсов — преобразование необходимых для перевода ресурсов в удобный для редактирования вид. Текст — в текстовые файлы, графику — в распространённые форматы изображений и т.п. Всё это может осуществляться как вручную (неисповедимы пути дилетантские), так и посредством инструментария — в лучшем случае написанного самими переводчиками.
- Перевод и редактирование — самая суть процесса. Результат именно этих трудов оценивают игроки.
- Сборка перевода — конвертирование ресурсов обратно в игровые форматы и замена ими оригинальных данных игры. В идеале этот процесс должен заключаться только лишь в запуске инструментария для автоматической сборки, но, к сожалению, у большинства переводчиков он заключается в ручном редактировании каждый раз при необходимости внести изменения.
- Тестирование — обязательный этап, позволяющий выявить многие ошибки и порой улучшить перевод. Среди вожделеющих поиграться в любимую игру на родном языке отбираются наиболее ответственные и грамотные, затем им вручается бета-версия перевода с просьбой воспроизвести как можно больше игровых ситуаций. Да и свежий взгляд со стороны — всегда хорошо, многие ошибки команда может просто не видеть.
Если углубляться в детали, то не существует одинаковой для всех случаев последовательности действий, которую необходимо выполнить, чтобы подготовить игру к переводу. Так же не существует универсальных методов, с помощью которых можно выполнить те или иные шаги. По сути это всегда импровизация, но всё же есть список задач, которые встречаются практически всегда.
Я постараюсь выделить наиболее часто возникающие и важные задачи, рассказав про каждую из них отдельно. В качестве платформы не будем рассматривать ничего конкретного — т.е. всё описанное ниже справедливо как для PC, так и для любой другой платформы — будь то любая из PlayStation, XBOX, да хоть Sega или Dendy (NES).
Поскольку в данном контексте большинство задач по реверс-инжинирингу можно решить средствами отладчика или дизассемблера, я буду упоминать о них только в отдельных случаях.
Определение кодировки текста
 Казалось бы, вполне тривиальная задача — определить, в какой кодировке хранится текст. И в большинстве случаев это и правда не составляет труда, но и здесь мысль разработчиков не знает предела.
Далеко не всегда выводимый текст хранится именно как текст, чаще это просто набор индексов символов в шрифте, которые необходимо отобразить. Нередко их делают совместимыми или частично совместимыми с какой-либо кодировкой, преимущественно это первые 256 символов юникода. Как бы там ни было, всё равно надо установить точное соответствие между символами и их кодами. Впрочем, в современных играх всё чаще вместо индексов используют обыкновенные кодировки и сериализуют текст в форматы вроде XML — о производительности давно никто особо не задумывается.
Для представления кодировки используются «таблицы кодировки» — текстовые файлы, где в каждой строке некой последовательности байт сопоставлена определённая последовательность символов. Выглядит это примерно так:
Например, текст «Hero obtains Item!» был бы закодирован следующим образом: « 1E 20 20 6F 62 74 61 69 6E 73 20 1E 21 21 ». Однако, если оказывается, что полученная кодировка в достаточной мере совместима с какой-либо пригодной для использования кодировкой (скажем, с юникодом), то таблица в общем-то не нужна и этот шаг можно пропустить.
Самым распространённым способом определить кодировку и найти текст является так называемый «относительный поиск» (relative search). Суть его в том, что ищутся не какие-то абсолютные значения: критерием поиска служит разница между значениями искомой последовательности. Для этого достаточно взять какое-нибудь не слишком короткое слово, встречающееся в игре, и будут найдены все последовательности байт, в которых разница между элементами равна разнице между кодами символов исходного слова.
Например, для слова «WORLD» найдётся как последовательность «57 4F 52 4C 44», так и «77 6F 72 6C 64». Да хоть «13 0B 0E 08 00»! Найдя такие последовательности и убедившись, что это именно закодированное слово, мы может запросто составить таблицу кодировки. Самой известной программой, обладающей таким функционалом, является хекс-редактор Translhexion. Имеется и куча специализированных утилит вроде Search Relative. Да и многие из технически грамотных переводчиков писали для себя подобные утилиты.
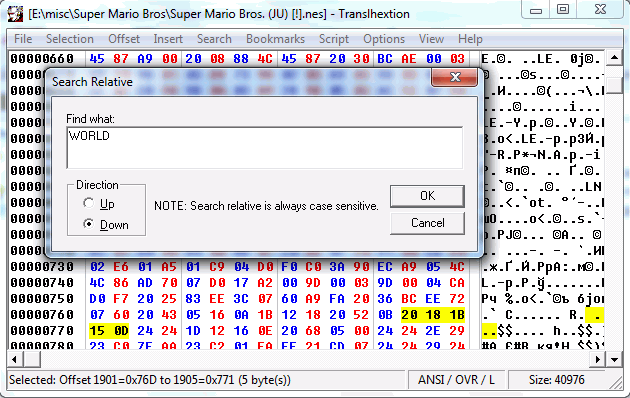
Типичный случай: если сравнить данный скриншот с полотном шрифта, то видно, что найденная последовательность — это индексы символов в шрифте: 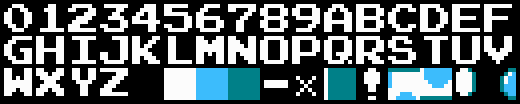
В целом, такая методика хоть и применима в подавляющем большинстве случаев, но без некоторых ухищрений действует далеко не всегда. Ведь никто не гарантирует, что коды символов в кодировке идут в том же порядке, что и буквы в алфавите.
Например, в переизданиях многих частей Final Fantasy для GameBoy Advance и Nintendo DS символы в шрифте отсортированы по частоте встречаемости, а для кодирования индексов используется способ, напоминающий UTF-8. Т.е. любой символ с кодом больше 0x7F кодируется двумя байтами, в то время как первые 128 символов кодируются всего одним:
Более суровый случай на моей памяти — это Final Fantasy: 20th Anniversary Edition для PlayStation Portable. Для каждой локации там существовал свой шрифт, свой текст и, как следствие, своя кодировка. Шрифт состоял только из встречаемых в тексте символов, которые так же были упорядочены по частоте встречаемости. Впору бы использовать нейронные сети для распознавания кодировки каждой локации, но благо хватило попиксельного сравнения масок прозрачности символов.
В этих случаях относительный поиск тоже подходит для решения задачи, но необходимо искать не по разнице между номерами букв, а по разнице между индексами их символов в шрифте. Т.е. можно просто записать последовательность индексов — это вполне сгодится для такого поиска.
Как и другие ресурсы, текст может быть запакован или зашифрован. В таком случае поиск среди данных игры поможет только в случаях, когда в запакованных или зашифрованных данных всё же присутствуют хотя бы обрывки слов (такое часто бывает при использовании алгоритмов вроде LZ77 или RLE). Поэтому выходом может быть поиск в дампе оперативной памяти. Возможность добычи дампа зависит от платформы, для которой делается перевод. Для эмулируемых консолей и PC трудностей быть не должно — есть куча средств для получения доступа к памяти игры. А вот в других случаях нужна возможность во время игры запустить на консоли необходимый код, для чего, как правило, консоль должна быть «взломана». Про методики разбора самих алгоритмов я расскажу в следующей статье.
Поиск указателей
 Если данные хранятся в сериализованном виде, этот пункт можно смело пропускать. Если же ресурсы хранятся в исполняемом файле (что практически всегда верно для консолей, использующих картриджи) в готовом для использования виде, то, как правило, на каждый такой ресурс есть указатель. Естественно, текста это тоже касается. Тем более, чтобы стало возможным свободно модифицировать текст, надо найти все указатели и ссылки на каждую из изменяемых строк.
Забавно, что для ряда новичков понимание концепции указателей является одним из самых сложных препятствий в освоении искусства любительского перевода. Как правило, такие люди долгое время не утруждают себя технической стороной процесса и переводят текст так, чтобы он вмещался в длину оригинальной строки. Ещё более забавно то, что для совершенствования навыков многие из них в итоге осваивают программирование. Стоило бы это сделать в обратном порядке — и всё было бы гораздо проще. Хотя стоит заметить, что люди, ставшие полноценными IT-специалистами, часто уходят с этой сцены и начинают заниматься вещами посерьёзней.
Очень часто все указатели хранятся в едином месте, которое обычно называют «таблицей указателей» — оно представляет собой массив из указателей или элементов, их содержащих. В таких случаях игра обращается к строкам по индексам, по которым, в свою очередь, из такой таблицы берётся указатель. Тогда достаточно найти указатель на любую строку в блоке текста — и таблица найдена!
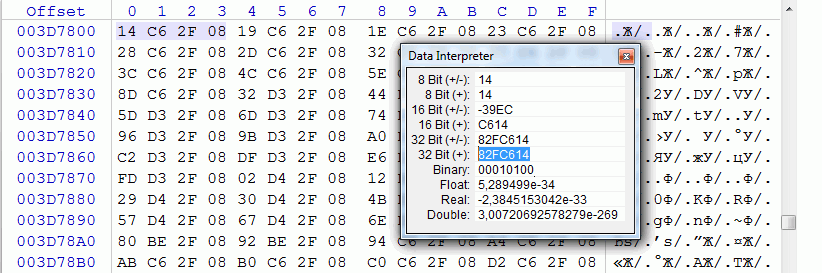
Но не всё так просто… вернее, не всегда всё так просто. Одна из сложностей, мешающих искать указатели, называется «разницей смещений». Дело в том, что указатель может быть не только абсолютным (указывающим на логический или физический адрес ресурса), но и относительным (указывающим на смещение относительно какого-то адреса). Или же, скажем, на старых дисковых консолях вроде PlayStation данные часто хранятся в подготовленном для загрузки в память виде — т.е. пока они лежат в файле, невозможно просто так вычислить, на что будет указывать указатель, не зная адреса, куда будет происходить загрузка.
Пока не известна разница смещений, нельзя однозначно вычислить указатель. Поэтому первым делом обычно проверяют наличие таблицы — для этого может помочь тот же самый относительный поиск. В качестве элементов искомой последовательности берутся расстояния между началами строк — разница между значениями указателей будет точно такой же. Если таблица не находится — поиск повторяют, перебирая возможные размеры указателей и возможные расстояния между ними (если помимо указателей в таблицах содержатся другие данные).
Однако, не всё коту масленица — некоторые игры обращаются к строке прямиком по указателю без использования таблиц. Тогда уже разницу вычисляют как могут: например, путём визуального анализа данных или с помощью дизассемблера. Есть ещё один «дедовский» способ: участки данных «поганят», подменяя байты, и смотрят, отразилось ли это как-нибудь на игре. Таким образом, сокращая диапазон поиска методом исключения, можно локализовать участок кода, отвечающий за вывод какой-либо строки, и найти указатель. Для таких целей даже существуют целые специализированные инструменты вроде Поганка или Visual Poganka.
Без использования таблиц указатели будут раскиданы по всему пространству кода в исполняемом файле, и порой далеко не в единичном экземпляре. Если текст складирован в одном месте, эту проблему можно решить, просканировав его и найдя все указатели на начало каждой строки. И в большинстве случаев это не составляет труда — из-за особенностей адресного пространства вероятность коллизии значения указателя с другим значением минимальна (например, память адресуется в диапазоне 0x08000000-0x09FFFFFF или секция данных начинается с адреса 0x00472000).
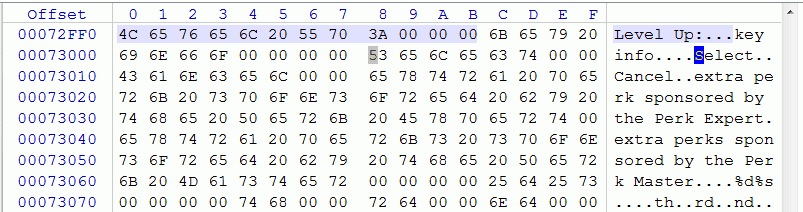
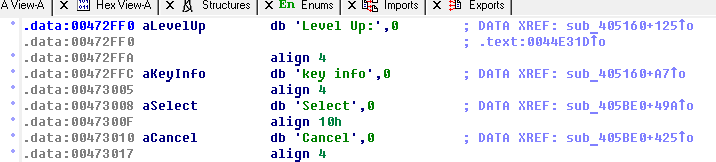
Но бывает и так, что память адресуется менее удачным для переводчика способом: например, начиная с нулевого адреса. И тогда коллизий уж точно не избежать… Придётся вручную проверять каждое значение, встречающееся более одного раза, на предмет того, является ли оно указателем или же данными с таким же значением. А если ещё и сам текст разбросан по файлу, то автоматизировать процесса поиска указателей можно разве что написав какой-нибудь скрипт или плагин к IDA Pro.
Так или иначе, терпение и труд всё перетрут. Достаточно найти указатели один раз и дальше с этой задачей можно не заморачиваться, переходя к следующему шагу.
Извлечение текста
 Способ «выемки» текста по таблицам зависит от уровня организации переводчиков. Так, самые неорганизованные ребята (как правило, новички) вообще не заморачиваются и переводят текст прямо в хекс-редакторах. Чуть посерьёзней — используют для извлечения программы-всёделалки вроде PokePerevod или тот же Translhexion. Люди с более глубокими познаниями используют более специализированные средства автоматизации вроде Kruptar. Самые продвинутые специалисты обычно пишут для этого свои скрипты или инструменты, что и вовсе позволяет им контролировать процесс полностью.
В любом случае, в чаще всего процесс сводится к преобразованию потока байт в пригодный к чтению и редактированию вид, используя информацию о кодировках, бинарных тегах и применяемом игрой байткоде, если он имеет место быть.

Но вовсе не факт, что разработчики изначально хранили текст отдельно и в чистом виде. Очень часто он является лишь частью других данных — карт уровней, сценариев и т.п. Если кто-нибудь знаком с игровыми редакторами вроде TES Construction Set, то он поймёт, о чём речь. В таких случаях, поскольку текст хранится совместно с другими данными, необходимо «распарсить» их структуру и аккуратно извлечь текст и прочую необходимую информацию — например, иногда помимо текста необходимо изменять ещё и такие данные, как координаты его вывода и размеры диалоговых окон. Порой для этого пишутся целые редакторы, которые частично воспроизводят функционал средств, которыми пользовались разработчики.
В целом, к извлечению текста у меня свой подход. Начнём с того, что стандартный формат таблиц кодировки довольно прост и не покрывает все случаи. Например, иногда важно знать, какие последовательности байт служат для индикации конца текста, переноса строки или очистки экрана. Также в игре могут быть использованы, к примеру, коды разметки, где определённая часть битов выступает в качестве параметра. В таком случае пришлось бы записывать всё это дело примерно так:
Поэтому существует множество надстроек над этим форматом — я даже разрабатывал своё собственное расширение, которое позволяло описать даже коды разметки и прочие байты с параметрами, а также поддерживало директивы вроде include (удобно, когда есть таблицы для разных языков, но в них есть одинаковые элементы).
Рассмотрим пример таблицы в расширенном формате:
Несмотря на некоторую кашу в таблице, на выходе получался довольно опрятный для игрового скрипта текст:
О роли опрятности будет сказано чуть ниже, а сейчас рассмотрим проблему байткода. В некоторых играх используются даже свои скриптовые языки, и хорошо, если текст в них используется в качестве внешних ресурсов. Но порой всё же приходится разгребать мешанину из текста и кода.
Если невозможно отделить код от текста, то обычно для каждой инструкции придумывают мнемонику и форму записи исходя из её назначения. Составив базу с информацией о всех инструкциях, несложно написать транслятор. Но чтобы не писать такие вещи каждый раз, я придумал ещё одно расширение для таблицы кодировки.
Инструкция в байткоде идентифицируется по определённым значениям некоторых битов. Допустим, у нас есть две инструкции размером с байт. У одной инструкции биты с первого по четвёртый равны 0101 , т.е. выглядит она как 0101nnnn ; у другой — первые два бита равны 11 , т.е. запишем её как 11nnnnnn . Самым простым способом идентифицировать инструкцию является сравнение по маске — т.е. надо произвести логическое умножение опознаваемого кода на битовую маску, выделив тем самым нужные биты, и сравнить результат с эталонными данными (далее по тексту будем называть это идентификатором инструкции). Таким образом, для первой инструкции маской будет 11110000 , поскольку мы должны взять только первые 4 бита, а идентификатором, соответственно, будет 01010000 . Для второй инструкции и маска, и идентификатор равны 11000000 .
Суть расширения в том, что для инструкций можно прямо в таблице записать битовые маски и идентификаторы, которые нужны для их определения и чтения параметров. А вместо простой последовательности символов можно использовать специальную строку, которая будет говорить о том, как форматировать и конвертировать текстовое представление инструкции обратно в байткод. Т.е. по таким таблицам можно было бы даже примитивно дизассемблировать исполняемые файлы.
Форма такой записи инструкции в таблице кодировки такова:
Где OpcodeMask — маска, OpcodeID — идентификатор, ValueMasks — перечисленный через запятую список битовых масок параметров, а FormatString — строка для форматирования текстового представления инструкции и конвертации её обратно в байткод (представляет из себя модифицированный эквивалент форматных строк для функции printf).
Например, у нас есть инструкция вида 1010iiii cccccccc , показывающая во всплывающем окне цвета с предмет с номером i. Назовём её «popup(item, color)». Маска данной инструкции равна 11110000 00000000 , что в шестнадцатеричном представлении будет F000 . Идентификатор инструкции будет равен 10100000 00000000 , т.е. C000 , а маски параметров — 00001111 00000000 и 00000000 11111111 , то бишь 0F00 и 00FF соответственно.
Пусть у нас имеется такой вот закодированный текст:
0000: 4F 62 74 61 69 6E 65 64 20 61 6E 20 69 74 65 6D Obtained an item
0010: 21 C1 0F 0A 4E 6F 77 20 79 6F 75 20 63 61 6E 20 !##\nNow you can
0020: 6F 70 65 6E 20 74 68 65 20 64 6F 6F 72 2E open the door.
Попробуем декодировать его с помощью таблицы, в которой есть такая запись:
Получаем такой результат:
Не совсем удачно сочетается с текстом. Поэтому попробуем прибегнуть к помощи тегов. Пусть это будут XML-теги:
Уже гораздо лучше:
Но ещё лучше было бы, если бы вместо «магических констант» мы видели текстовое представление параметров. Для этого я ввёл возможность объявления перечислений в виде:
Допустим, такая инструкция применяется только для трёх предметов: бомбы с номером 0, ключа с номером 1 и монеты с номером 10:
Как видно, заодно и для цвета я применил более привычную запись. Конечно, глупо поступать таким образом с восьмибитным представление цвета, но это лишь пример, взятый из головы для наглядности.
Дальше нам остаётся только включить подсветку тегов и можем получить более-менее читабельный текст:
Если семантика инструкций не так важна (т.е. перевод не подразумевает их редактирования), то лучше прибегнуть к более краткой записи, а то в некоторых местах кода может получиться больше, чем текста. Например, так:
Для инструкций с ровно одним параметром я предусмотрел укороченную форму записи. Ниже следует две эквивалентных по смыслу строки:
Как видно из записи, вопросительными знаками я выделил биты параметра, остальные биты считаются единичными битами маски, а идентификатор получается путём замены вопросительных знаков на нули. К сожалению, такая запись возможна только для инструкций, где размеры параметра и идентификатора кратны четырём битам, т.е. размеру одного шестнадцатеричного символа.
Представление текста
 Это одна из самых важных частей процесса, потому что извлечённый текст попадёт прямиком к переводчикам, и от того, насколько он опрятен, зависит не только продуктивность их работы, но и количество структурных и семантических ошибок, которые они допустят. По сути этот процесс — доработка механизма извлечения текста таким образом, чтобы максимально упростить работу переводчиков.
Если рассматривать описанный в предыдущем пункте текст, то для переводчика достаточно краткого экскурса о назначении тегов и прочей белиберды, особо его напугать ничего не должно. Но, надо заметить, что основной, на мой взгляд, ошибкой в представлении текста является зашкаливающее количество технической информации. У большинства дилетантов такой текст выглядел бы совсем по-другому:
На месте переводчика я бы сказал: «и как прикажете это переводить?»
Увы, судя по обрывочным сведениям, такое встречается и в процессе официальных локализаций: вот дадут текст в формате XML или INI с «\n» в качестве переноса строк, и переводи как хочешь. При этом многие люди даже в таких случаях не изменяют Word’у, который какой-нибудь автозаменой способен убить структуру практически любого подобного формата или ещё чего хуже.
Это, конечно же, запросто может быть чревато тотальными ошибками, ибо обычно весь контроль качества производится вручную, несмотря на простор для его автоматизации. Как-то раз у «коллег» в релиз укатился очень крупный перевод без единого тире — все их молча скушал Word, подменив на «правильные», которые конвертору текста были не знакомы.
К сожалению, порой от трудно читаемого текста не спасает ничего. К тому же, в некоторых играх теги не компилируются в байткод, а так и хранятся в текстовом виде, т.е. игра обрабатывает их при выводе текста. Да что там говорить, вот вам пример:
&push;&main-color=#E67E00FF;Status:&pop;
&if=hasitem:Fuse7Used;Used&else;&if=hasitem:Fuse7;Acquired&else;Unknown&endif;&endif;&if=scan:SCAN,0x6479E69556A56AC8;
&if=(hasitem:Fuse7Used)|(hasitem:Fuse7);
&push;&main-color=#E67E00FF;Previous Coordinates:&pop;&else;
&push;&main-color=#E67E00FF;Coordinates:&pop;&endif;
&if=mapped:PirateCommand;04P-MET, Pirate Homeworld&else;04P-MET, Unknown&endif;
&just=left;Data indicates Energy Cell is connected to &push;&main-color=#FF6705B3;processing&pop; containment core.&endif;
Согласитесь, глаза сломать можно, что уж говорить о неустойчивости к ошибкам (легко сделать, трудно заметить). Выходом из ситуации мог бы послужить WYSIWYG-редактор, или, по крайней мере, конвертация текста в формат любого такого редактора и последующая конвертация обратно. Но это довольно дорогостоящее (в плане человекочасов) решение, да и от тегов и инструкций оно не сильно-то и спасает.
Раньше я пытался производить декомпозицию (разделение на две сущности) текста и других данных настолько, насколько позволяет конкретный случай. Например, теги можно группировать, заменяя на один тег вроде «» или «<<group_number>>», при этом вынося в отдельный файл. Но, поскольку теги тесно связаны с текстом, да и головной боли от такого решения только прибавляется, я впоследствии от этого отказался.
Но какой-никакой выход всё-таки нашёлся, и заключается он в подсветке синтаксиса. Т.к. все технические данные обычно легко обрабатываются автоматически, то и выделить их среди остального текста тоже не проблема.
Для этих целей я использовал возможности всем известного Notepad++ — в нём есть инструмент для создания своего механизма подсветки. Мне повезло с тем, что переводчик, с которым я работал, сам использовал Notepad++, поэтому уговаривать никого не пришлось. Несмотря на ограниченность в создании правил подсветки, этой возможности оказалось вполне достаточно, хоть и приходилось порой прибегать к разнообразным костылям. 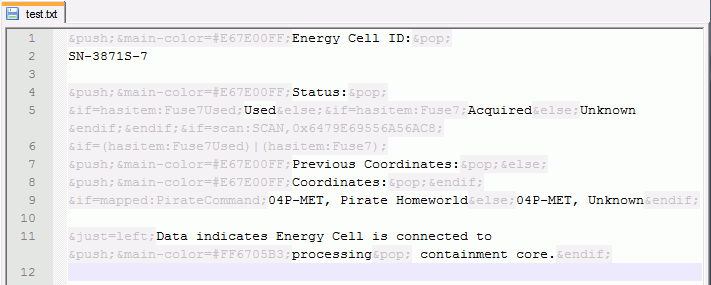
С этим уже вполне можно жить. А иногда я заходил ещё дальше и писал визуализаторы — программы, которые отображали текст так же, как бы он выглядел в игре. Ну, или почти так же… 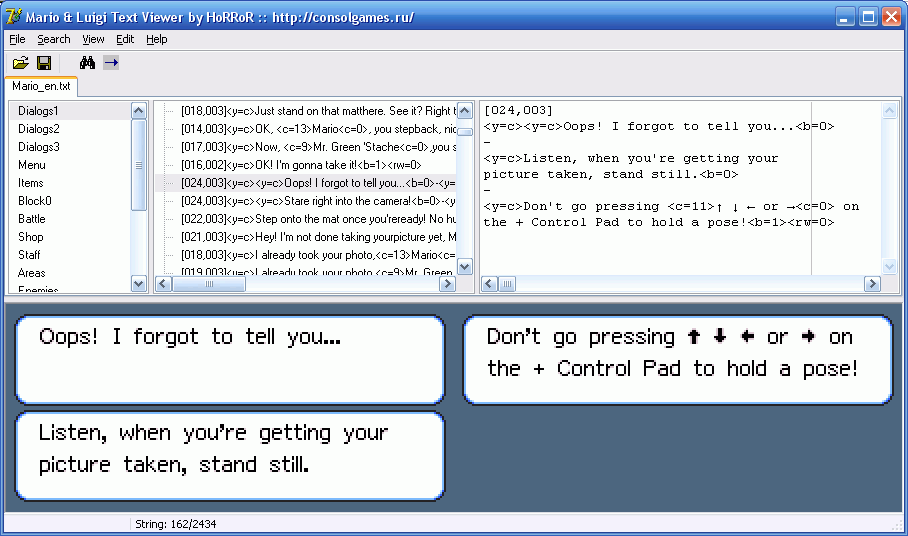
Впрочем, это обычно касалось случаев, когда необходим был жёсткий контроль качества на предмет корректного вывода текста в диалоговых окнах. А гораздо проще контролировать это ещё на этапе перевода, чем потом отлавливать тысячи косяков, связанных с выходом текста за отведённые ему рамки. Хорошо, что во многих играх всё же существует автоперенос.