13 t-тест
Мы научились делать z-тест. Однако на практике он не используется, потому что предполагает, что мы откуда-то знаем стандартное отклонение в генеральной совокупности. На практике это обычно не так, поэтому мы оцениваем стандартное отклонение в генеральной совокупности на основе стандартного отклонения по выборке. Это приводит к тому, что тестовая статистика уже не распределена нормально, а распределена согласно t-распределению. Ну и статистика уже называется t-статистикой.
Иногда это t-распределение называют t-распределением Стьюдента, а соответствующий статистический тест — критерий Стьюдента. Дело в том, что его открыл сотрудник пивоварни Гиннесс Уильям Госсет. Сотрудникам Гиннесса было запрещено публиковать научные работы под своим именем, поэтому он написал свою знаменитую работу про t-распределение под псевдонимом “Ученик” (Student).
Форма этого распределения очень похожа на форму нормального распределения, но имеет более тяжелые “хвосты” распределения. При этом эта форма зависит от размера выборки: чем больше выборка, тем ближе распределение к нормальному. Этот параметр распределения называется степенями свободы (degrees of freedom) и вычисляется как \(N — 1\) , где \(N\) — это размер выборки.
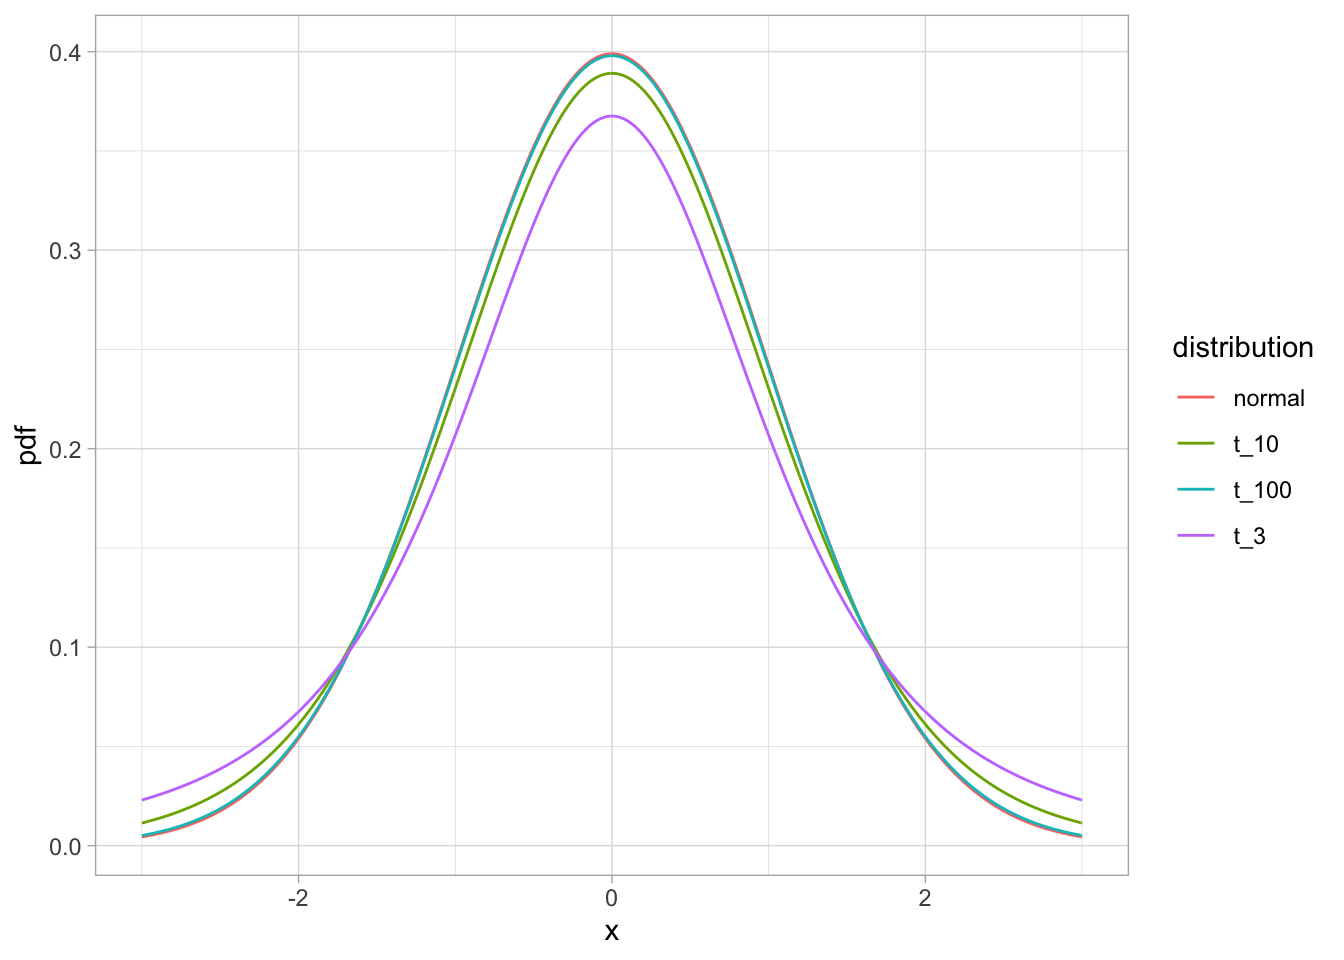
Как видите, чем больше выборка (и количество степеней свободы соответственно), тем ближе t-распределение к стандартному нормальному распределению. При 100 степенях свободы они уже почти не различимы! Поэтому на больших выборках разница между t-тестом и z-тестом будет минимальна, тогда как на маленьких выборках разница может быть значительной.
Давайте посчитаем t-статистику на тех же симулированных данных:
Давайте для сравнения еще раз посчитаем z-статистику:
Как видите, расчет довольно схожий, разница только в том, откуда мы берем стандартное отклонение. Для z-статистики у нас был заранее известный параметр генеральной совокупности (что обычно не так), для t-статистики мы оценивали стандартное отклонение по выборке.
Давайте теперь посчитаем p-value. Мы будем пользоваться не функцией pnorm() , а функцией pt() , а в качестве параметра распределения указать количество степеней свобод в df =
Функция pt() считает от минус бесконечности до \(t\) , а нам нужно от \(t\) до плюс бесконечности, потому что \(t\) больше 0:
И не забываем умножать на 2, если мы хотим сделать двусторонний тест.
В отличие от z-теста, t-тест есть в базовом R.
Да, конечно, мы могли сразу запустить эту функцию и получить результаты. Обычно именно так вы и будете делать. Зато теперь вы знаете, что стоит за всеми числами в результате выполнения функции t.test() . Здесь можно увидеть выборочное среднее как оценку среднего в генеральной совокупности, 95% доверительный интервал для оценки среднего в генеральной совокупности, t-статистику, степени свобод и p-value.
13.2 Двухвыборочный t-тест
Одна из наиболее часто встречающихся задач при анализе данных — это сравнение средних двух выборок. Для этого нам тоже понадобится t-тест, но теперь \(H_0\) нужно сформулировать по-другому: что две генеральные совокупности (из которых взяты соответствующие выборки) имеют одинаковое среднее. \[H_0: \mu_1 = \mu_2\]
Ну а альтернативная гипотеза, что эти две выборки взяты из распределений с разным средним в генеральной совокупности. \[H_1: \mu_1 \ne \mu_2\]
Есть две разновидности двухвыборочного t-теста: зависимый t-тест и независимый t-тест. Различие между зависимыми и независимыми тестами принципиальное, мы с ним еще будем сталкиваться.
Зависимые тесты предполагают, что каждому значению в одной выборке мы можем поставить соответствующее значение из другой выборки. Обычно это повторные измерения какого-либо признака в разные моменты времени. В независимых тестах нет возможности сопоставить одно значение с другим. Мы уже не можем напрямую соотнести значения в двух выборках друг с другом, более того, размер двух выборок может быть разным!
Использование зависимых и независимых тестов связано с использованием внутрииндивидуального и межиндивидуального экспериментальных дизайнов в планировании научных экспериментов. Даже если вы не планируете в дальнейшем заниматься проведением экспериментов, понимание различий между двумя видами дизайнов поможет вам понять разницу между зависимыми и независимыми тестами.
Например, мы хотим исследовать влияние кофеина на скорость реакции. Можно поступить по-разному:
Набрать выборку, каждому испытуемому дать либо кофеин (например, в виде раствора небольшого количества кофеина в воде), либо обычную воду. Что именно получит испытуемый получит определяется случайным образом. Испытуемый не должен знать, что ему дают (слепое тестирование), а в идеале этого должен не знать даже экспериментатор, который дает напиток и измеряет показатели (двойное слепое тестирование). Посчитать скорость выполнения выбранной задачи, отправить домой. Это межинидивидуальный экспериментальный дизайн, для анализа результатов которого нам понадобится независимый t-тест.
Набрать выборку, каждому испытуемому дать и обычную воду, и воду с кофеином, записывать скорость решения задач после употребления простой воды и после употребления воды с кофеином, соответственно. В данном случае будет случайным образом варьироваться порядок предъявления: одни испытуемые сначала получат обычную воду, а потом воду с кофеином, другие испытуемые — наоборот. Для такого эксперимента понадобится меньше участников, но оно будет дольше для каждого участника. Более того, в этом случае мы учтем межиндивидуальные различия участников: одни участники в среднем решают задачи быстрее других. Это внутриинидивидуальный экспериментальный дизайн, для анализа результатов которого нам понадобится зависимый t-тест.
Итак, с тем, когда использовать зависимый, а когда независимый t-тест, более-менее разобрались, давайте опробуем их!
13.2.1 Двухвыборочный зависимый t-тест
Двухвыборочный зависимый t-тест — это то же самое, что и одновыборочный t-тест, только для разницы между связанными значениями. Поскольку наша нулевая гипотеза звучит, что средние должны быть равны,
то при верности нулевой гипотезы \[\mu_1 — \mu_2 = 0\] .
Тогда вместо \(x\) подставим \(d\) — разницу (вектор разниц) между парами значений. Получаем вот что:
Мы будем использовать данные с курса по статистике Университета Шеффилда про эффективность диет. Мы вытащим оттуда данные по диете номер 1 и посмотрим, действительно ли она помогает сбросить вес.
Провести двухвыборочный t-тест можно в R двумя базовыми способами. Первый вариант — это дать два вектора значений. Это удобно в случае широкого формата данных.
Второй вариант — используя формулы. Это удобно при длинном формате данных:
В обоих вариантах мы использовали paired = TRUE , чтобы обозначить использование именно зависимого (т.е. парного) t-теста.
| Внутрииндивидуальный план | Межиндивидуальный план |
|---|---|
| Зависимый t-тест | Независимый t-тест |
| t.test(. paired = TRUE) | t.test(. paired = FALSE) |
13.2.2 Двухвыборочный независимый t-тест
В случае независимого t-теста формула отличается. Однако гипотеза остается такой же и логика примерна та же.
У двух выборок могут различаться стандартные отклонения, поэтому для подсчет стандартной ошибки разницы средних для независимых выборок нужно сначала посчитать объединенное стандартное отклонение (pooled standard deviation):
Тогда стандартная ошибка разницы средних считается следующим образом:
Выглядит сложно, но по своей сути это что-то вроде усредненного стандартного отклонения (с учетом размеров выборок). Ну а t-статистика затем считается просто:
Давайте теперь опробуем независимый t-тест для сравнения веса испытуемых двух групп после диеты. Мы снова воспользуемся функцией t.test() , но теперь уже поставим paired = FALSE :
Если присмотритесь, то увидите, что со степенями свободы что-то странное. Они дробные! Дело в том, что мы провели не совсем “настоящий” t-тест, а его очень близкую альтернативу под названием тест Уэлча (Welch test), который иногда называют поправкой Уэлча к t-тесту. Эта поправка позволяет тесту лучше справляться с выборками с разной дисперсией. Даже если у нас нет проблем с разной дисперсией, то от поправки Уэлча хуже не будет, поэтому это вариант по умолчанию в R.
Но если его хочется отключить, то нужно поставить var.equal = TRUE .
13.3 Допущения t-теста
Чтобы подсчет p-value был корректным, некоторые допущения должны быть выполнены.
- Нормальное распределение. Это самое известное допущение, но чуть ли не наименее важное. Часто утверждается, что выборки должны быть взяты из нормального распределения. Это не совсем так: да, верно, это достаточное условие, но не необходимое. В первую очередь, важно именно выборочное распределение (средних разниц или разниц средних), которое достигается за счет центральной предельной теоремы (12.8) особенно при большой выборке (Lumley et al. 2002) . Отсюда и все правила в духе “для t-теста распределение должно быть нормальным, но если n > 30, то это необязательно.” Откуда именно 30? Да ниоткуда, просто. Как и со всеми точными числами в статистике.
Для проверки на нормальность существуют различные статистические тесты. Самый известный из них — тест Шапиро-Уилка. Его можно провести в R при помощи функции shapiro.test() .
В нашем случае p-value больше 0.05, что логично: мы взяли эту выборку именно из нормального распределения. Если p-value меньше уровня \(\alpha\) , который у нас стандартно 0.05, то мы можем отвергнуть нулевую гипотезу о том, что выборка взята из нормального распределения. Если это так, то нам нужно, по идее, отказаться от t-теста и использовать непараметрический тест, который не имеет требований к распределению исследуемой переменной.
Однако проведения теста на нормальность для проверки допущения о нормальности — вещь довольно бессмысленная. Дело в том, что тест Шапиро-Уилка — это такой же статистический тест, как и все прочие: чем больше выборка, тем с большей вероятностью он “поймает” отклонения от нормальности, чем меньше выборка, тем с меньшей вероятностью он обнаружит даже серьезные отклонения от нормальности. А нам-то нужно наоборот! При большой выборке отклонения от нормальности нам не особо страшны, а при маленькой тест все равно ничего не обнаружит. Более того, идеально нормальных распределений в природе вообще почти не существует! А это значит, что при достаточно большой выборке тест Шапиро-Уилка практически всегда будет находить отклонения от нормальности. Все это делает его малоинформативным при тестировании допущения о нормальности. Это же верно и для других тестов на нормальность.
Другой способ проверять допущение о нормальности — это проверять визуально с помощью гистограммы или Q-Q plot (см. @ref(lm_a))
Для двувыборочного независимого t-теста выборки должны быть взяты из распределения с одинаковыми дисперсиями. Однако это не так критично с применением поправки Уэлча.
Независимость значений (или пар) в выборке. Типичным примером нарушения независимости является случай, когда t-тест применяется на неусредненных (например, по испытуемому) значениях. Еще один пример нарушения независимости — использование одного наблюдения несколько раз или использование одного и того же испытуемого несколько раз. Определить независимость можно следующим мысленным экспериментом: могу ли я хоть как-нибудь предсказать следующее значение в выборке? Например, в случае с несколькими значениями от одного испытуемого я могу ориентироваться на его предыдущие результаты и предсказать последующие результаты лучше, чем на основе простого среднего по всем остальным значениям. Это значит, что допущение о независимости нарушено.
13.4 Непараметрические аналоги t-теста
Если выборка не очень большая и взята из сильно ассиметричного распределения или выборка представляет собой порядковые данные, то можно воспользоваться непараметрическими альтернативами для t-теста.
Непараметрические тесты не имеют допущений о распределении, что делает их более универсальными. Большинство подобных тестов подразумевает превращение данных в ранги, т.е. внутри этих тестов происходит преобразование в ранговую шкалу. Такое преобразование может снизить статистическую мощность теста и привести к повышению вероятности ошибки второго рода.
13.4.1 Тест Уилкоксона
Непараметрический аналог двустороннего зависимого t-теста называется тестом Уилкоксона. Функция для него называется wilcox.test() , и она имеет такой же синтаксис, как и t.test() .
Не пугайтесь, когда видите сообщение “Есть совпадающие значения: не могу высчитать точное p-значение”. Это означает, что в ваших данных есть повторяющиеся значения, поэтому расчет p-value в данном случае — это некоторая апроксимация, но в большинстве случаев это не играет серьезной роли.
Алгоритм расчета t-критерия Стьюдента для независимых выборок измерений
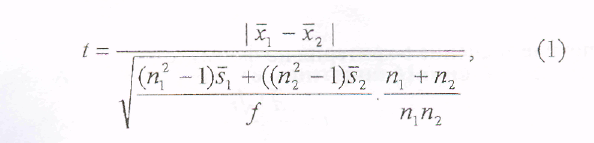
Определить критическое значение t-критерия с использованием таблицы 1 приложения, при заданном уровне значимости и степени свободы.
Сравнить расчетное и критическое значение t — критерия. Если расчетное значение больше или равно критическому, то гипотеза равенства средних значений в двух выборках изменений отвергается (Но). Во всех других случаях она принимается на заданном уровне значимости.
Пример. Две группы студентов обучались по двум различным методикам. В конце обучения с ними был проведен тест по всему курсу. Необходимо оценить, насколько существенны различия в полученных знаниях. Результаты тестирования представлены в таблице 4.
Рассчитаем выборочное среднее, дисперсию и стандартное отклонение:

Определим значение tp по формуле tp = 0,45
По таблице 1 (см. приложение) находим критическое значение tk для уровня значимости р = 0,01
Вывод: так как расчетное значение критерия меньше критического 0,45<2,88 гипотеза Но подтверждается и существенных различий в методиках обучения нет на уровне значимости 0,01.
Алгоритм расчета t-критерия Стьюдента для зависимых выборок измерений
1. Определить расчетное значение t-критерия по формуле
 , где

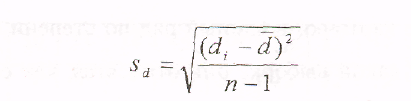
2. Рассчитать степень свободы f 
3. Определить критическое значение t-критерия по таблице 1 приложения.
4. Сравнить расчетное и критическое значение t-критерия. Если расчетное значение больше или равно критическому, то гипотеза равенства средних значений в двух выборках изменений отвергается (Но). Во всех других случаях она принимается на заданном уровне значимости.
U—критерий Манна—Уитни
Назначение критерия
Критерий предназначен для оценки различий между двумя непараметрическими выборками по уровню какого-либо признака, количественно измеренного. Он позволяет выявлять различия между малыми выборками, когда n < 30.
Описание критерия
Этот метод определяет, достаточно ли мала зона пересекающихся значений между двумя рядами. Чем меньше эта область, тем более вероятно, что различия достоверны. Эмпирическое значение критерия U отражает то, насколько велика зона совпадения между рядами. Поэтому чем меньше U, тем более вероятно, что различия достоверны.
НО: Уровень признака в группе 2 не ниже уровня признака в группе 1.
HI: Уровень признака в группе 2 ниже уровня признака в группе 1.
Алгоритм расчета критерия Манна-Уитни (u)
Перенести все данные испытуемых на индивидуальные карточки.
Пометить карточки испытуемых выборки 1 одним цветом, скажем красным, а все карточки из выборки 2 – другим, например, синим.
Разложить все карточки в единый ряд по степени нарастания признака, не считаясь с тем, к какой выборке они относятся, как если бы мы работали с одной большой выборкой.
Проранжировать значения на карточках, приписывая меньшему значению меньший ранг.
Вновь разложить карточки на две группы, ориентируясь на цветные обозначения: красные карточки в один ряд, синие – в другой.
Подсчитать сумму рангов отдельно на красных карточках (выборка 1) и на синих карточках (выборка 2). Проверить, совпадает ли общая сумма рангов с расчетной.
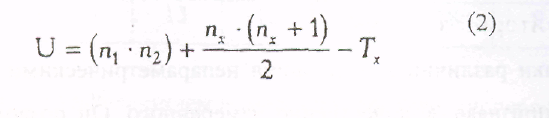 Определить большую из двух ранговых сумм.
Определить значение U по формуле:
где n1 – количество испытуемых в выборке 1;
n2 – количество испытуемых в выборке 2,
Тх – большая из двух рантовых сумм;
nх – количество испытуемых в группе с большей суммой рангов.
9. Определить критические значения U по таблице 2 (см. приложение).
Если Uэмп.> Uкр0,05, то гипотеза Но принимается. Если Uэмп.≤ Uкр, то отвергается. Чем меньше значения U, тем достоверность различий выше.
Пример. Сравнить эффективность двух методов обучения в двух группах. Результаты испытаний представлены в таблице 5.
t-КРИТЕРИЙ СТЬЮДЕНТА ДЛЯ НЕЗАВИСИМЫХ СОВОКУПНОСТЕЙ
– общее название для класса методов статистической проверки гипотез (статистических критериев), основанных на распределении Стьюдента. Наиболее частые случаи применения t-критерия связаны с проверкой равенства средних значений в двух выборках.
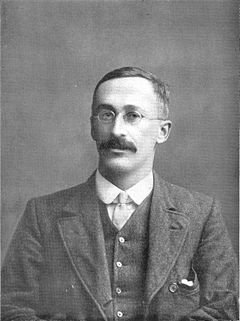
Уильям Госсет
1. История разработки t-критерия
Данный критерий был разработан Уильямом Сили Госсетом для оценки качества пива в компании Гиннесс. В связи с обязательствами перед компанией по неразглашению коммерческой тайны, статья Госсета вышла в 1908 году в журнале «Биометрика» под псевдонимом «Student» (Студент).
2. Для чего используется t-критерий Стьюдента?
t-критерий Стьюдента используется для определения статистической значимости различий средних величин. Может применяться как в случаях сравнения независимых выборок (например, группы больных сахарным диабетом и группы здоровых), так и при сравнении связанных совокупностей (например, средняя частота пульса у одних и тех же пациентов до и после приема антиаритмического препарата). В последнем случае рассчитывается парный t-критерий Стьюдента
3. В каких случаях можно использовать t-критерий Стьюдента?
Для применения t-критерия Стьюдента необходимо, чтобы исходные данные имели нормальное распределение. Также имеет значение равенство дисперсий (распределения) сравниваемых групп (гомоскедастичность). При неравных дисперсиях применяется t-критерий в модификации Уэлча (Welch’s t).
При отсутствии нормального распределения сравниваемых выборок вместо t-критерия Стьюдента используются аналогичные методы непараметрической статистики, среди которых наиболее известными является U-критерий Манна — Уитни.
4. Как рассчитать t-критерий Стьюдента?
Для сравнения средних величин t-критерий Стьюдента рассчитывается по следующей формуле:
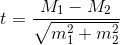
где М1 — средняя арифметическая первой сравниваемой совокупности (группы), М2 — средняя арифметическая второй сравниваемой совокупности (группы), m1 — средняя ошибка первой средней арифметической, m2 — средняя ошибка второй средней арифметической.
5. Как интерпретировать значение t-критерия Стьюдента?
Полученное значение t-критерия Стьюдента необходимо правильно интерпретировать. Для этого нам необходимо знать количество исследуемых в каждой группе (n1 и n2). Находим число степеней свободы f по следующей формуле:
После этого определяем критическое значение t-критерия Стьюдента для требуемого уровня значимости (например, p=0,05) и при данном числе степеней свободы f по таблице (см. ниже).
Сравниваем критическое и рассчитанное значения критерия:
- Если рассчитанное значение t-критерия Стьюдента равно или больше критического, найденного по таблице, делаем вывод о статистической значимости различий между сравниваемыми величинами.
- Если значение рассчитанного t-критерия Стьюдента меньше табличного, значит различия сравниваемых величин статистически не значимы.
6. Пример расчета t-критерия Стьюдента
Для изучения эффективности нового препарата железа были выбраны две группы пациентов с анемией. В первой группе пациенты в течение двух недель получали новый препарат, а во второй группе — получали плацебо. После этого было проведено измерение уровня гемоглобина в периферической крови. В первой группе средний уровень гемоглобина составил 115,4±1,2 г/л, а во второй — 103,7±2,3 г/л (данные представлены в формате M±m), сравниваемые совокупности имеют нормальное распределение. При этом численность первой группы составила 34, а второй — 40 пациентов. Необходимо сделать вывод о статистической значимости полученных различий и эффективности нового препарата железа.
Решение: Для оценки значимости различий используем t-критерий Стьюдента, рассчитываемый как разность средних значений, поделенная на сумму квадратов ошибок:

После выполнения расчетов, значение t-критерия оказалось равным 4,51. Находим число степеней свободы как (34 + 40) — 2 = 72. Сравниваем полученное значение t-критерия Стьюдента 4,51 с критическим при р=0,05 значением, указанным в таблице: 1,993. Так как рассчитанное значение критерия больше критического, делаем вывод о том, что наблюдаемые различия статистически значимы (уровень значимости р<0,05).
Автоматический расчет t-критерия Стьюдента
Составлено по материалам книги: Ермолаев О. Ю. «Математическая статистика для психологов» — 4-е издание испр. – М.: Московский психолого-социальный институт: Флинта, 2006 г.
ЗАДАТЬ ВОПРОС
ПСИХОЛОГУ
/>Софья Каганович
Психолог-консультант, психодраматерапевт, психодиагност.
/>Владимир Каратаев
Психолог, психоаналитик.
/>Андрей Фетисов
Психолог, гештальт-терапевт.
/>Катерина Вяземская
Психолог, гештальт-терапевт, семейный терапевт.
Назначение t-критерия Стьюдента
t-критерий был разработан Уильямом Госсетом (1876-1937) для оценки качества пива на пивоваренных заводах Гиннесса в Дублине (Ирландия). В связи с обязательствами перед компанией по неразглашению коммерческой тайны (руководство Гиннесса считало таковой использование статистического аппарата в своей работе), статья Госсета вышла в 1908 году в журнале «Биометрика» под псевдонимом «Student» (Студент).
Критерий Стьюдента направлен на оценку различий величин средний значений двух выборок, которые распределены по нормальному закону. Одним из главных достоинств критерия является широта его применения. Он может быть использован для сопоставления средних у связных и несвязных выборок, причем выборки могут быть не равны по величине.
Условия применения t-критерия Стьюдента
Для применения t-критерия Стьюдента необходимо соблюдать следующие условия:
1. Измерение может быть проведено в шкале интервалов и отношений.
2. Сравниваемые выборки должны быть распределены по нормальному закону.
Автоматический расчет t-критерия Стьюдента
Шаг 1
Чтобы произвести правильный расчет с помощью настоящего скрипта, необходимо:
1) Выбрать расчет для случая с несвязными (независимыми) или связными (зависимыми) выборками.
2) Ввести в первую колонку («Выборка 1») данные первой выборки, а во вторую колонку («Выборка 2») данные второй выборки. Данные вводятся по одному числу на строку; без пробелов, пропусков и т.д. Вводятся только цифры. Дробные числа вводятся со знаком «.» (точка).
3) После заполнения колонок нажать на кнопку «Шаг 2», чтобы произвести автоматический расчет t-критерия Стьюдента.
 Учебник представляет практическое руководство по математической статистике для психологов, не имеющих специальных математических знаний. В доступной иллюстративной форме на примерах рассматриваются основные методы обработки данных, включая непараметрические и параметрические критерии оценки различий, корреляционный, дисперсионный, факторный, регрессионный анализы. Приведены необходимые теоретические сведения и формулы для расчета типовых задач, наиболее часто встречающихся в экспериментальных психологических исследованиях.

Если у вас есть цель, – заняться спортом с понедельника, бросить курить, сдать все пропуски в институте или выучить иностранный язык – самое важное в этом пути, не помереть в процессе и дойти до конца.

Что такое заниженная самооценка, каковы причины и чувства, скрывающиеся под этим синдромом? Как улучшить свою самооценку?