Timsort: Fastest sorting algorithm for real world problems.

Timsort was implemented by Tim Peters in 2002, it has been a standard sorting algorithm for Python since Python 2.3. Python’s sorted and list.sort function uses Tim sort. Java uses Timsort in JDK for sorting non primitive types. Android platform and GNU Octave also uses it as a default sorting algorithm.
Timsort is a stable algorithm and beats every other sorting algorithm in time. It has O(nlogn) time complexity for worst case unlike quick sort and O(n) for best case scenarios unlike merge sort and heap sort.
In real world scenarios, most of the times input array is naturally ordered array hence merge sort and quick sort aren’t the efficient choice. Tim sort shines when data is ordered and of course when data is random.
Why Tim sort is fast
Tim sort is a hybrid algorithm which uses Binary insertion sort and improved merge sort by using galloping (more on this later) in a combination. Binary insertion sort is best method to sort when data is already or partially sorted and merge sort is best when input is large.
Binary insertion sort uses Binary search to insert a new value in a sorted array. Binary search reduces number of comparisons thus more efficient than linear search.
In above example, Binary insertion sort requires 2 iteration to find location to insert 8 whereas linear search would find location in 4th iteration.
N : Number of elements inside input array.
If N <= 64 then Tim sort uses binary insertion sort to sort the elements and doesn’t go in fancy details.
What if N is large
An input array is divided into different sub-arrays, count of elements inside a sub-array is defined as a RUN, minimum value of such runs is a MIN_RUN.
A RUN can be either ascending or strictly descending. If elements are decreasing then in place swapping converts them into ascending order, elements that have equal values aren’t swapped to maintain stability
A run smaller than min run is extended to make count equal to min run. Now this new run is sorted using binary insertion sort which has a best run time on partially ordered data. Ultimately, every run should be greater or equal to the min run and it shouldn’t be less than 2.
Why Compute MIN_RUN
MIN_RUN ensures that input array is split in such a way that when merge happens, it happens in a perfectly balanced manner.
Let’s understand it with an example below-:
In left diagram above, we have 4 sub-arrays of size 2 which perform perfectly balanced merge at each step. In right diagram, we have 5 sub-arrays of size 2 which doesn’t allow perfect balanced merge to happen.
Perfectly balanced merge allows one on one comparisons between items. An unbalanced merge can cause extra comparisons and impacts performance.
Ideally, Timsort wants value of min run to be such that N / MIN_RUN equals to power of 2 or close to it so that when merge happens it gets a perfectly balanced merge for example When an input array has 256 elements Tim Sort would like to divide array into equal sized sub-arrays. 256 / 32 will give us 8 equal sized sub-arrays that perform perfectly balanced merge.
Merging
At this point an input array has been divided into different sub-arrays and now they should be merged back to produce final sorted array. Unlike merge sort, Tim sort uses stack to store recent runs.
Timsort tries to delay merging as long as possible in order to exploit patterns that come up later but at the same time it likes to merge as soon as possible because all the unmerged arrays are stored inside stacks and storing consumes memory which could hurt for a large array.
If we consider three sub-arrays A, B and C from left to right then Tim sort complies with below 2 variants to call merge_collapse() function to decide whether current run should be merged with preceding runs or not.
Merging two sub-arrays in place efficiently is very difficult and slow but if we have a temporary array this process can be faster and easier to implement. Tim sort uses temp array to perform merge between two arrays.
Galloping
Galloping: (of a process or time) progress rapidly in a seemingly uncontrollable manner.
Galloping is another technique used by Tim sort to further reduce comparisons while merging in order to increase efficiency of algorithm.
While merging two sub arrays in a sorted manner Tim sort perform galloping. Galloping improves merging runtime by reducing comparisons. Java uses constant value ‘7’ before it switches to Gallop mode. Galloping utilizes binary search to make less comparisons during merge procedure.
In below example, 101 is searched inside array A for 7 times and every time array B wins after 7th time Gallop mode is switched on which forces binary search for 101 inside A.
Now we compare 101 directly with A[mid] = 50 thus save lot of comparisons.
References
Conclusions
This was definitely one of the difficult post to write because of lack of resources to read about Tim sort. I am personally highly impressed by different optimization techniques used to achieve fast results in Tim sort.
Алгоритм сортировки Timsort
Для сортировки в CPython используется алгоритм Timsort, который его создатель Тим Петерс застенчиво назвал в честь себя. Timsort — это комбинация сортировки вставками и сортировки слиянием, заточенная под работу с реальными данными. Дело в том, что на практике массивы, которые нужно сортировать, часто бывают частично упорядочены и Timsort пользуется этим предположением для ускорения работы.
Логика работы Timsort на самом деле довольно прозрачная:
- Timsort делит входной массив на подмассивы;
- сортирует подмассивы вставками;
- объединяет их попарно сортировкой слиянием;
- и возвращает отсортированный массив.
Но дьявол кроется в деталях.
Делим на подмассивы
Части, на которые алгоритм делит входной массив, в описании алгоритма автор называет run’ами. Так на какое количество run’ов следует разделить входной массив? Здесь два соображения. Во-первых, части должны быть достаточно короткими, чтобы их было выгодно сортировать вставками. А еще мы хотим, чтобы пары последовательностей, которые позже поступят в сортировку слиянием, были примерно одинаковой длины. Дальше происходит магия, которая учитывает эти соображения и выбирает длину подпоследовательности minrun между 32 и 64 элементами. При этом если входной массив короче 64 элементов, то на части он не делится.
Сортируем run’ы
Перед тем, как приступить к сортировке подмассива, алгоритм ищет изначально упорядоченные участки. Если они слишком короткие и не дотягивают до минимального размера, то алгоритм удлинняет их бинарной сортировкой (http://www.geneffects.com/briarskin/theory/binary/index.html). Бинарная сортировка — это разновидность сортировки вставками, которая помещает элементы на свои места, используя двоичный поиск. Сортировки вставками как раз эффективны в случаях небольших частично упорядоченных массивов. Сам Петерс пишет, что это лучшее, что можно было выбрать, учитывая ограничения более утонченных алгоритмов.
Сливаем подмассивы
По мере того, как упорядоченные run’ы формируются, сортировкой слияния они объединяются попарно во всё более крупные отсортированные куски. При этом, если алгоритм при слиянии последовательностей встречает два участка вида
то по понятным причинам может объединить их быстрее, чем поэлементным перебором. Эта модификация сортировки называется galloping, поскольку в этом режиме алгоритм переносит на новое место не один элемент, а сразу несколько. Досортировки и слияния повторяются до тех пор, пока не достигается полная упорядоченность входного массива.
Вывод
Объем алгоритма в исходнике примерно 2к строк и, как можно догадаться по описанию, код довольно запутанный. Зато за счет использования упорядоченности в реальных данных сложность Timsort в лучшем случае линейная. В худшем случае, если входные данные случайные, timsort справится за O(n log n), а это неплохо для сортировки. Кстати, несмотря на то, что Timsort изначально был придуман в Python-сообществе, сейчас он используется еще в Java, Swift и Android platform.
What is Timsort?
Many candidates are rejected or down-leveled in technical interviews due to poor performance in behavioral or cultural fit interviews. Ace your interviews with this free course, where you will practice confidently tackling behavioral interview questions.
Overview
Timsort is a hybrid sorting algorithm. It is used to give optimal results while dealing with real-world data.
Timsort has been derived from Insertion Sort and Binary Merge Sort. At first, the array is stored into smaller chunks of data known as runs. These runs are sorted using insertion sort and then merged using the merge sort.
Algorithm
Step 1: The array is broken down into runs.
Preferably, the size of the run (minrun) should be such that (n/minrun) is a power of 2 (since merge sort gives optimal results in that case).
Step 2: Initialize the size of the run as 32 or 64.
Step 3: Sort every run using insertion sort. If the array size is smaller than 64, then it is just sorted using insertion sort.
Step 4: Merge all the runs one by one using merge sort.
Step 5: After every iteration, double the size of the merged sub-array.
Visual representation
Here is a visual representation of the Timsort. For the sake of simplicity, the minrun is of length 4.
Timsort — самый быстрый алгоритм сортировки, о котором вы никогда не слышали
Timsort: Очень быстрый, O(n log n), стабильный алгоритм сортировки, созданный для реального мира, а не для академических целей.
Timsort — это алгоритм сортировки, который эффективен для реальных данных, а не создан в академической лаборатории. Tim Peters создал Timsort для Python в 2001 году.
Timsort сначала анализирует список, который он пытается отсортировать, и на его основе выбирает наилучший подход. С момента его появления он используется в качестве алгоритма сортировки по умолчанию в Python, Java, платформе Android и GNU Octave.
Нотация Big O для Timsort — это O(n log n). Чтобы узнать о нотации Big O, прочтите это.
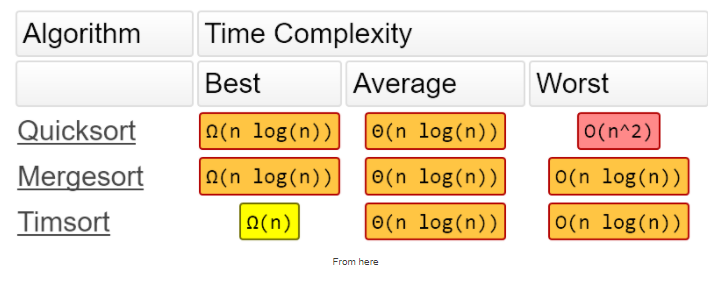
Время сортировки Timsort такое же, как и у Mergesort, что быстрее, чем у большинства других известных сортировок. Timsort фактически использует сортировку вставкой как и Mergesort. Вы это скоро увидите.
Peters разработал Timsort для использования уже упорядоченных элементов, которые существуют в большинстве реальных наборов данных. Он называет эти упорядоченные элементы «natural runs» (естественные пробеги). Они итеративно перебирают данные, собирая элементы в пробеги и одновременно объединяя несколько этих пробегов в один.

Если массив (array), который мы пытаемся отсортировать, содержит менее 64 элементов, Timsort выполняет сортировку вставкой.
Сортировка вставкой — это простая сортировка, которая наиболее эффективна для небольших списков. Она функционирует довольно медленно при работе с большими списками, но при этом быстро работает с маленькими списками. Идея сортировки вставкой заключается в следующем:
Просматривать элементы по одному
Построить отсортированный список, вставляя элемент в нужное место
Вот таблица, показывающая, как сортировка вставкой сортирует список [34, 10, 64, 51, 32, 21].
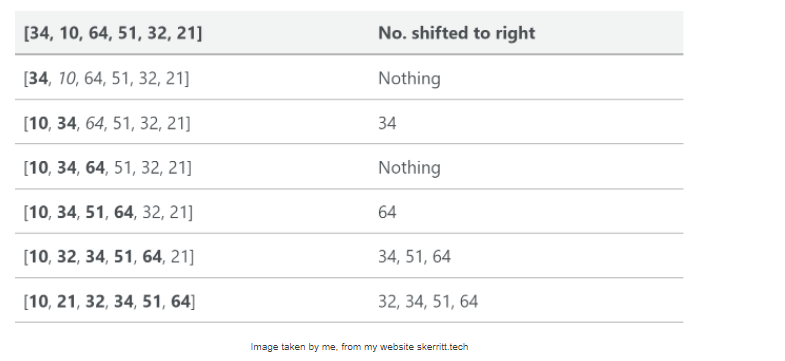
В данном случае мы вставляем только что отсортированные элементы в новый подмассив (sub-array), который начинается от начала массива.
Вот gif, показывающий сортировку вставкой:
Больше о пробегах
Если список больше 64 элементов, то алгоритм сделает первый проход (pass) по списку в поисках частей, которые строго возрастают или убывают. Если какая-либо часть является убывающей, то она будет изменена.
Таким образом, если пробег уменьшается, он будет выглядеть следующим образом (пробег выделен жирным шрифтом):
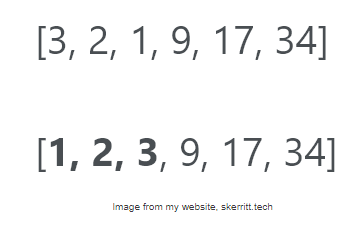
Если не происходит уменьшение, то это будет выглядеть следующим образом:
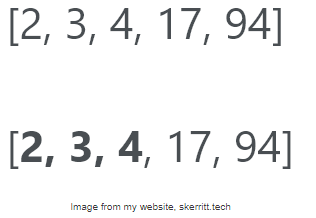
Minrun — это размер, который определяется на основе размера массива. Алгоритм выбирает его таким образом, чтобы большинство пробегов в произвольном массиве были или становились длиной minrun. Слияние двух массивов более эффективно, когда число пробегов равно или чуть меньше степени числа 2. Timsort выбирает minrun, чтобы попытаться обеспечить эту эффективность, убедившись, что minrun равен или меньше степени числа 2.
Алгоритм выбирает minrun из диапазона от 32 до 64 включительно, таким образом, чтобы длина исходного массива при расчете была меньше или равна степени числа 2.
Если длина пробега меньше minrun, необходимо рассчитать длину этого пробега относительно minrun. Используя это новое число выполняется сортировка вставкой для создания нового пробега.
Итак, если minrun равен 63, а длина пробега равна 33, вы выполняете вычитание: 63-33 = 30. Затем вы берете 30 элементов из run[33], и делаете сортировку вставкой для создания нового пробега.
После завершения этой части должно появиться множество отсортированных пробегов в списке.
Слияние
Теперь Timsort использует сортировку слиянием, чтобы объединить пробеги. Однако Timsort следит за тем, чтобы сохранить стабильность и баланс слияния во время сортировки.
Для поддержания стабильности мы не должны менять местами два одинаковых числа. Это не только сохраняет их исходные позиции в списке, но и позволяет алгоритму работать быстрее. В ближайшее время мы обсудим баланс слияния.
Когда Timsort находит пробеги, он добавляет их в стек. Простой стек выглядит следующим образом:
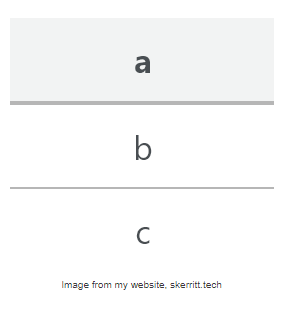
Представьте себе стопку тарелок. Вы не можете взять тарелки снизу, поэтому вам приходится брать их сверху. То же самое можно сказать и о стеке.
Timsort пытается сбалансировать две конкурирующие задачи при сортировке слиянием. С одной стороны, мы хотели бы отложить слияние на как можно дольше, чтобы использовать паттерны, которые могут появиться позже, но еще больше нам хотелось бы произвести слияние как можно быстрее, чтобы воспользоваться тем, что только что найденный пробег все еще находится наверху в иерархии памяти. Мы также не можем откладывать слияние «слишком надолго», потому что на запоминание еще не объединенных пробегов расходуется память, а стек имеет фиксированный размер.
Чтобы добиться компромисса, Timsort отслеживает три последних элемента в стеке и создает два правила, которые должны выполняться для этих элементов:
Где A, B и C — три самых последних элемента в стеке.
По словам Tim Peters:
Хорошим компромиссом оказалось то, что сохраняет два варианта для записей в стеке, где A, B и C — длины трех самых правых еще не объединенных частей.
Обычно объединить соседние пробеги разной длины очень сложно. Еще сложнее то, что мы должны поддерживать стабильность. Чтобы обойти эту проблему, Timsort выделяет временную память. Он помещает меньший (называя оба пробега A и B) из двух побегов в эту временную память.
Galloping*
*Модификация процедуры слияния подмассивов
Пока Timsort объединяет A и B, обнаруживается, что один пробег «выигрывает» много раз подряд. Если бы оказалось, что A состоял из гораздо меньших чисел, чем B, то A оказался бы на прежнем месте. Слияние этих двух пробегов потребовало бы много работы c нулевым результатом.
Чаще всего данные имеют некоторую уже существующую внутреннюю структуру. Timsort предполагает, что если многие значения пробега A меньше, чем значения пробега B, то, скорее всего, A будет и дальше содержать меньшие значения, чем B.
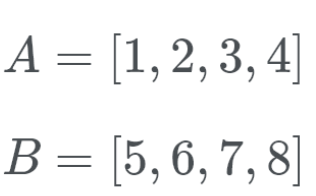
Затем Timsort переходит в режим galloping. Вместо того чтобы сверять A[0] и B[0] друг с другом, Timsort выполняет бинарный поиск соответствующей позиции b[0] в a[0]. Таким образом, Timsort может полностью переместить A. Затем Timsort ищет соответствующее местоположение A[0] в B. После этого Timsort также может полностью перемещает B.
Давайте посмотрим на это в действии. Timsort проверяет B[0] (который равен 5) и, используя бинарный поиск, ищет соответствующее место в A.
Итак, B[0] находится в конце списка A. Теперь Timsort проверяет A[0] (который равен 1) в правильном месте B. Итак, мы ищем, где находится число 1. Это число находится в начале B. Теперь мы знаем, что B находится в конце A, а A — в начале B.
Оказывается, что действие не имеет смысла, если подходящее место для B[0] находится очень близко к началу A (или наоборот), поэтому режим gallop быстро завершается, если он не приносит результатов. Кроме того, Timsort принимает это к сведению и усложняет вход в режим gallop, увеличивая количество последовательных «побед» только в A или только в B. Если режим gallop приносит результаты, Timsort облегчает его повторный запуск.
Если говорить коротко, Timsort делает две вещи невероятно хорошо:
Обеспечивает высокую производительность при работе с массивами с уже существующей внутренней структурой
Создает возможность поддерживать стабильную сортировку
А раньше, чтобы добиться стабильной сортировки, вам нужно было сжать элементы списка в целые числа и отсортировать его как массив кортежей.
Если вас не интересует код, смело пропускайте эту часть. Под этим разделом есть дополнительная информация.
Если вы хотите увидеть оригинальный исходный код Timsort во всей его красе, посмотрите его здесь. Timsort официально реализован на C, а не на Python.
Timsort фактически встроен прямо в Python, поэтому этот код служит только в качестве пояснения. Чтобы использовать Timsort, просто напишите следующее:
Если вы хотите узнать, как работает Timsort, и понять его суть, я настоятельно рекомендую вам попробовать применить его самостоятельно!
Эта статья основана на оригинальном вступлении Tim Peters к Timsort, которое можно найти здесь.
Если вам интересно узнать о курсе больше, приглашаем на день открытых дверей онлайн.