Переход к сортировке вставкой

Большинство алгоритмов, с которыми мы работали, были довольно медленными и кажутся неэффективными. Однако они, как правило, часто встречаются в курсах информатики и теоретических объяснениях, потому что они часто используются как наивный подход или простейшая реализация сортировки коллекции.
Сегодняшний алгоритм сортировки ничем не отличается. На самом деле некоторые люди считают эту методологию сортировки одной из самых интуитивно понятных. Мы собираемся взглянуть на сортировку вставкой, с которой вы, возможно, уже знакомы и, возможно, уже использовали в какой-то момент своей жизни. Сортировка вставкой интересна тем, что, хотя она не самая эффективная, она всегда используется в учебниках и лекциях по CS.
Это связано с тем, что сортировка вставкой — один из самых простых для понимания алгоритмов сортировки. На самом деле, довольно часто возникает пример сортировки карт на руке — возможно, вы даже не осознавали этого, но в последний раз, когда у вас была куча игральных карт в руке, есть большая вероятность, что вы использовали какая-то версия алгоритма вставки сортировки для сортировки карт в вашей руке!
Давайте немного приблизимся к этому алгоритму и разберемся, в чем он заключается.
Проверка сортировки вставок
На самом базовом уровне алгоритм сортировки вставкой содержит логику перемещения и вставки элементов для сортировки неупорядоченного списка любого размера. Однако способ вставки элементов делает сортировку вставкой такой интересной!
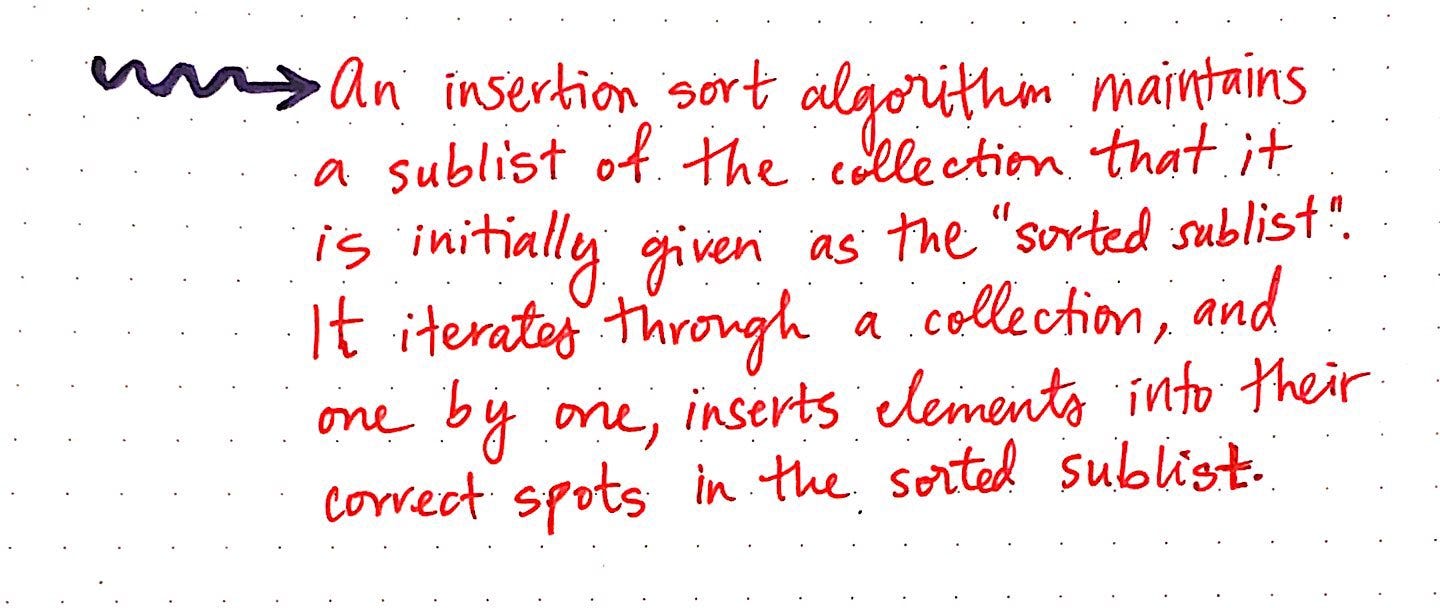
Алгоритм сортировки вставкой имеет два основных аспекта. Первый важный аспект связан с его структурой.
Алгоритм сортировки вставкой поддерживает два подмножества (часто называемых подразделами или подсписками) — отсортированное подмножество и несортированное подмножество.
Второй аспект связан с тем, как он выполняет итерацию и сортирует заданную коллекцию элементов. Сортировка вставкой будет перебирать несортированное подмножество, эффективно «удаляя» его из несортированного подмножества и впоследствии «вставляя» в его правильное отсортированное место в отсортированном подмножестве.
Давайте посмотрим, как это работает на самом деле:
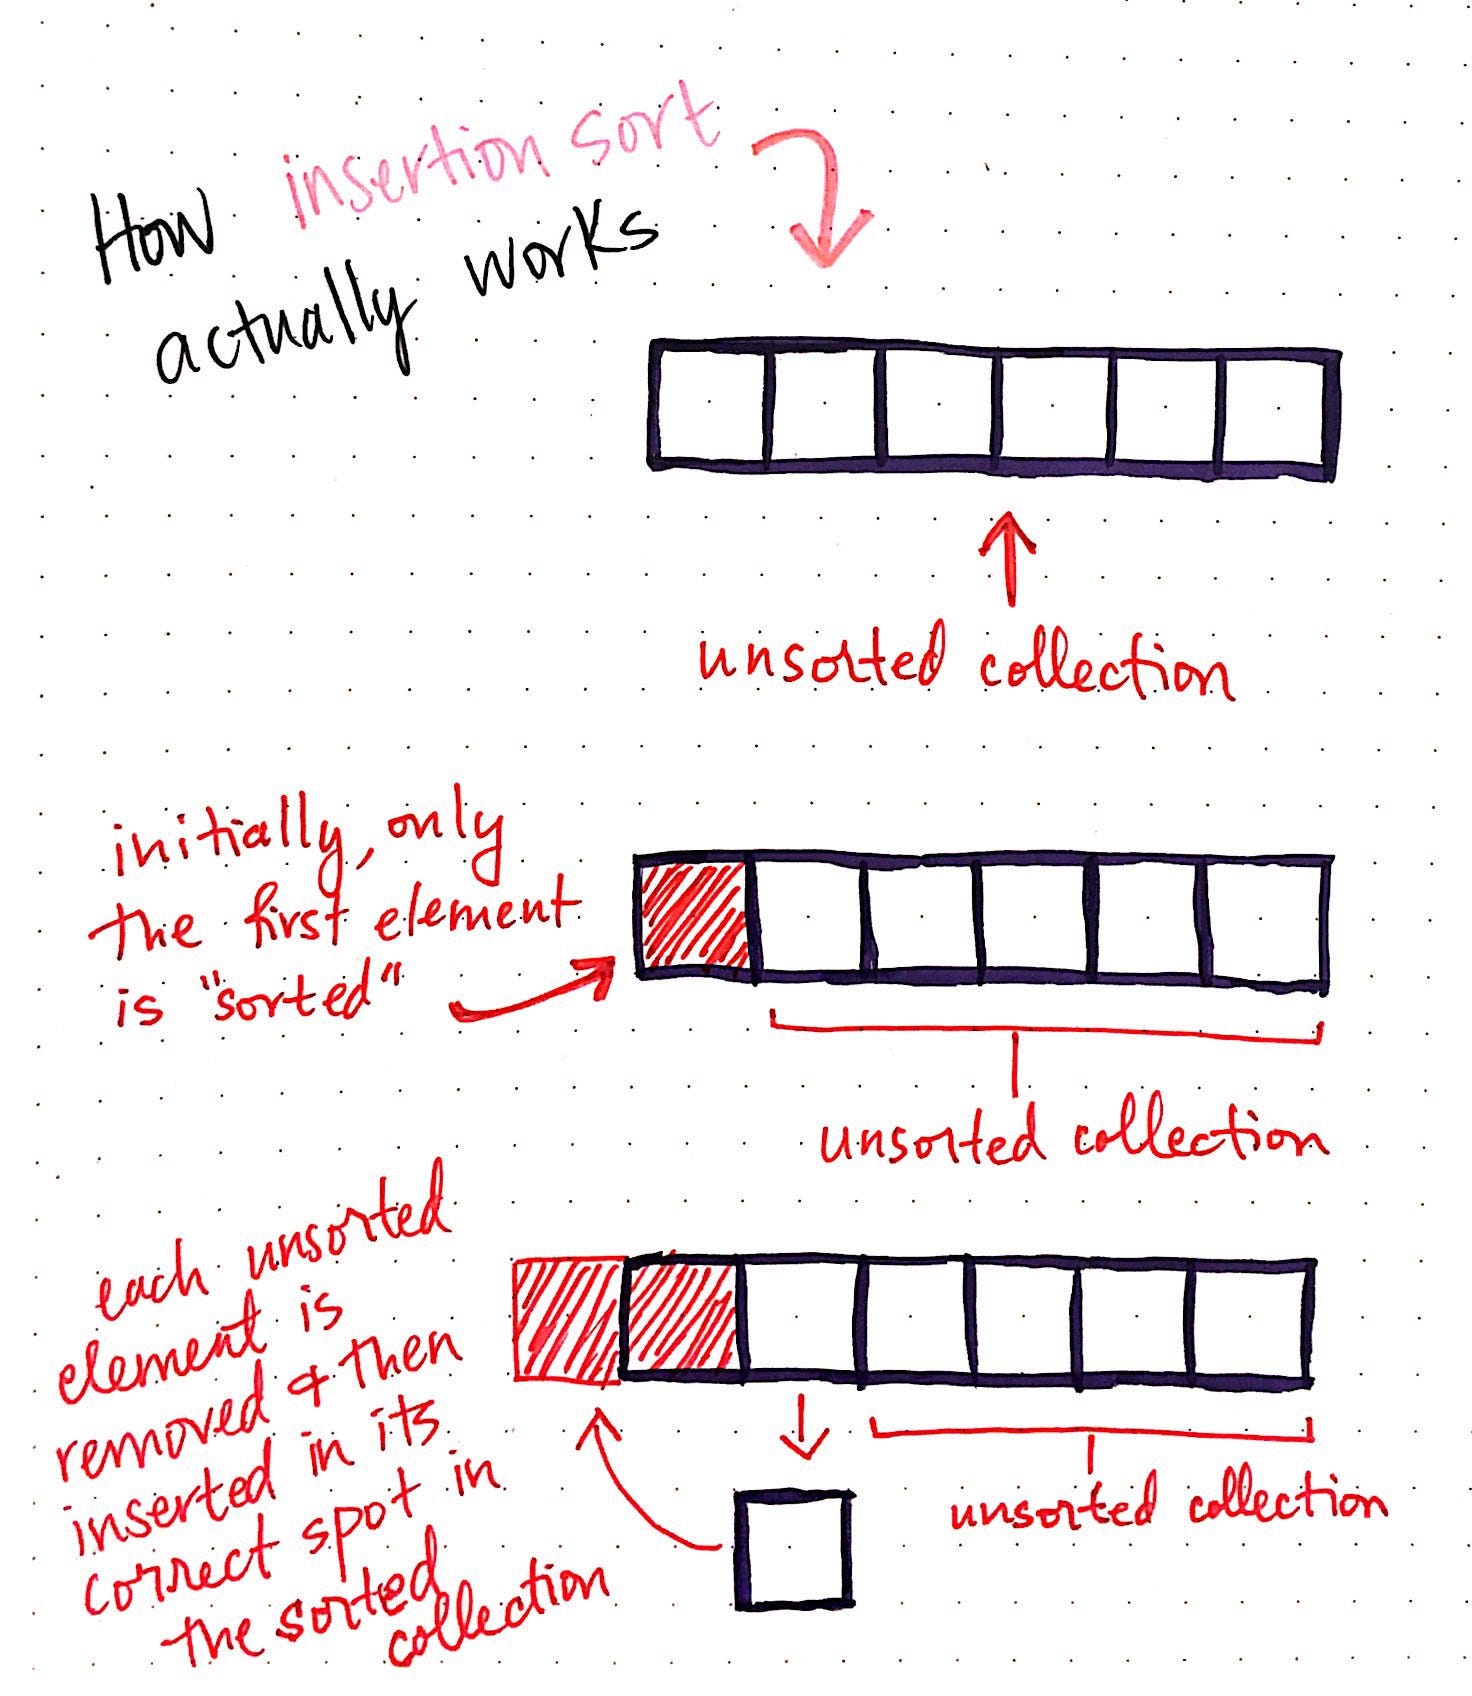
В приведенном выше примере мы начинаем с несортированной коллекции. Мы можем думать об этом как о нашей карточной руке, которая в настоящее время находится в большом беспорядке и нуждается в сортировке. Мы возьмем первый элемент и начнем сортировку на основе этого элемента. Другими словами, наш первый элемент — это первый элемент, который мы «сортируем». Теперь это дает нам две отдельные коллекции: отсортированную коллекцию и несортированную коллекцию.
Затем мы удалим первый неотсортированный элемент и добавим его в нашу отсортированную коллекцию. Чтобы выяснить, куда поместить этот новый элемент, нам нужно сравнить его с единственным элементом в нашей отсортированной коллекции; если элемент, который мы добавляем, больше, чем наш единственный отсортированный элемент, мы сохраним его в том же месте, где он сейчас находится, и пометим его как отсортированный. Однако в этом примере новый элемент меньше, чем наш единственный отсортированный элемент, мы переместим этот элемент обратно в первую позицию в коллекции и переместим отсортированный элемент вперед в коллекции, чтобы освободить для него место.
Это делает единственную итерацию сортировки вставкой. Очевидно, что список все еще не отсортирован! Нам нужно будет продолжить этот процесс для каждого оставшегося несортированного элемента и повторить те же шаги, пока мы заканчиваем итерацию по списку.
В некотором смысле сортировка вставкой похожа на другой алгоритм, который мы уже исследовали: сортировка по выбору. У обоих этих алгоритмов есть одна общая черта: каждый из них поддерживает концепцию отсортированных элементов и несортированных элементов. Однако каждый из них делает это по-разному. Это гораздо яснее на примере.
Давайте попробуем использовать сортировку вставкой для сортировки списка из шести чисел: 4, -31, 0, 99, 83, 1 .
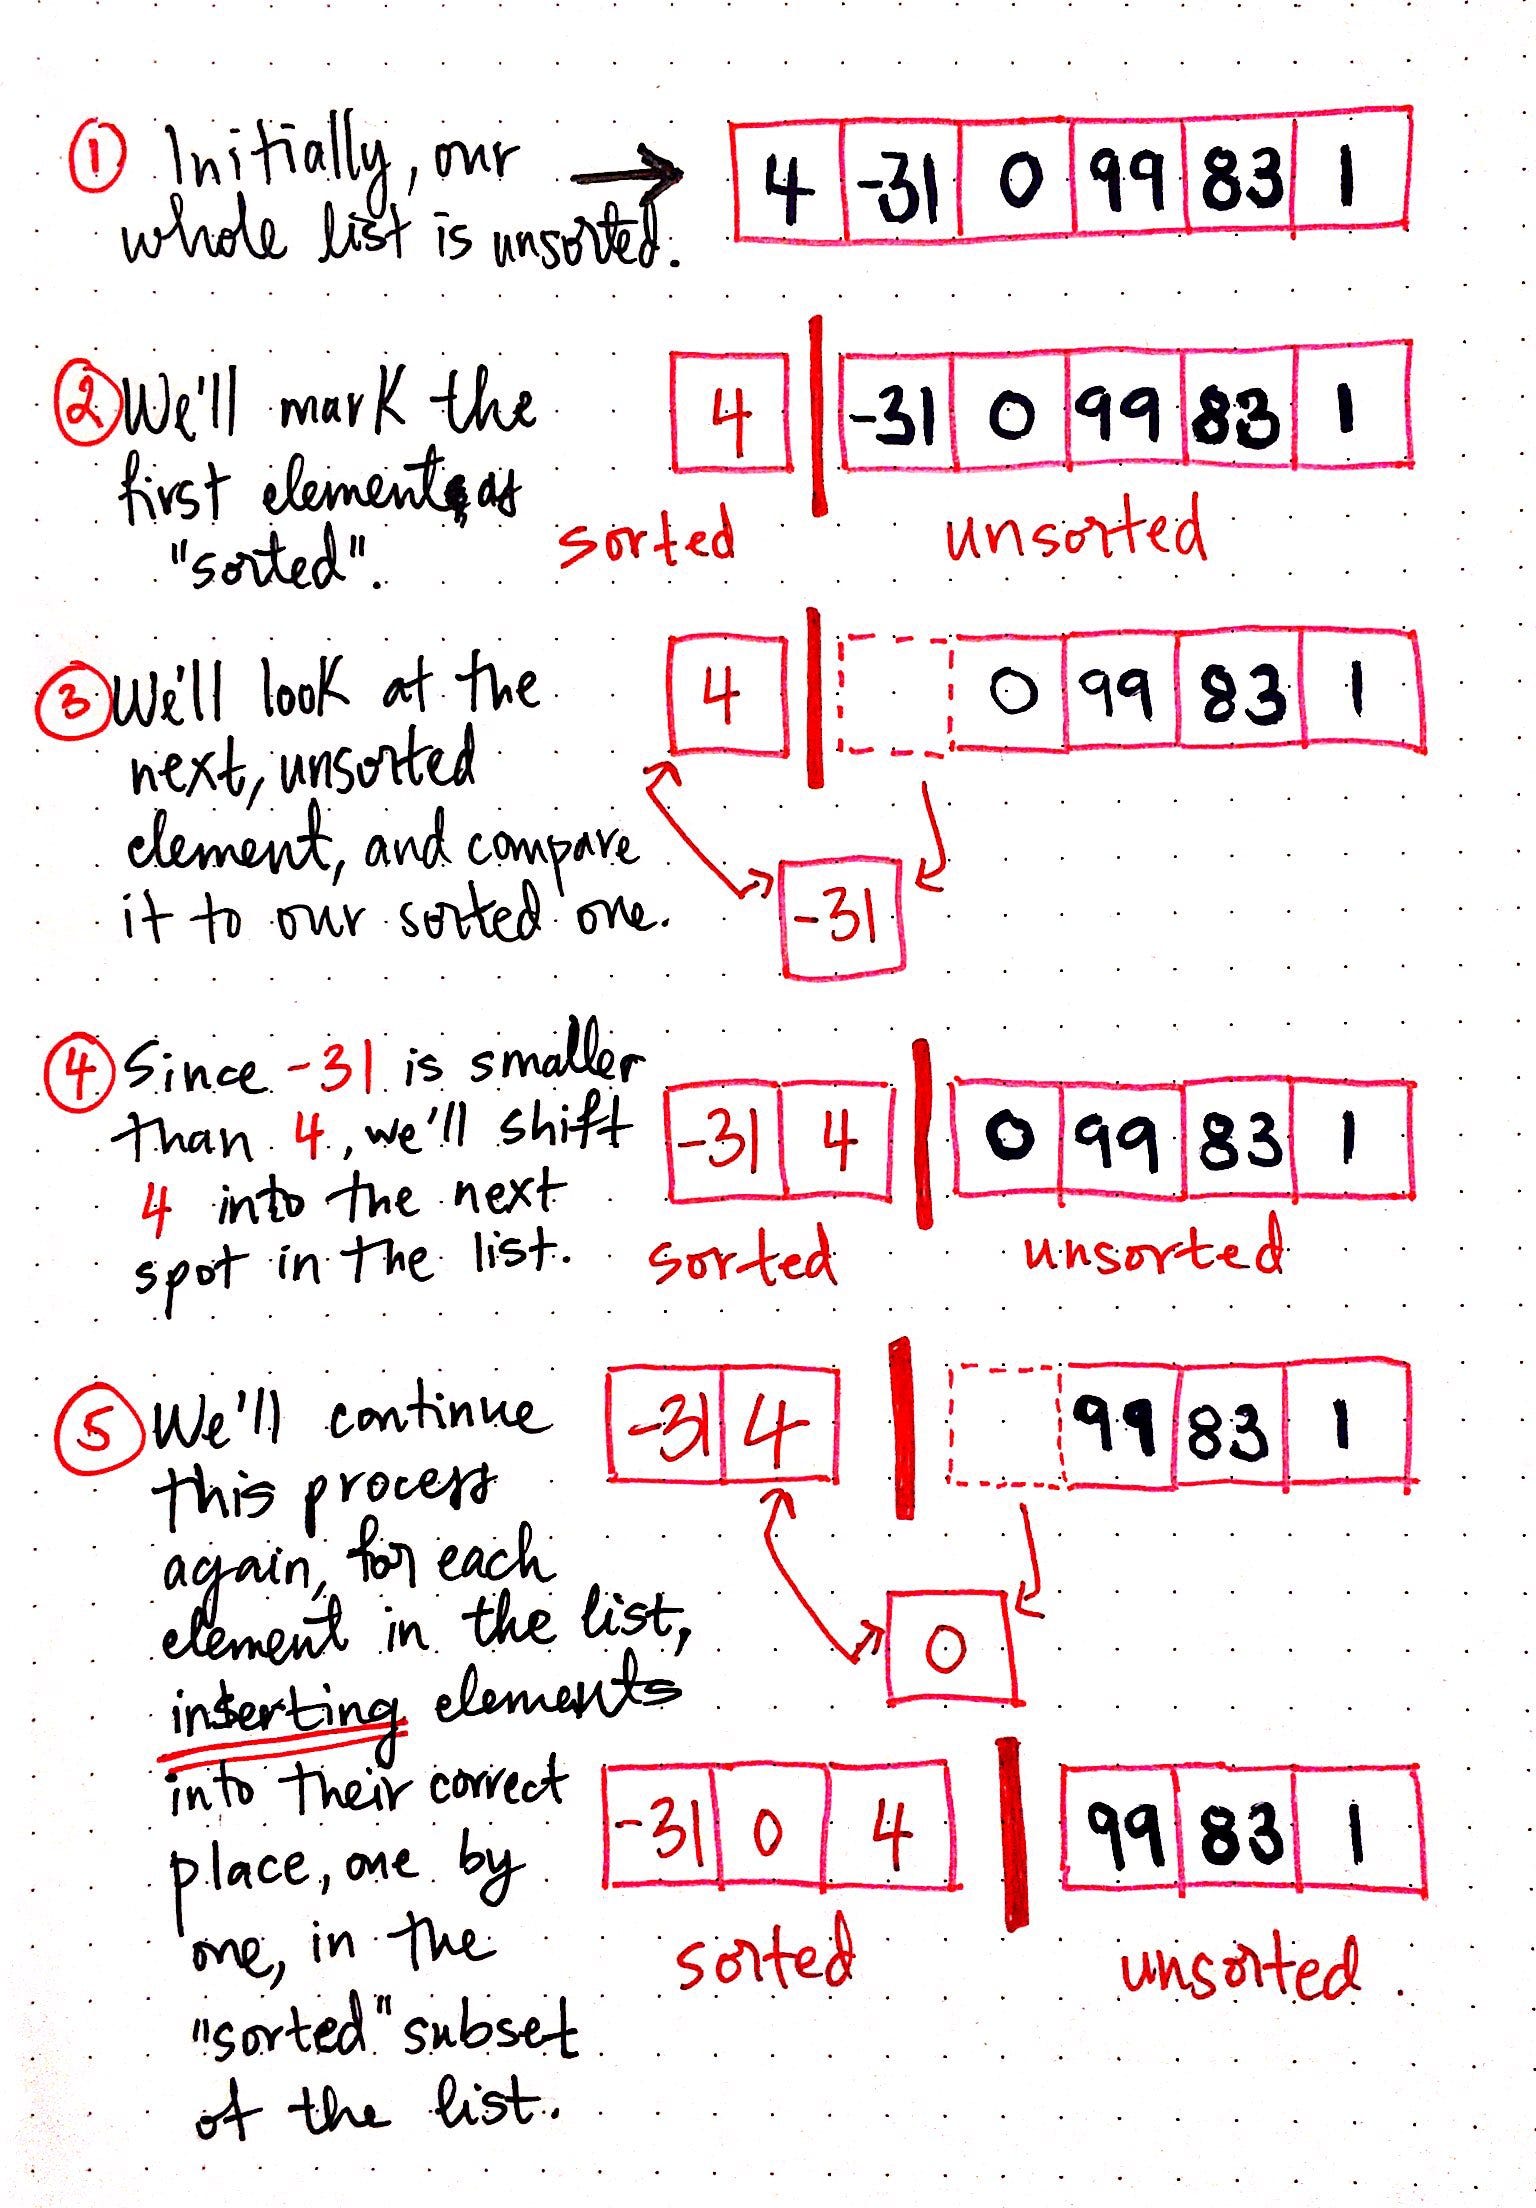
Для начала наш список будет несортированным. Мы уже знаем, что первый элемент будет перемещен в наше «отсортированное» подмножество, что означает, что изначально сортируется только число 4 .
Чтобы упростить просмотр, в этом примере мы будем использовать красную разделительную линию, чтобы обозначить границу между отсортированными и несортированными коллекциями.
Затем извлечем первый несортированный элемент: -31 . Мы хотим добавить его в наше отсортированное подмножество, поэтому нам нужно будет сравнить его со всеми отсортированными элементами (хотя сейчас у нас есть только один!). Поскольку -31 меньше 4 , мы переместим 4 на следующую позицию в списке и переместим -31 на место, где изначально находилось число 4 .
Наш отсортированный список теперь содержит -31 и 4 в правильном отсортированном порядке, как и следовало ожидать. Мы сделаем то же самое для следующего неотсортированного элемента, 0 . Мы удалим его из отсортированного списка, сравним с каждым из отсортированных значений и переместим все элементы большего размера вправо, чтобы освободить место для добавляемого нового элемента.
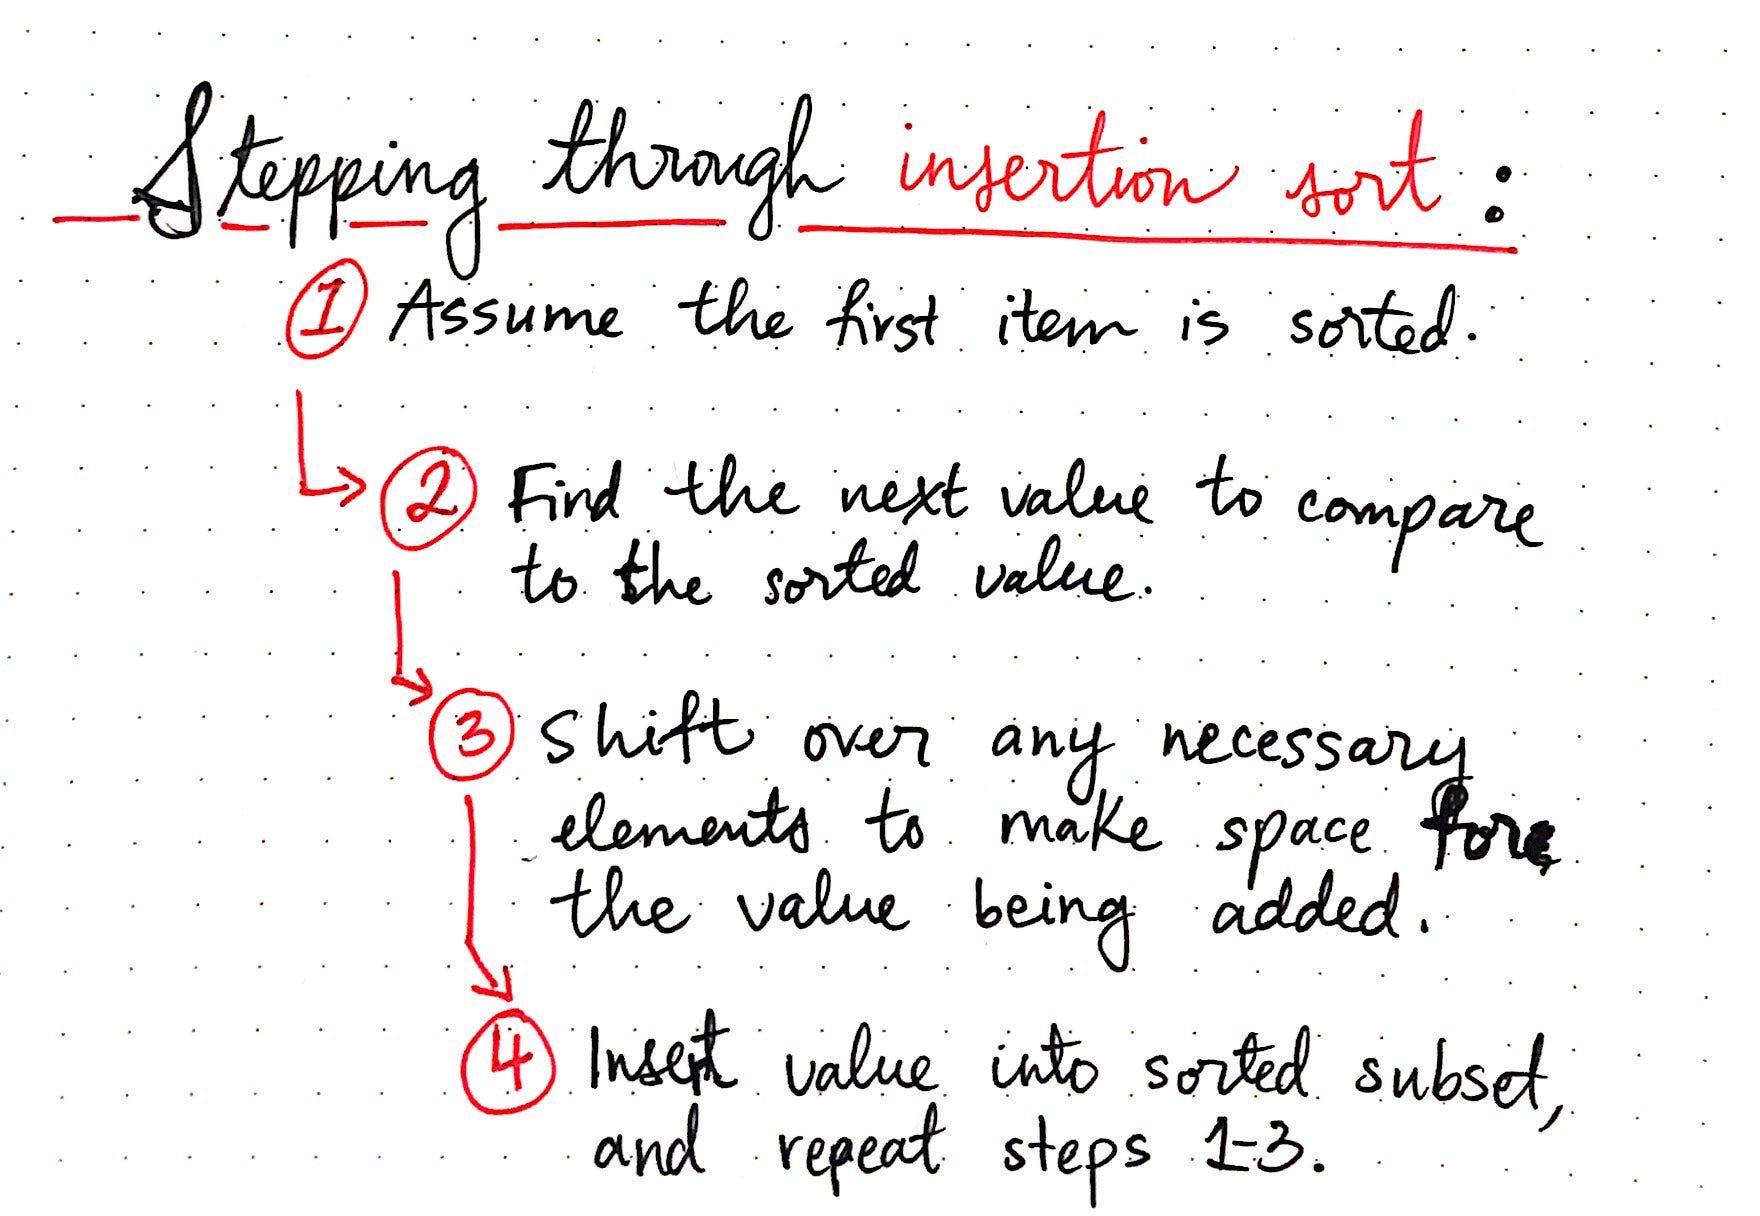
Фактически, как только наш первый элемент помещен в «отсортированное» подмножество, мы продолжаем тот же процесс для каждого отдельного несортированного элемента в «несортированном» подмножестве, пока мы не отсортируем всю коллекцию.
Более глубокая проверка сортировки при вставке
Прежде чем мы перейдем к реализации сортировки вставкой, будет полезно попытаться немного упростить ее, чтобы было немного легче писать код. Мы можем свести этот алгоритм к основным правилам.
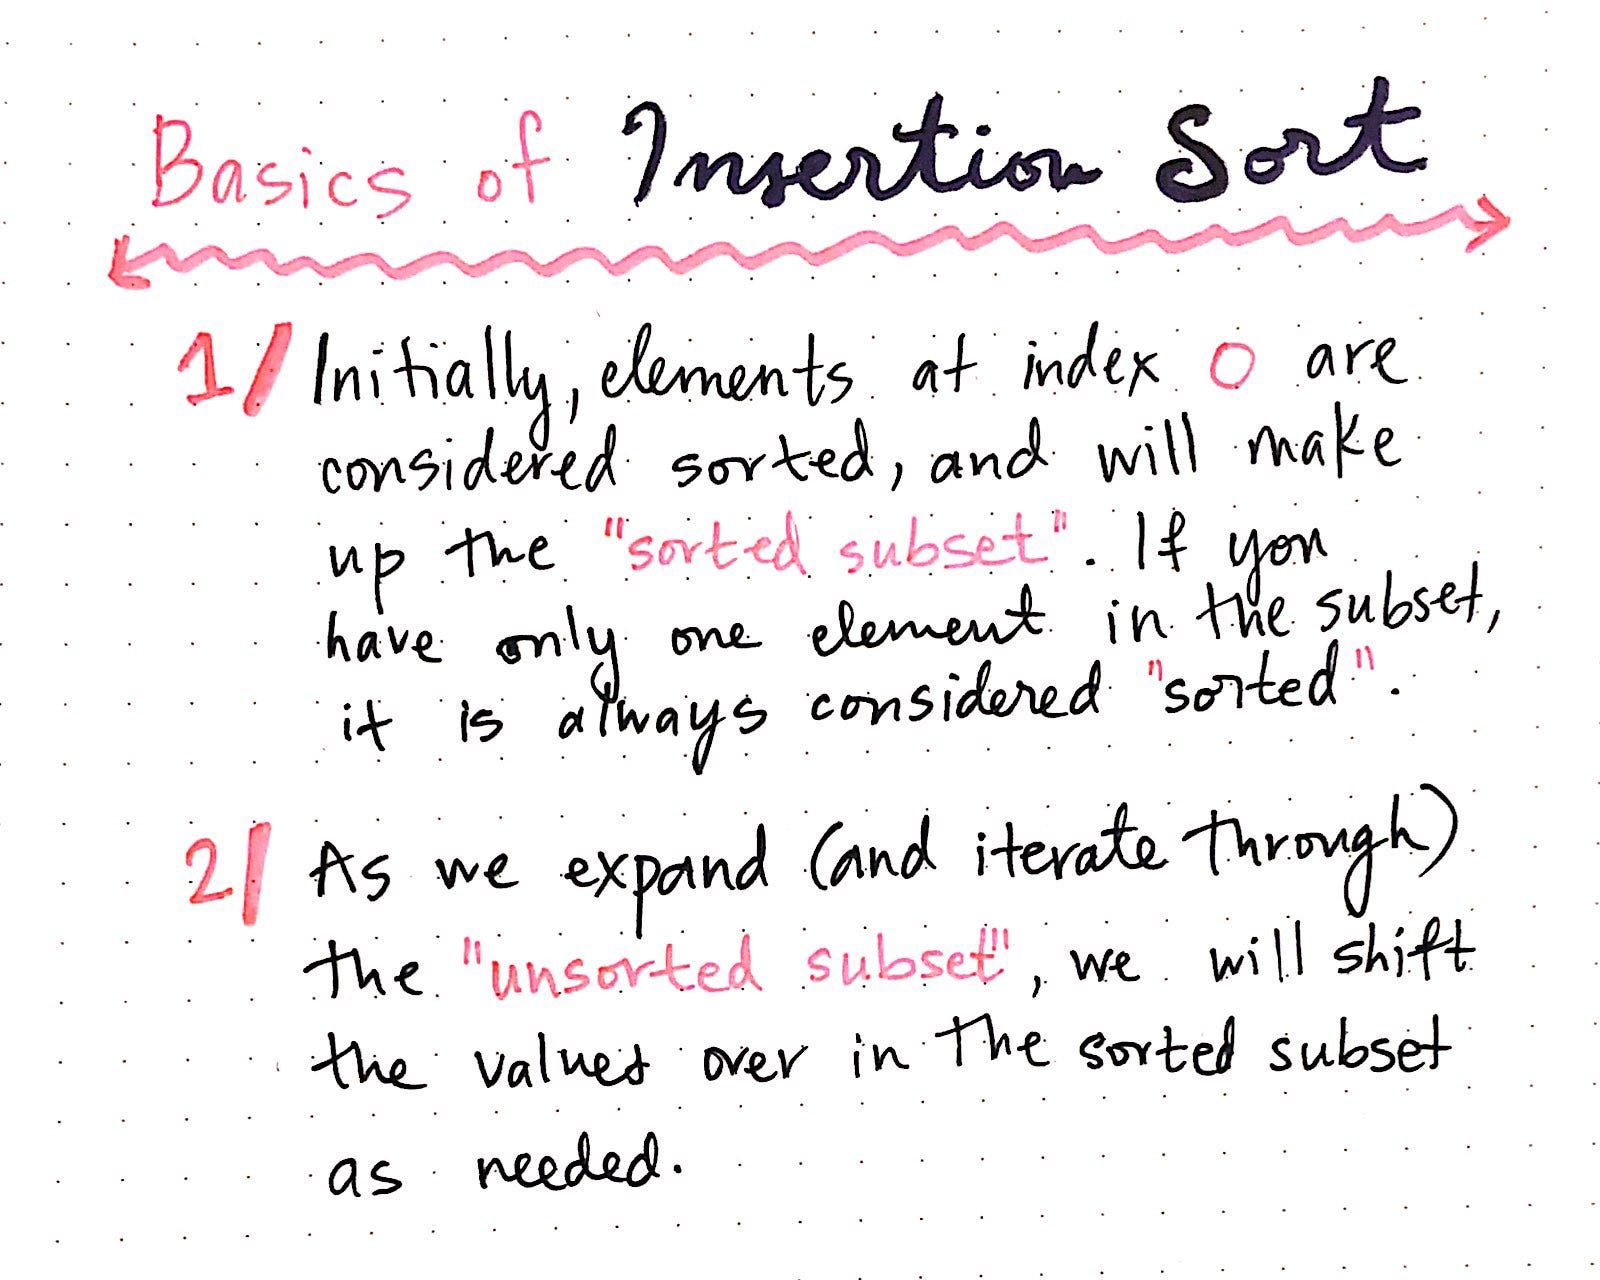
Во-первых, мы должны помнить, что любой элемент, начинающийся с индекса 0 , будет нашим «отсортированным» подмножеством — по крайней мере, изначально. Полезное практическое правило: если у нас есть только один элемент, по определению этот элемент считается отсортированным; если вы задумаетесь, это станет более понятным. Если у вас только один элемент, нет никаких шансов, что что-то будет больше или меньше его, поэтому он отсортирован по умолчанию!
Во-вторых, по мере того, как мы повторяем и расширяем наше «несортированное» подмножество, мы медленно перемещаем элементы в отсортированное подмножество с каждой итерацией. Это означает, что одна итерация сокращает «несортированное» подмножество, удаляя элемент и и добавляя его к «отсортированному» подмножеству.
Другими словами, каждая итерация сортировки вставкой приводит к увеличению отсортированного подмножества и сжатию несортированного подмножества.
Это может пока не иметь большого смысла, и это нормально. На самом деле, я думаю, будет намного проще определить, как это работает, и увидеть его в действии, если мы посмотрим на быструю визуализацию сортировки вставкой:
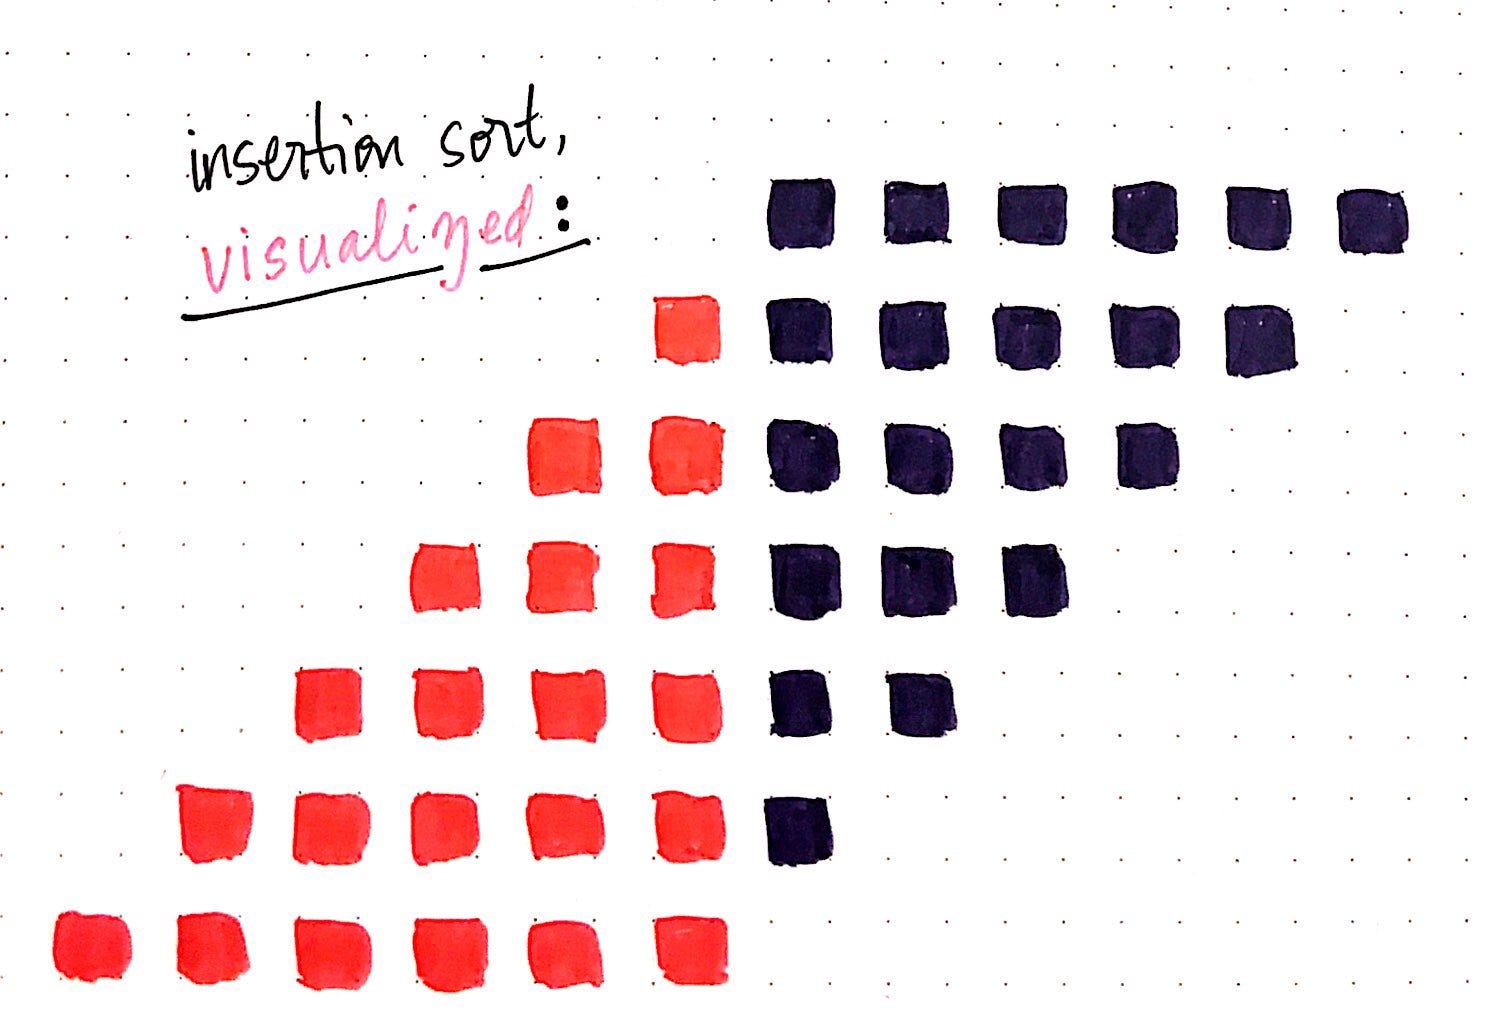
В приведенном выше примере одна строка представляет состояние введенной коллекции для каждой итерации алгоритма сортировки. Надеюсь, что здесь происходит немного более очевидно. В каждой итерации еще один элемент считается «отсортированным», что обозначено красными квадратами. Мы видим, что с каждой итерацией появляется больше красных «отсортированных» элементов и меньше фиолетовых «несортированных» элементов. Количество элементов, конечно же, не меняется — мы просто перемещаемся по одному несортированному элементу на каждой итерации и добавляем его в «отсортированное» подмножество. Обратите внимание на направление, в котором происходит этот поток. Мы вернемся к этому в следующем разделе, но, возможно, вы уже можете увидеть здесь возникающую закономерность!
Хорошо, теперь, когда у нас есть два важных правила, давайте перейдем к хорошему и напишем код! Ниже представлена адаптированная версия вставки в JavaScript, основанная на реализации JS Rosetta Stone. Вот как может выглядеть наш insertionSort алгоритм:
Мы почти сразу заметим, что здесь происходят две петли, которые мы видели несколько раз раньше. Но прежде чем мы рассмотрим это… что еще здесь происходит?
Итак, мы начинаем с обхода входных данных массива и добавления первого элемента с индексом 0 в «отсортированную» часть списка; это происходит в строке 6, когда мы устанавливаем var currentUnsortedItem = array[i]; . На самом деле это не меняет того, как массив выглядит, а просто создает наши «отсортированные» и «несортированные» разделы. Также следует отметить, что для первого элемента / итерации мы никогда не выполняем вложенный цикл в строке 13.
Но как насчет будущих итераций? Самый простой способ увидеть, как работает этот вложенный цикл (и когда он выполняется), — это запустить код. Так что давайте сделаем именно это! Вот как будет выглядеть наш insertionSort алгоритм при вводе [4, -31, 0, 99, 83, 1] :
Прохладный! Мы даже можем видеть, как все эти console.log распечатывают именно то, что происходит в алгоритме, что очень полезно. Наблюдение за реализацией этого кода, мы надеемся, подчеркивает, что мы все еще делаем те же шаги, что и раньше, когда у нас была только псевдокодированная сортировка вставкой:
- Мы перебираем неотсортированные элементы.
- На каждой итерации мы сравниваем первый неотсортированный элемент с каждым отсортированным элементом слева от него, который больше по размеру.
- Если элемент больше, мы перемещаем больший отсортированный элемент в следующую позицию индекса в массиве и вставляем несортированный элемент в предыдущий индекс перемещенного элемента. .
Мы также видим, что для первого элемента в этом массиве — в данном случае числа 4 — мы никогда не перебираем отсортированные элементы, и нет console.log из внутреннего цикла for (как мы и ожидали!).
Но вот мой вопрос: по сравнению с нашей недавней реализацией кода пузырьковой сортировки, здесь исполняемый код для сортировки вставкой не кажется таким плохим. Конечно, здесь проводится много сравнений, но это не кажется таким ужасным, как пузырьковая сортировка. Так что же делает этот алгоритм медленным? Почему именно это неэффективно?
Устранение неэффективности вставки
Поскольку это не первое родео алгоритмов, надеюсь, когда вы увидели эти два вложенных цикла, вы сразу поняли, что это плохие новости для времени работы нашего алгоритма. Из нашего опыта с пузырьковой сортировкой на прошлой неделе и сортировкой по выбору за неделю до этого мы уже знаем, что это дает квадратичное время выполнения, или O (n²) в нотации Big O.
Квадратичное время выполнения, как правило, плохая идея, потому что это означает, что по мере того, как наш ввод удваивается, время, необходимое нашему алгоритму вставки для сортировки нашего ввода, будет четырехкратным. Это не сулит ничего хорошего, если у нас есть большой набор данных, который мы пытаемся отсортировать.
Однако все же стоит посмотреть, зачем нужны эти два вложенных цикла. И, когда дело доходит до сортировки вставкой, эти два цикла особенно интересны, потому что они работают по-настоящему уникальным образом.
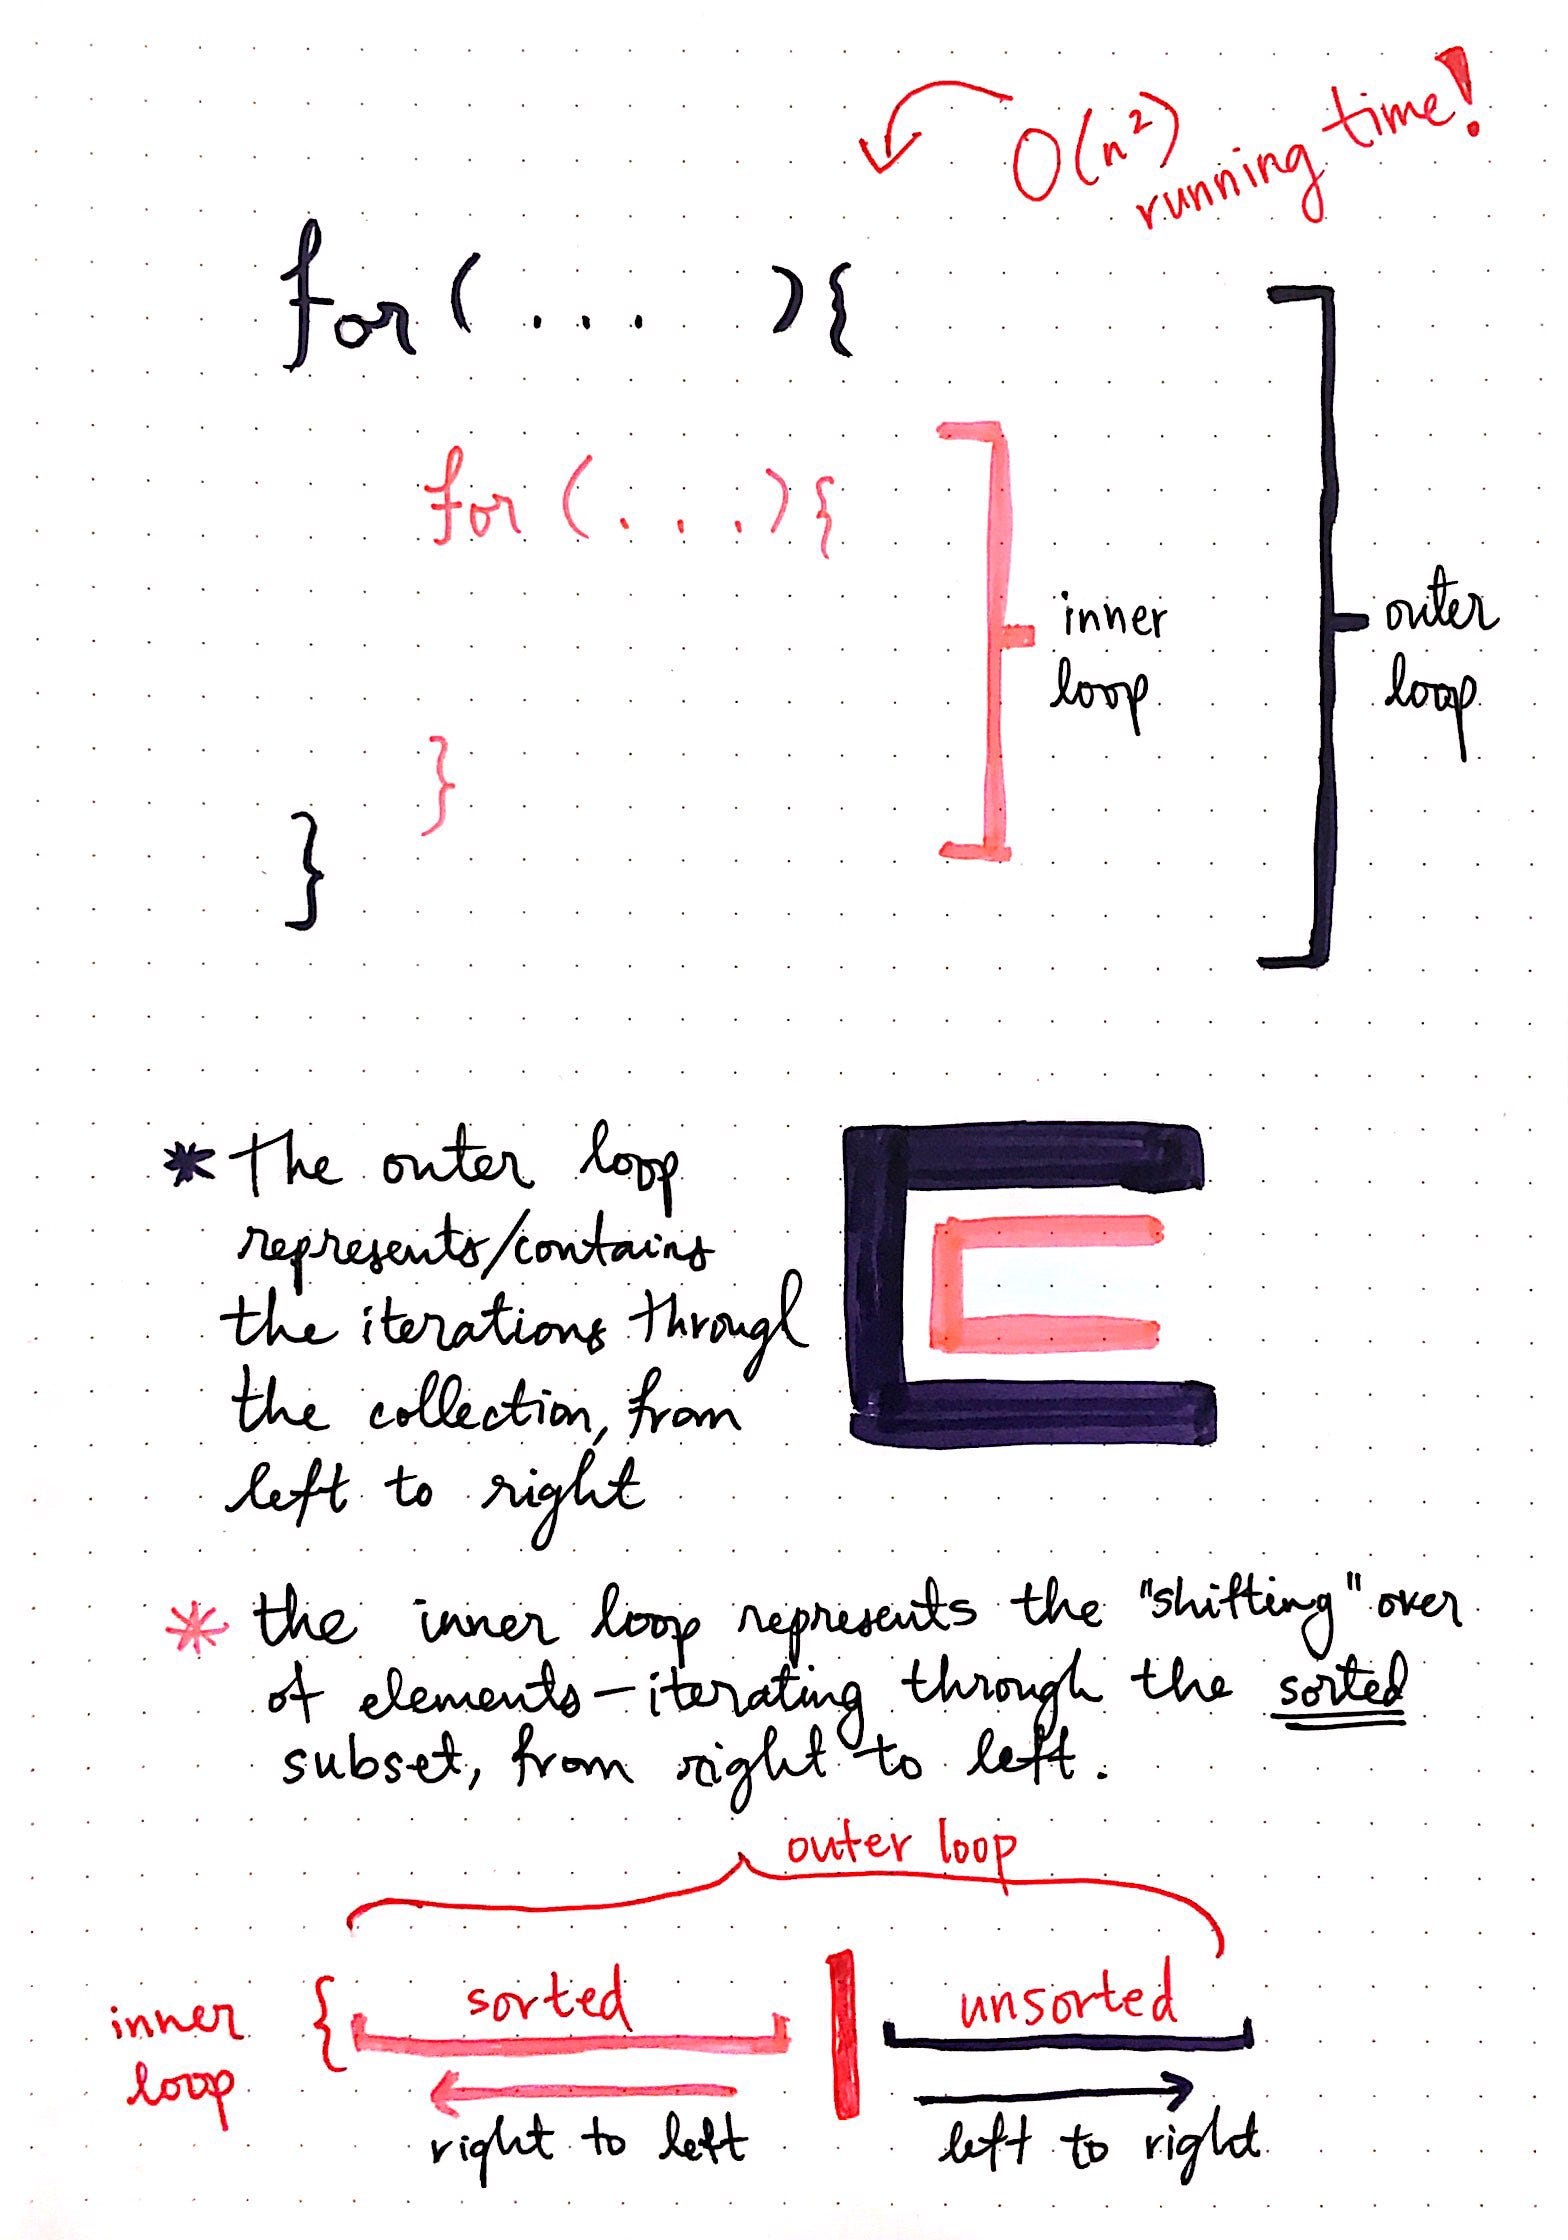
Если мы посмотрим на показанный здесь пример, мы увидим, что визуализируются два цикла: внешний цикл и внутренний цикл.
Внешний цикл — это то место, где мы выполняем итерацию по несортированному списку — каждый отдельный элемент будет повторяться в этом цикле, и мы будем выполнять итерацию слева направо, начиная с первого несортированного элемента слева, который в конечном итоге становится первый отсортированный элемент.
Внутренний цикл представляет собой «переход» элементов. Здесь мы перебираем отсортированные элементы; здесь мы сравниваем несортированный элемент с отсортированными, чтобы решить, где он должен находиться в «отсортированном» подмножестве. Однако, в отличие от внешнего цикла, внутренний цикл будет выполняться только для элементов n-1, где n — общее количество элементов в массиве, поскольку он никогда не выполняется для самый первый элемент в списке. Еще одна вещь, которая отличает внутренний цикл от внешнего, заключается в том, что мы выполняем итерацию справа налево, а не слева направо.
Это имеет смысл, если мы немного подумаем об этом — когда мы реализовали и выполнили наш JavaScript insertionSort , мы сравнили первый неотсортированный элемент с крайним правым отсортированным элементом. Если он был меньше, мы перемещали элементы, а затем продолжали делать то же самое: мы сравнивали наш неотсортированный элемент со следующим самым правым отсортированным. Фактически мы выполняли итерацию снова через отсортированное подмножество.
Именно эта двойная итерация делает сортировку вставкой неэффективным алгоритмом. Однако это также то, что делает этот алгоритм сортировки таким уникальным!
Другой действительно интересной характеристикой этого алгоритма является то, что если он в основном отсортирован, ему больше не нужно делать столько итераций или сравнений во вложенном внутреннем цикле. Это означает, что даже несмотря на то, что в худшем случае время выполнения для сортировки вставкой составляет O (n²), учитывая массив, в котором почти все элементы отсортированы, временная сложность алгоритма существенно изменяется. Фактически, время работы значительно улучшается.
Наилучшее время выполнения алгоритма сортировки вставкой в почти отсортированном списке оказывается линейным — или O (n) — поскольку внутреннему циклу требуется гораздо меньше сравнений.
Конечно, мы обычно не классифицируем и не рассматриваем алгоритмы на основе их лучших сценариев, а скорее на основе наихудших сценариев. Итак, несмотря на этот интересный факт, мы в конечном итоге разбиваем сортировку вставкой как алгоритм с квадратичным временем выполнения.
Какие еще способы мы можем классифицировать алгоритм сортировки вставкой, используя термины, с которыми мы уже знакомы?
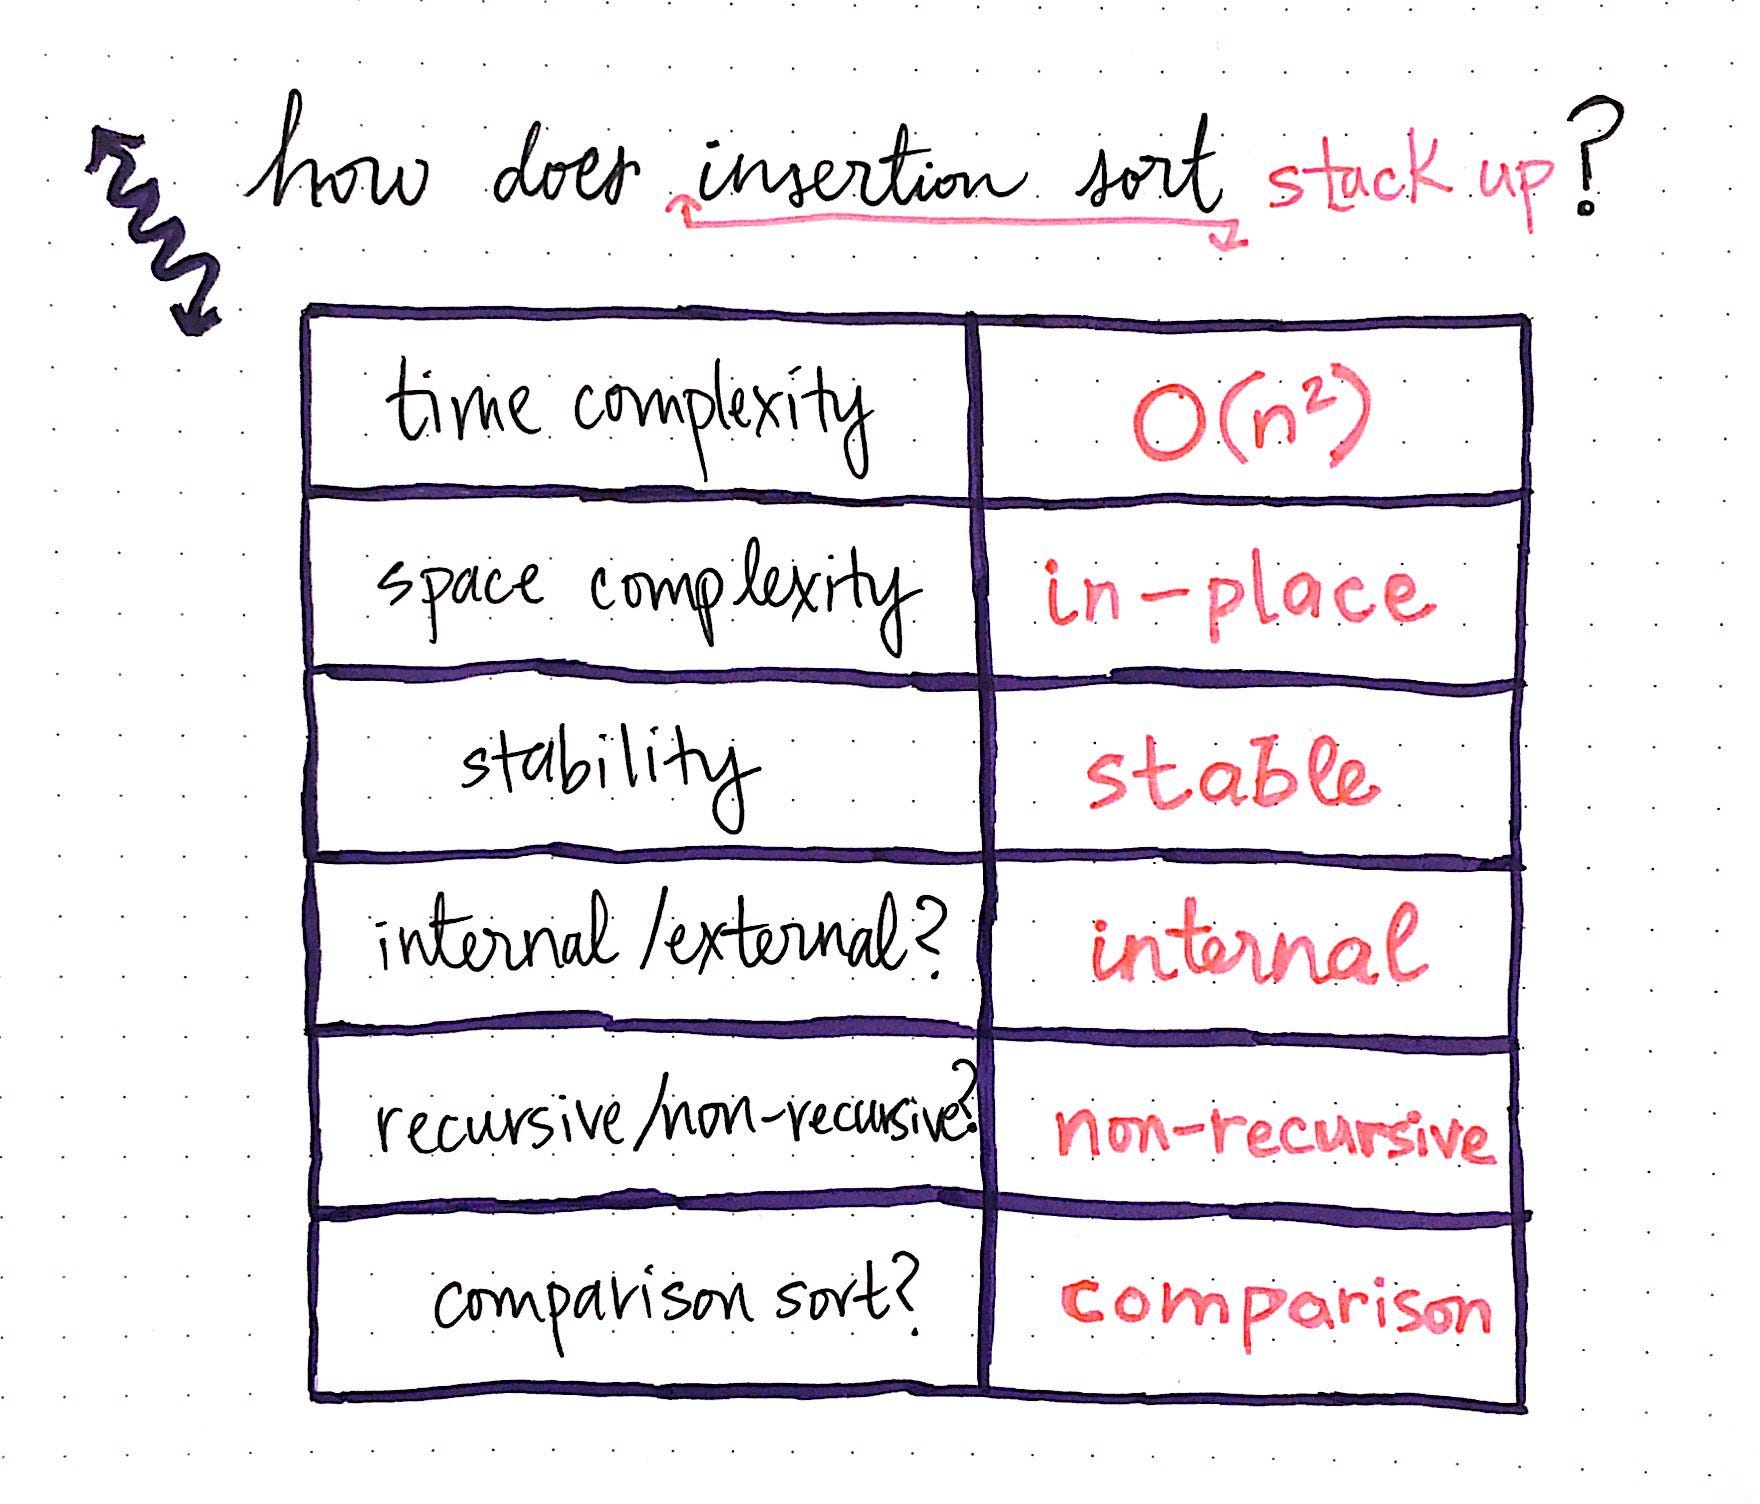
Мы уже знаем, что временная сложность сортировки при вставке квадратична или O (n²). Мы также знаем, что на самом деле для этого не требуется так много дополнительного места — объем пространства, который ему нужен внутри его двух вложенных циклов, является постоянным, или O (1), и в конечном итоге используется для создания ссылок на временные переменные на элементы в определенном индекс в массиве. Так как он работает непосредственно с введенными данными (и не копирует их) и для работы требуется только постоянный объем памяти, сортировку вставкой можно классифицировать как на месте алгоритм сортировки.
Когда алгоритм перебирает несортированные элементы и вставляет их в правильное место в «отсортированном» подмножестве, он выполняет итерацию справа налево. Это означает, что для коллекции с несколькими одинаковыми значениями они будут размещены в отсортированном подмножестве в том же порядке, что и в несортированном подмножестве. Если мы снова посмотрим на код, это станет более очевидным. Поскольку мы используем операторы сравнения (такие как < и > ), если два элемента совпадают, один не будет перемещен перед другим. Вместо этого второй повторяющийся элемент будет просто вставлен справа после первого. Это делает сортировку вставкой стабильным алгоритмом сортировки. Поскольку мы также подтвердили тот факт, что этот алгоритм использует операторы сравнения, мы можем классифицировать его как алгоритм сравнения.
Поскольку мы знаем, что этот алгоритм повторяется (дважды!), Мы знаем, что он итеративный и, следовательно, нерекурсивный по своей природе. Наконец, поскольку сортировка вставкой сохраняет все свои данные в основной памяти и не требует какой-либо внешней памяти, ее можно отнести к категории внутреннего алгоритма сортировки.
Итак, в следующий раз, когда вы будете играть в Go Fish с другом и обнаружите, что ужасно проигрываете, с целой кучей карт в руке — помните о силе сортировки вставками. Может быть, вы сможете просто отвлечь всех, обучив их этому алгоритму сортировки, и стать настоящим победителем!
Ресурсы
Сортировка вставками довольно часто встречается в большинстве курсов и учебных программ по информатике, а это значит, что довольно легко найти множество примеров и руководств, объясняющих, как это работает. Если вам хочется глубже погрузиться, просмотреть другие примеры или просмотреть дополнительный код, эти ссылки — хорошее место для начала.
К.Ю. Поляков, Е.А. Еремин — Язык Си и Си++
 Задачи и задания
1. Напишите программу, которая находит максимальный и минимальный из чётных положи тельных элементов массива. Если в массиве нет чётных положительных элементов, нужно вывести сообщение об этом.
2. Введите массив с клавиатуры и найдите (за один проход) количество элементов, имеющих максимальное значение.
3. Найдите за один проход по массиву три его различных элемента, которые меньше всех ос тальных («три минимума»).
4. *Заполните массив случайными числами в диапазоне 10..12 и найдите длину самой длин ной последовательности стоящих рядом одинаковых элементов.
5. Заполните массив случайными числами в диапазоне 0..4 и выведите на экран номера всех элементов, равных значению X (оно вводится с клавиатуры).
6. Заполните массив случайными числами и переставьте соседние элементы, поменяв 1 ый элемент со 2 м, 3 й – с 4 м и т.д.
7. Заполните массив из чётного количество элементов случайными числами и выполните ре верс отдельно для 1 ой и 2 ой половин массива.
8. Заполните массив случайными числами и выполните реверс для части массива между эле ментами с индексами K и M (включая эти элементы).
9. Напишите программу для выполнения циклического сдвига массива вправо на 4 элемента.
10. Найдите в массиве все простые числа и скопируйте их в новый массив.
11. *Найдите в массиве все числа Фибоначчи и скопируйте их в новый массив.
Сортировка – это расстановка элементов массива в заданном порядке.
Порядок сортировки может быть любым; для чисел обычно рассматривают сортировку по возрастанию (или убыванию) значений.
Возникает естественный вопрос: «зачем сортировать данные?». На него легко ответить, вспомнив, например, работу со словарями: сортировка слов по алфавиту облегчает поиск нужной информации.
Программисты изобрели множество способов сортировки. В целом их можно разделить на две группы: 1) простые, но медленно работающие (на больших массивах) и 2) сложные, но быст рые. Мы изучим два классических метода из первой группы и один метод из второй – знаменитую «быструю сортировку», предложенную Ч. Хоаром.
Далее мы будем, как принято в учебниках, рассматривать алгоритмы сортировки эле ментов массива по возрастанию (или убыванию) значений. Для массивов, в которых есть одина ковые элементы, используются понятия «сортировка по неубыванию» и «сортировка по невозрас танию».
Метод пузырька ( сортировка обменами )
Название этого метода произошло от известного физического явления – пузырёк воздуха в воде поднимается вверх. Если говорить о сортировке массива, сначала поднимается «наверх» (к началу массива) самый «лёгкий» (минимальный) элемент, затем следующий и т.д.
Сначала сравниваем последний элемент с предпоследним. Если они стоят неправильно (меньший элемент «ниже»), то меняем их местами. Далее так же рассматриваем следующую пару элементов и т.д. (см. рисунок).
Информатика, 10 класс
К.Ю. Поляков, Е.А. Еремин 42
Когда мы обработали пару ( A[0] , A[1] ), минимальный элемент стоит на месте A[0] . Это значит, что на следующих этапах его можно не рассматривать. Первый цикл, устанавливающий на свое
место первый (минимальный) элемент, можно на псевдокоде записать так:
для j от N- 2 до 0 шаг -1
если A[j+ 1 ]< A[j] то
поменять местами A[j] и A[j+ 1 ]
Здесь j – целочисленная переменная. Обратите внимание, что на очередном шаге сравниваются элементы A[j] и A[j+1] , поэтому цикл начинается с j=N-2 . Если начать с j=N-1 , то на первом же шаге получаем выход за границы массива – обращение к элементу A[N] .
За один проход такой цикл ставит на место один элемент. Чтобы «подтянуть» второй эле мент, нужно написать еще один почти такой же цикл, который будет отличаться только конечным значением j в заголовке цикла. Так как верхний элемент уже стоит на месте, его не нужно трогать:
сделать для j от N- 2 до 1 шаг -1
если A[j+ 1 ]< A[j] то
поменять местами A[j] и A[j+ 1 ]
При установке 3 го элемента конечное значение для j будет равно 2 и т.д.
Таких циклов нужно сделать N-1 – на 1 меньше, чем количество элементов массива. По чему не N ? Дело в том, что если N-1 элементов поставлены на свои места, то оставшийся автома тически встает на своё место – другого места для него нет. Поэтому полный алгоритм сортировки
представляет собой такой вложенный цикл: for ( i = 0 ; i < N- 1 ; i++ )
for ( j = N- 2 ; j >= i; j— ) if ( A[j] > A[j+ 1 ] )
// поменять местами A[j] и A[j+1]
Записать полную программу вы можете самостоятельно.
Еще один популярный простой метод сортировки – метод выбора, при котором на каждом этапе выбирается минимальный элемент (из оставшихся) и ставится на свое место. Алгоритм в
общем виде можно записать так:
для i от 1 до N- 1
найти номер nMin минимального элемента из A[i]..A[N] если i != nMin то
поменять местами A[i] и A[nMin]
Здесь перестановка происходит только тогда, когда найденный минимальный элемент стоит не на своём месте, то есть i != nMin . Поскольку поиск минимального элемента выполняется в цикле,
этот алгоритм сортировки также представляет собой вложенный цикл: for ( i = 0 ; i < N- 1 ; i++ ) <
for ( j = i+ 1 ; j < N; j++ ) if ( A[j] < A[nMin] )
nMin = j; if ( i != nMin )
// поменять местами A[i] и A[nMin]
Информатика, 10 класс
К.Ю. Поляков, Е.А. Еремин 43
Методы сортировки, описанные в предыдущем параграфе, работают медленно для больших массивов данных (более 1000 элементов). Поэтому в середине XX века математики и программисты серьезно занимались разработкой более эффективных алгоритмов сортировки. Один из самых популярных «быстрых» алгоритмов, разработанный в 1960 году англий ским учёным Ч. Хоаром, так и называется – «быстрая сортировка» (англ. quicksort ).
Будем исходить из того, что сначала лучше делать перестановки элементов массива на большом расстоянии. Предположим, что у нас есть N элементов и известно, что они уже отсортированы в обратном порядке. Тогда за N/2 обменов можно отсортировать их как нужно – сначала поме нять местами первый и последний, а затем последовательно двигаться с
двух сторон к центру. Хотя это справедливо только тогда, когда порядок элементов обратный, по добная идея положена в основу алгоритма Quicksort .
Пусть дан массив A из N элементов. Выберем сначала наугад любой элемент массива (назо вем его X ). На первом этапе мы расставим элементы так, что слева от некоторой границы (в пер вой группе) находятся все числа, меньшие или равные X , а справа (во второй группе) – большие или равные X . Заметим, что элементы, равные X , могут находиться в обеих частях.
Теперь элементы расположены так, что ни один элемент из первой группы при сортировке не окажется во второй и наоборот. Поэтому далее достаточно отсортировать отдельно каждую часть массива. Такой подход называют «разделяй и властвуй» (англ. divide and conquer ).
Лучше всего выбирать X так, чтобы в обеих частях было равное количество элементов. Такое значение X называется медианой массива. Однако для того, чтобы найти медиану, надо сначала отсортировать массив 11 , то есть заранее решить ту самую задачу, которую мы собираемся решить этим способом. Поэтому обычно в качестве X выбирают средний элемент массива или элемент со случайным номером.
Сначала будем просматривать массив слева до тех пор, пока не обнаружим элемент, кото рый больше X (и, следовательно, должен стоять справа от X ). Затем просматриваем массив справа до тех пор, пока не обнаружим элемент меньше X (он должен стоять слева от X ). Теперь поменя ем местами эти два элемента и продолжим просмотр до тех пор, пока два «просмотра» не встре тятся где то в середине массива. В результате массив окажется разбитым на 2 части: левую со зна чениями меньшими или равными X , и правую со значениями большими или равными X . На этом первый этап («разделение») закончен. Затем такая же процедура применяется к обеим частям массива до тех пор, пока в каждой части не останется один элемент (и таким образом, массив бу дет отсортирован).
Зачем пузырьковой сортировке нужны вложенные циклы?
Я собираюсь начать новый вопрос. Вчера я задал вопрос и хотел узнать, в чем проблема в моей программе. Программа приведена ниже, и вы, люди, указали, что эта следующая программа выполняет только один проход сортировки и также требует внешнего цикла. В то время я был в порядке. Но снова, когда я посмотрел программу, я запутался и должен спросить, зачем нам нужен внешний цикл для сортировки, поскольку только один цикл может выполнять сортировку (на мой взгляд). Сначала см. Программу ниже, а затем я представляю свою логику в конце программы.
Я думаю, что ЕДИНСТВЕННЫЙ цикл с условием пузырька должен выполнять сортировку. Посмотрите на следующий цикл программы:
Теперь я объясняю, о чем я думаю, что этот цикл «должен» делать. Сначала он сравнивает число [0] с числом [1]. Если условие выполнено, он будет делать то, что находится в теле оператора IF. Тогда i будет увеличен на 1 (i ++). Тогда на следующей итерации сравниваемые значения будут иметь номер [1] с номером [2]. Тогда почему этого не происходит и цикл завершается только после прохода? Другими словами, может быть, я пытаюсь спросить, что оператор IF не повторяется в цикле for? На мой взгляд, да. Я очень благодарен за помощь и мнения, мой вопрос может быть незначительным, но так я буду прогрессировать.
Зачем Bubble Sort нужны вложенные циклы?
Ok. Я собираюсь начать новый вопрос. Я поставил вопрос вчера и хотел узнать, в чем проблема в моей программе. Программа приведена ниже, и вы указали, что эта следующая программа выполняет только один проход сортировки и нуждается в внешнем цикле. В то время я был хорошо, как хорошо. Но опять же, когда я смотрел программу, я смутился и мне нужно было спросить, зачем нам нужен и Outer loop для сортировки, поскольку только один цикл может сортировать (по-моему). Сначала просмотрите программу ниже, после чего я представляю свою логику в конце программы.
Я думаю, что цикл ONLY с условием пузыря должен выполнять сортировку. Посмотрите на следующий цикл программы:
Теперь я объясню, что я думаю о том, что должен делать этот цикл. Сначала он сравним число [0] с номером [1]. Если условие выполнено, оно будет делать то, что находится в теле оператора IF. Тогда я будет увеличиваться на 1 (i ++). Затем на следующей итерации сравниваемые значения будут числом [1] с номером [2]. Тогда почему этого не происходит, и петля выходит после прохождения? Другими словами, может быть, я пытаюсь спросить, что оператор IF не повторяет цикл for? По-моему, это так. Я очень благодарен за помощь и взгляды, мой вопрос может быть небольшого уровня, но я буду прогрессировать. Спасибо.