Как найти дисперсию?
Дисперсия — это мера разброса значений случайной величины $X$ относительно ее математического ожидания $M(X)$ (см. как найти математическое ожидание случайной величины). Дисперсия показывает, насколько в среднем значения сосредоточены, сгруппированы около $M(X)$: если дисперсия маленькая — значения сравнительно близки друг к другу, если большая — далеки друг от друга (см. примеры нахождения дисперсии ниже).
Если случайная величина описывает физические объекты с некоторой размерностью (метры, секунды, килограммы и т.п.), то дисперсия будет выражаться в квадратных единицах (метры в квадрате, секунды в квадрате и т.п.). Ясно, что это не совсем удобно для анализа, поэтому часто вычисляют также корень из дисперсии — среднеквадратическое отклонение $\sigma(X)=\sqrt
Еще одно формальное определение дисперсии звучит так: «Дисперсия — это второй центральный момент случайной величины» (напомним, что первый начальный момент — это как раз математическое ожидание).
Формула дисперсии случайной величины
Дисперсия случайной величины Х вычисляется по следующей формуле: $$ D(X)=M(X-M(X))^2, $$ которую также часто записывают в более удобном для расчетов виде: $$ D(X)=M(X^2)-(M(X))^2. $$
Эта универсальная формула для дисперсии может быть расписана более подробно для двух случаев.
Если мы имеем дело с дискретной случайной величиной (которая задана перечнем значений $x_i$ и соответствующих вероятностей $p_i$), то формула принимает вид: $$ D(X)=\sum_
Пример нахождения дисперсии
Рассмотрим простые примеры, показывающие как найти дисперсию по формулам, введеным выше.
Пример 1. Вычислить и сравнить дисперсию двух законов распределения: $$ x_i \quad 1 \quad 2 \\ p_i \quad 0.5 \quad 0.5 $$ и $$ y_i \quad -10 \quad 10 \\ p_i \quad 0.5 \quad 0.5 $$
Для убедительности и наглядности расчетов мы взяли простые распределения с двумя значениями и одинаковыми вероятностями. Но в первом случае значения случайной величины расположены рядом (1 и 2), а во втором — дальше друг от друга (-10 и 10). А теперь посмотрим, насколько различаются дисперсии: $$ D(X)=\sum_
Ясно, что для более сложных распределений, где число значений больше и вероятности не одинаковы, картина будет более сложной, прямой зависимости от значений уже не будет (но будет как раз оценка разброса).
Пример 2. Найти дисперсию случайной величины Х, заданной дискретным рядом распределения: $$ x_i \quad -1 \quad 2 \quad 5 \quad 10 \quad 20 \\ p_i \quad 0.1 \quad 0.2 \quad 0.3 \quad 0.3 \quad 0.1 $$
Снова используем формулу для дисперсии дискретной случайной величины: $$ D(X)=M(X^2)-(M(X))^2. $$ В случае, когда значений много, удобно разбить вычисления по шагам. Сначала найдем математическое ожидание: $$ M(X)=\sum_
Пример 3. Найти дисперсию по заданному непрерывному закону распределения случайной величины Х, заданному плотностью $f(x)=x/18$ при $x \in(0,6)$ и $f(x)=0$ в остальных точках.
Используем для расчета формулу дисперсии непрерывной случайной величины: $$ D(X)=\int_<-\infty>^ <+\infty>f(x) \cdot x^2 dx — \left( \int_<-\infty>^ <+\infty>f(x) \cdot x dx \right)^2. $$ Вычислим сначала математическое ожидание: $$ M(X)=\int_<-\infty>^ <+\infty>f(x) \cdot x dx = \int_<0>^ <6>\frac
Вычисление дисперсии онлайн
Как найти дисперсию онлайн для дискретной случайной величины? Используйте калькулятор ниже.
- Введите число значений случайной величины К.
- Появится форма ввода для значений $x_i$ и соответствующих вероятностей $p_i$ (десятичные дроби вводятся с разделителем точкой, например: -10.3 или 0.5). Введите нужные значения (проверьте, что сумма вероятностей равна 1, то есть закон распределения корректный).
- Нажмите на кнопку «Вычислить».
- Калькулятор покажет вычисленное математическое ожидание $M(X)$ и затем искомое значение дисперсии $D(X)$.
Видео. Полезные ссылки
Видеоролики: что такое дисперсия и как найти дисперсию
Если вам нужно более подробное объяснение того, что такое дисперсия, как она вычисляется и какими свойствами обладает, рекомендую два видео (для дискретной и непрерывной случайной величины соответственно).
Полезные ссылки
Что еще может пригодиться? Например, для изучения основ теории вероятностей — онлайн учебник по ТВ. Для закрепления материала — еще примеры решений задач по теории вероятностей.
А если у вас есть задачи, которые надо срочно сделать, а времени нет? Можете поискать готовые решения в решебнике или заказать в МатБюро:
Расчет дисперсии и среднего квадратического отклонения по индивидуальным данным и в рядах распределения.
Основными обобщающими показателями вариации в статистике являются дисперсии и среднее квадратическое отклонение.
Дисперсия — это средняя арифметическая квадратов отклонений каждого значения признака от общей средней. Дисперсия обычно называется средним квадратом отклонений и обозначается  . В зависимости от исходных данных дисперсия может вычисляться по средней арифметической простой или взвешенной:
 —дисперсия невзвешенная (простая);
 —дисперсия взвешенная.
Среднее квадратическое отклонение представляет собой корень квадратный из дисперсии и обозначается S:
 —среднее квадратическое отклонение невзвешенное;
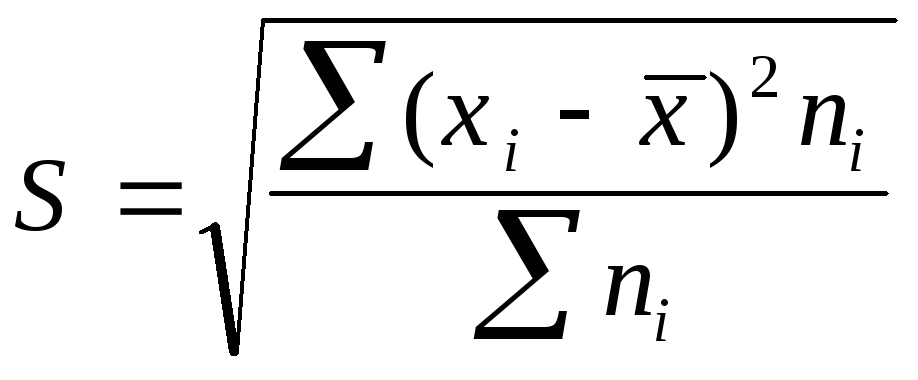 —среднее квадратическое отклонение взвешенное.
Среднее квадратическое отклонение — это обобщающая характеристика абсолютных размеров вариации признака в совокупности. Выражается оно в тех же единицах измерения, что и признак (в метрах, тоннах, процентах, гектарах и т.д.).
Среднее квадратическое отклонение является мерилом надежности средней. Чем меньше среднее квадратическое отклонение, тем лучше средняя арифметическая отражает собой всю представляемую совокупность.
Вычислению среднего квадратического отклонения предшествует расчет дисперсии.
Порядок расчета дисперсии взвешенную:
1) определяют среднюю арифметическую взвешенную
 ;
2) определяются отклонения вариант от средней  ;
3) возводят в квадрат отклонение каждой варианты от средней  ;
4) умножают квадраты отклонений на веса (частоты)  ;
5) суммируют полученные произведения
 ;
6) Полученную сумму делят на сумму весов
 .
Произведено продукции одним рабочим, шт.
( варианта)
Число рабочих, 
Дисперсия
Дисперсия в статистике — это мера, которая показывает разброс между результатами. Если все они близки к среднему, дисперсия низкая. А если результаты сильно различаются — высокая.
Это один из основных показателей в статистическом анализе. Точка, вокруг которой считают разброс, — это обычно среднее арифметическое из выборки, математическое ожидание или какое-то целевое значение. А если смотрят, например, разброс между ответами на какой-то тестовый вопрос, в качестве центральной точки можно взять правильный ответ.
Термин «дисперсия» также встречается в физике, химии и биологии. Например, так называют явление, когда разные вещества не смешиваются друг с другом. А еще — разложение света на отдельные цвета, когда он проходит через призму. Но это другие понятия. Они не имеют отношения к статистике.
Освойте профессию «Data Scientist»
Дата-сайентисты решают поистине амбициозные задачи. Научитесь создавать искусственный интеллект, обучать нейронные сети, менять мир и при этом хорошо зарабатывать. Программа рассчитана на новичков и плавно введет вас в Data Science.
Решайте амбициозные задачи с помощью нейросетей
Что показывает дисперсия
Если говорить о всей выборке, дисперсия показывает, насколько разнородны результаты. Например, в одной группе почти все — шатены. В другой половина — шатены, а остальные — блондины, рыжие и брюнеты. Вторая группа более разнородная, в ней выше дисперсия.
Более близкие к реальному миру примеры:
- бизнесу дисперсия поможет рассчитать разброс между доходами за разные месяцы;
- ученый с помощью дисперсии поймет, насколько совпадают между собой результаты серии экспериментов.
Еще дисперсия показывает вероятность того, что конкретный результат будет далек от среднего. Например, средний рост россиянина мужского пола — 175 см. Но если остановить на улице случайного мужчину, вряд ли он окажется ровно 175 см ростом — скорее всего, выше или ниже. Дисперсия высокая — вероятность встретить «не среднее» значение выше.
В реальном мире это можно использовать так:
- проверять, насколько предсказуемы бизнес-показатели;
- оценивать риски — для компании, продвижения или даже обычной жизни.
Логика тут такая: чем меньше предсказуемости — тем больше хаоса и, соответственно, больше рисков.
Кто работает с дисперсией
- Ученые, которые могут пользоваться метриками из математической статистики, например для оценки результатов эксперимента.
- Статистики — они могут собирать данные по разным параметрам и потом оценивать их.
- Аналитики — статистика и в частности дисперсия используются в большинстве направлений Data Science, анализа данных, бизнес-аналитики и так далее. -инженеры — дисперсию учитывают, когда оценивают работу модели машинного обучения. Тут это будет разброс между ответами.
Формула дисперсии
Сначала дадим формальное определение, а потом объясним простыми словами. Дисперсия рассчитывается по формуле как среднее квадратичное отклонение от среднего значения:
- n — количество элементов,
- xi – i-й элемент в выборке,
- x — среднее арифметическое.
Звучит и выглядит сложно, но фактически все не так страшно. Вот как выглядит расчет пошагово:
- Найти среднее арифметическое x. Для этого нужно сложить все элементы и разделить полученную сумму на их количество.
- Потом от каждого элемента по очереди нужно отнять среднее арифметическое, а получившееся число возвести в квадрат. Это называется квадратами отклонения от среднего.
- Найденные квадраты отклонения от среднего нужно сложить.
- Сумму разделить на количество элементов в выборке.
Формула дисперсии случайной величины рассчитывается так:
Найти дисперсию случайной величины также можно по формуле, записанной в более удобном для расчетов виде:
Все перечисленное посчитать несложно — достаточно школьных знаний математики. А вот чтобы понять, почему формула именно такая, уже нужно разбираться в статистике.
Станьте дата-сайентистом и решайте амбициозные задачи с помощью нейросетей
Пример расчета дисперсии
Давайте посмотрим на практике, как рассчитать дисперсию. Для этого возьмем простую выборку из шести элементов. Будем считать, что это оценки группы с дополнительных занятий: [5, 2, 3, 5, 4, 5].
- Сначала найдем среднее арифметическое: (5 + 2 + 3 + 5 + 4 + 5) / 6 = 24 / 6 = 4.
- Теперь найдем квадраты отклонения от среднего:
- Сложим получившиеся квадраты: 1 + 4 + 1 + 1 + 0 + 1 = 8.
- Разделим сумму на количество элементов: 8 / 6 = 1,33.
Число 1,33 — это и есть дисперсия. Не слишком большая — большинство значений близко к среднему арифметическому, равному 4.
Как интерпретировать результат
Единицы измерения дисперсии — квадраты от единиц, в которых указаны значения в выборке. Например, в нашем расчете вышел разброс в 1,33 — это не баллы оценок, а их квадраты. Чтобы узнать, каким разброс будет в баллах, нужно будет взять квадратный корень из 1,33.
Какую дисперсию считать большой или маленькой — зависит от значений и выборки в целом. Например, для нашей небольшой выборки из чисел от 0 до 5 условная дисперсия в 4 считалась бы довольно большой. Но можно представить много выборок, где 4 — маленькое значение. Например, крупная выборка, где собраны числа от 100 до 1000.
Еще это зависит от сферы. Например, в условной медицине или точной инженерии даже небольшое число может быть значимой дисперсией.
Связь с другими показателями
Дисперсия тесно связана с несколькими другими показателями из статистики. Мы уже сказали про среднее арифметическое, но оно не единственное. Вот еще три важных показателя.
Стандартное отклонение. Это квадратный корень из дисперсии — выше мы говорили, что дисперсия представляет собой значение «в квадрате». А стандартное отклонение дает результат в тех же единицах измерения, что и числа в выборке. Если взять квадратный корень из нашей дисперсии в 1,33, получится 1,15 — значит, числа в выборке отклоняются от среднего на 1,15 балла. Отклоняются они опять же в среднем — для конкретного числа отклонение может быть и больше, и меньше.
Смещение. Смещение — это ошибка выборки. Например, когда исследователь собирал выборку, отобранные значения оказались похожими по какому-то фактору, а остальные он случайно проигнорировал. Например, отобрал для выборки фото с котами только белых котиков. В случае с машинным обучением это еще и «перекос» результатов, которые выдает модель: например, называет всех белых животных котами.
При чем тут дисперсия — она растет при маленьком смещении и падает при большом. Идеальная выборка — это маленькая дисперсия при большом смещении, но в реальности это практически невозможно. Поэтому приходится балансировать.
Ошибка прогнозирования. Статистику используют для прогнозирования. Но из-за дисперсии и смещения нельзя спрогнозировать все точно. Ошибка прогнозирования — это мера неточности. Чем она выше, тем сильнее прогноз может расходиться с реальным результатом. Существуют разные способы расчета этой ошибки, обычно для них используют реальные значения, если они известны.
Когда нужно применять дисперсию
Стандартное отклонение проще для понимания, так что может возникнуть вопрос: зачем пользоваться именно дисперсией. На практике пользуются и тем, и другим — зависит от задачи. Где-то считать показатели и анализировать удобнее через дисперсию, где-то — через стандартное отклонение. Благо, одно легко высчитывается через другое.
Например, дисперсия удобнее стандартного отклонения, если исследователь пользуется статистическим анализом или регрессией либо пишет теоретическую работу вроде лабораторной. Дисперсию бывает проще представить в процентах, она используется во множестве формул — так что смотреть нужно на саму задачу. Хотя и стандартное отклонение используют не реже.
Если вы хотите узнать больше про статистику, анализ данных и машинное обучение — приглашаем на курсы! Дадим много практических заданий и поможем получить первый реальный опыт.
6. Формула для вычисления дисперсии.
Среднее квадратическое отклонение. Коэффициент вариации
В первой части урока мы рассмотрели размах вариации, среднее линейное отклонение и дисперсию, и продолжение темы в заголовке. Многие из этих показателей фигурируют в теории вероятностей, и если вы зашли с поисковика именно за ними, то сразу ссылка на нужную статью: Дисперсия дискретной случайной величины – там же всё остальное.
Ну а здесь на повестке дня Математическая статистика (организационный урок для «чайников»), и мы продолжаем изучать показатели вариации:
Всё с формулами, примерами решений и техникой рациональных вычислений.
И снова о дисперсии.
На предыдущем занятии мы рассчитывали дисперсию по определению:
– для несгруппированных данных и
– для дискретного либо интервального вариационного ряда.
Если известно, генеральная ли нам дана совокупность или выборочная, то хорошим тоном считается поставить подстрочные индексы: либо .
Расчёт дисперсии по определению прост и реально используется на практике, но существует ещё более простой и удобный способ вычисления – по формуле, которую несложно вывести из определения:
– дисперсия равна разности средней арифметической квадратов всех вариант статистической совокупности и квадрата средней самих этих вариант.
ОСМЫСЛЕННО повторяем ВСЛУХ и вникаем! … Карл украл у Клары кораллы, а Клара украла у Карла кларнет 🙂
Если что-то не очень понятно, то сейчас всё станет на свои места:
Для несгруппированных вариант выборочной совокупности формула детализируется следующим образом:
и для готового вариационного ряда – так:
, где – кратные (одинаковые) варианты дискретного ряда либо середины интервалов интервального ряда, а – соответствующие частоты.
Для генеральной дисперсии формулы те же, только с буквами вместо . Во многих случаях удобно использовать просто значок суммирования – без переменной-«счётчика», поскольку в контексте той или иной задачи и так понятно, что суммируется.
И начнём мы со знакомой подопытной задачи:
В результате 10 независимых измерений получены опытные данные, которые представлены в таблице: 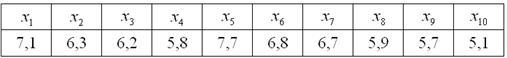
Это данные из Примера 13, и на этот раз нам требуется вычислить дисперсию с помощью формулы. Напоминаю, что там мы её рассчитали по определению и получили результат , таким образом, ответ известен заранее, и это всегда круто. Всегда, когда он правильный.
Решение: используем формулу .
Для этого нужно найти выборочную среднюю, повторим действие: ,
вычислить квадраты всех вариант:
и их сумму:
Результаты вычислений удобно заносить в таблицу: 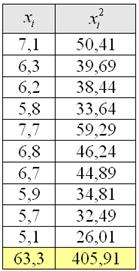
Осталось применить формулу:
, что и требовалось увидеть.
Ответ:
Теперь случай сформированного вариационного ряда. В Примере 14 мы потренировались на дискретном ряде, и сейчас очередь интервального:
С целью изучения вкладов в Сбербанке города проведено выборочное исследование, в результате которого получены следующие данные: 
Вычислить выборочную дисперсию и среднее квадратическое отклонение, оценить соответствующие показатели генеральной совокупности.
Автор задачи заботливо подсчитал объем выборки , но не «закрыл» крайние интервалы. Такая вещь уже встречалась, и решение мы начинаем с этого закрытия. Поскольку длины внутренних интервалов составляют д.е., то логично рассмотреть такую же длину и по краям, то бишь, интервалы от 200 до 400 и от 1000 до 1200 денежных единиц.
…Возможно, у вас возник вопрос, а как быть, если даны интервалы разной длины? В этом случае принимаем за «эталон» среднюю длину известных интервалов.
Для расчёта числовых характеристик перейдём к дискретному вариационному ряду, выбрав в качестве вариант середины интервалов, которые здесь видны устно: 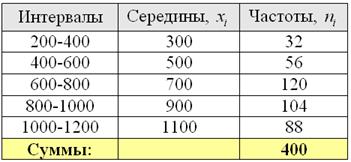
В тяжёлых случаях суммируем концы интервалов и делим их пополам, например: .
Кроме того, варианты целесообразно уменьшить в 1000 раз, поскольку в ходе дальнейших вычислений будут получаться гигантские числа. С современными вычислительными мощностями, это, конечно, не проблема, но смотреться будет некрасиво.
Сначала вычислим выборочную среднюю. Этот алгоритм уже обкатан: находим произведения , их сумму: 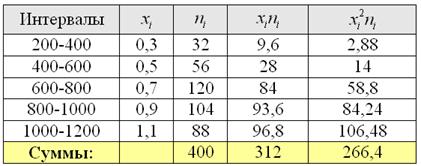
и по соответствующей формуле:
тыс. д.е. или 780 д.е. – средний размер вклада.
Примечание: далее для компактной записи я буду использовать просто значок – без переменной-«счётчика».
Теперь дисперсия. Её никто не запрещает рассчитать по определению , но заметьте, насколько легче формула – для её применения всего-то лишь нужно рассчитать произведения и их сумму (правый столбец таблицы). Несмотря на то, что многие читатели уже освоили технику вычислений в Экселе, я продолжу записывать ролики – мало ли, кто что запамятовал:
Итак, по формуле вычисления дисперсии, получаем:
тыс. д.е. в квадрате (т.к. по определению, дисперсия – есть величина квадратичная).
И, чтобы вернуться в размерность задачи, из дисперсии следует извлечь квадратный корень:
тыс. д.е. или 240 денежных единиц. Полученный показатель называется
среднее квадратическое отклонение
Или стандартное отклонение. Оно обозначается греческой буквой «сигма», и коль скоро у нас выборочная совокупность, то добавляем соответствующий подстрочный индекс:
– выборочное среднее квадратическое отклонение.
Чем меньше стандартное отклонение (и дисперсия), тем меньше вариация – тем бОльшее количество вариант находится вблизи выборочной средней. Но у нас, как нетрудно «прикинуть на глазок», разброс довольно-таки велик – значительное количество вкладов расположено далековато от , и поэтому значение получилось немалым.
Следующая часть задачи состоит в том, чтобы корректно оценить генеральную дисперсию и генеральное среднее квадратическое отклонение .
В 1-й части урока я рассказал о том, что выборочная дисперсия представляет собой смещённую оценку генеральной дисперсии. Это означает, что если мы будем проводить неоднократные выборки из той же генеральной совокупности, то полученные значения будут систематически занижено оценивать . Обращаю ваше внимание, что это не значит, что будет всегда меньше, чем .
И поэтому выборочную дисперсию, как намекает условие, нужно поправить:
– исправленная выборочная дисперсия
и, соответственно:
или 240,30 д.е. – исправленное среднее квадратическое отклонение.
и – это уже несмещённые оценки генеральной дисперсии и генерального стандартного отклонения соответственно.
Ввиду большого объёма выборки (более 100 вариант) этой поправкой можно пренебречь, но всё же мы не будем «разбрасываться» 30 «копейками».
Ответ: ; в качестве оценки соответствующих генеральных показателей принимаем и .
Рассмотренные выше показатели (размах вариации, среднее линейное отклонение, дисперсия, стандартное отклонение) входят в группу абсолютных показателей вариации, которые обладают рядом неудобств. Так, если в прорешанной задаче не уменьшать варианты в 1000 раз, то дисперсия получится в миллион раз больше! Да-да, не , а . И возникает естественное желание привести результаты к некому единому стандарту.
Для этого существуют показатели относительные, и самым известным из них является
коэффициент вариации
– это отношение стандартного отклонения к средней, выраженное в процентах:
И вот теперь совершенно без разницы, в д.е. мы считали:
или в тысячах д.е.:
Примечание: на практике часто считают именно через , но для оценки коэффициента вариации всей генеральной совокупности, конечно же, корректнее использовать исправленное стандартное отклонение .
В статистике существует следующий эмпирический ориентир:
– если показатель вариации составляет примерно 30% и меньше, то статистическая совокупность считается однородной. Это означает, что большинство вариант находится недалеко от средней, и найденное значение хорошо характеризует центральную тенденцию совокупности.
– если показатель вариации составляет существенно больше 30%, то совокупность неоднородна, то есть, значительное количество вариант находятся далеко от , и выборочная средняя плохо характеризует типичную варианту. В таких случаях целесообразно рассмотреть квартили, децили, а иногда и перцентили, которые делят вариационный ряд на части, и для каждого участка рассчитать свои показатели. Но это уже немного дебри статистики.
Другое преимущество относительных показателей – это возможность сравнивать разнородные статистические совокупности. Например, множество слонов и множество хомячков. Совершенно понятно, что дисперсия веса слонов по отношению к дисперсии веса хомяков будет просто конской, и их сопоставление не имеет смысла. Но вот анализ коэффициентов вариации веса вполне осмыслен, и может статься, что у слонов он составляет 10%, а у хомячков 40% (пример, конечно, условный). Это говорит о сбалансированном питании и размеренной жизни слонов. А вот хомяки там, то носятся с голодухи по полям, то отъедаются и спят в норах, и поэтому среди них есть много худощавых и много упитанных особей 🙂
Кроме коэффициента вариации, существуют и другие относительные показатели, но в реальных студенческих работах они почти не встречаются, и поэтому я не буду их рассматривать в рамках данного курса.
И сейчас, конечно же, задачки для самостоятельного решения:
Пример 17, на отработку терминов и формул:
а) Стандартное отклонение выборочной совокупности равно 5, а средний квадрат её вариант – 250. Найти выборочную среднюю.
б) Определите среднее квадратическое отклонение, если известно, что средняя равна 260, а коэффициент вариации составляет 30%.
и Пример 18, творческий:
Производство стальных труб на предприятии (тонн) в 1-м полугодии составило: 
Определить:
– среднемесячный объем производства;
– среднее квадратическое отклонение;
– коэффициент вариации.
Сделать краткие содержательные выводы. – Да, это тоже типичный пункт статистической задачи!
Обратите внимание, что здесь не понятно, выборочной ли считать эту совокупность или генеральной. И в таких случаях лучше не заниматься домыслами, просто используем обозначения без подстрочных индексов.
Вообще, задачи на экономическую и промышленную тематику – самые популярные в статистике, и в моей коллекции их сотни. Но все они до ужаса однотипны, и поэтому я предлагаю их в терапевтической дозировке 🙂
Выполнить расчёты в Экселе – числа уже там, ну а инструкцию я на этот раз не привёл, поскольку люди вы уже опытные.
Краткое решение и ответ в конце урока, который подошёл к концу.
Следующее занятие не за горами, а уже за кочкой:
Решения и ответы:
Пример 17. Решение:
а) Используем формулу . По условию, , . Таким образом:
б) Используем формулу . По условию, , . Таким образом:
Пример 18. Решение: вычислим сумму вариант и сумму их квадратов: 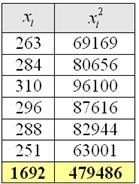
Найдём среднюю:
тонны – среднемесячный объем производства за полугодие.
Дисперсию вычислим по формуле:
Среднее квадратическое отклонение:
тонн.
Коэффициент вариации:
Ответ: тонны, тонн,
Краткие выводы: за первое полугодие среднемесячный объём производства труб составил тонны. Низкие показатели вариации говорят о стабильной ситуации на производстве.