# факты | Как работает процессор компьютера?
Вы читаете эти строки со смартфона, планшета или компьютера. Любое из этих устройств основано на микропроцессоре. Микропроцессор является «сердцем» любого компьютерного устройства. Существует много типов микропроцессоров, но все они решают одни и те же задачи. Сегодня мы поговорим о том, как процессор работает и какие задачи он выполняет. На первый взгляд все это представляется очевидным. Но очень многим пользователям было бы интересно углубить свои знания о важнейшем компоненте, обеспечивающем работу компьютера. Мы узнаем о том, как технология, основанная на простой цифровой логике, позволяет вашему компьютеру не только решать математические задачи, но и быть развлекательным центром. Как всего две цифры — единица и ноль — преобразуются в красочные игры и фильмы? Этот вопрос многие неоднократно задавали себе и будут рады получить на него ответ. Ведь даже в основе недавно рассмотренного нами процессора AMD Jaguar, на котором базируются новейшие игровые приставки, лежит та же древняя логика.
В англоязычной литературе микропроцессор часто называют CPU (central processing unit, [единым] модулем центрального процессора). Причина такого названия кроется в том, что современный процессор представляет собою единый чип. Первый микропроцессор в истории человечества был создан корпорацией Intel в далеком 1971 году.
Роль Intel в истории микропроцессорной индустрии
Первым микропроцессором для домашних компьютеров стал представленный в 1974 году Intel 8080. Вся вычислительная мощность 8-битного компьютера помещалась в одном чипе. Но по-настоящему большое значение имел анонс процессора Intel 8088. Он появился в 1979 году и с 1981 года стал использоваться в первых массовых персональных компьютерах IBM PC.
Далее процессоры начали развиваться и обрастать мощью. Каждый, кто хоть немного знаком с историей микропроцессорной индустрии, помнит, что на смену 8088 пришли 80286. Затем настал черед 80386, за которым следовали 80486. Потом были несколько поколений «Пентиумов»: Pentium, Pentium II, III и Pentium 4. Все это «интеловские» процессоры, основанные на базовой конструкции 8088. Они обладали обратной совместимостью. Это значит, что Pentium 4 мог обработать любой фрагмент кода для 8088, но делал это со скоростью, возросшей примерно в пять тысяч раз. С тех пор прошло не так много лет, но успели смениться еще несколько поколений микропроцессоров.
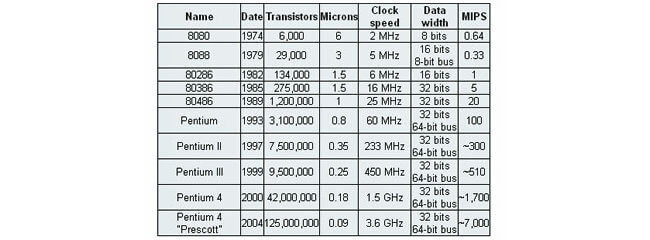
- Name (Название). Модель процессора
- Date (Дата). Год, в который процессор был впервые представлен. Многие процессоры представляли многократно, каждый раз, когда повышалась их тактовая частота. Таким образом, очередная модификация чипа могла быть повторно анонсирована даже через несколько лет после появления на рынке первой его версии
- Transistors (Количество транзисторов). Количество транзисторов в чипе. Вы можете видеть, что этот показатель неуклонно увеличивался
- Microns (Ширина в микронах). Один микрон равен одной миллионной доле метра. Величина этого показателя определяется толщиной самого тонкого провода в чипе. Для сравнения, толщина человеческого волоса составляет 100 микрон
- Clock speed (Тактовая частота). Максимальная скорость работы процессора
- Data Width. «Битность» арифметико-логического устройства процессора (АЛУ, ALU). 8-битное АЛУ может слагать, вычитать, умножать и выполнять иные действия над двумя 8-битными числами. 32-битное АЛУ может работать с 32-битными числами. Чтобы сложить два 32-битных числа, восьмибитному АЛУ необходимо выполнить четыре инструкции. 32-битное АЛУ справится с этой задачей за одну инструкцию. Во многих (но не во всех) случаях ширина внешней шины данных совпадает с «битностью» АЛУ. Процессор 8088 обладал 16-битным АЛУ, но 8-битной шиной. Для поздних «Пентиумов» была характерна ситуация, когда шина была уже 64-битной, а АЛУ по-прежнему оставалось 32-битным
- MIPS (Миллионов инструкций в секунду). Позволяет приблизительно оценить производительность процессора. Современные микропроцессоры выполняют настолько много разных задач, что этот показатель потерял свое первоначальное значение и может использоваться, в основном, для сравнения вычислительной мощности нескольких процессоров (как в данной таблице)
Существует непосредственная связь между тактовой частотой, а также количеством транзисторов и числом операций, выполняемых процессором за одну секунду. Например, тактовая частота процессора 8088 достигала 5 МГЦ, а производительность: всего 0,33 миллиона операций в секунду. То есть на выполнение одной инструкции требовалось порядка 15 тактов процессора. В 2004 году процессоры уже могли выполнять по две инструкции за один такт. Это улучшение было обеспечено увеличением количества процессоров в чипе.
Чип также называют интегральной микросхемой (или просто микросхемой). Чаще всего это маленькая и тонкая кремниевая пластинка, в которую «впечатаны» транзисторы. Чип, сторона которого достигает двух с половиной сантиметров, может содержать десятки миллионов транзисторов. Простейшие процессоры могут быть квадратиками со стороной всего в несколько миллиметров. И этого размера достаточно для нескольких тысяч транзисторов.
Логика микропроцессора
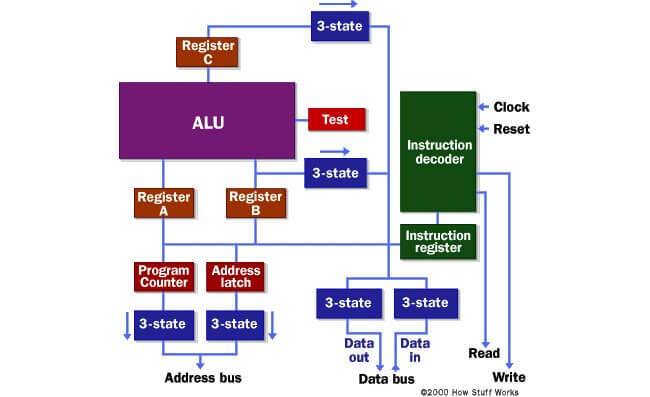
Микропроцессор способен выполнять определенный набор машинных инструкций (команд). Оперируя этими командами, процессор выполняет три основные задачи:
- C помощью своего арифметико-логического устройства, процессор выполняет математические действия: сложение, вычитание, умножение и деление. Современные микропроцессоры полностью поддерживают операции с плавающей точкой (с помощью специального арифметического процессора операций с плавающей точкой)
- Микропроцессор способен перемещать данные из одного типа памяти в другой
- Микропроцессор обладает способностью принимать решение и, на основании принятого им решения, «перепрыгивать», то есть переключаться на выполнение нового набора команд
- Address bus (адресную шину). Ширина этой шины может составлять 8, 16 или 32 бита. Она занимается отправкой адреса в память
- Data bus (шину данных): шириной 8, 16, 32 или 64 бита. Эта шина может отправлять данные в память или принимать их из памяти. Когда говорят о «битности» процессора, речь идет о ширине шины данных
- Каналы RD (read, чтения) и WR (write, записи), обеспечивающие взаимодействие с памятью
- Clock line (шина синхронизирующих импульсов), обеспечивающая такты процессора
- Reset line (шина стирания, шина сброса), обнуляющая значение счетчика команд и перезапускающая выполнение инструкций
Поскольку информация достаточно сложна, будем исходить из того, что ширина обеих шин — и адресной и шины данных — составляет всего 8 бит. И кратко рассмотрим компоненты этого сравнительно простого микропроцессора:
- Регистры A, B и C являются логическими микросхемами, используемыми для промежуточного хранения данных
- Address latch (защелка адреса) подобна регистрам A, B и C
- Счетчик команд является логической микросхемой (защелкой), способной приращивать значение на единицу за один шаг (если им получена соответствующая команда) и обнулять значение (при условии получения соответствующей команды)
- ALU (арифметико-логическое устройство) может осуществлять между 8-битными числами действия сложения, вычитания, умножения и деления или выступать в роли обычного сумматора
- Test register (тестовый регистр) является специальной защелкой, которая хранит результаты операций сравнения, производимых АЛУ. Обычно АЛУ сравнивает два числа и определяет, равны ли они или одно из них больше другого. Тестовый регистр способен также хранить бит переноса последнего действия сумматора. Он хранит эти значения в триггерной схеме. В дальнейшем эти значения могут использоваться дешифратором команд для принятия решений
- Шесть блоков на диаграмме отмечены, как «3-State». Это буферы сортировки. Множество источников вывода могут быть соединены с проводом, но буфер сортировки позволяет только одному из них (в один момент времени) передавать значение: «0» или «1». Таким образом буфер сортировки умеет пропускать значения или перекрывать источнику вывода возможность передавать данные
- Регистр команд (instruction register) и дешифратор команд (instruction decoder) держат все вышеперечисленные компоненты под контролем
На данной диаграмме не отображены линии управления дешифратора команд, которые можно выразить в виде следующих «приказов»:
- «Регистру A принять значение, поступающее в настоящий момент от шины данных»
- «Регистру B принять значение, поступающее в настоящий момент от шины данных»
- «Регистру C принять значение, поступающее в настоящий момент от арифметико-логического устройства»
- «Регистру счетчика команд принять значение, поступающее в настоящий момент от шины данных»
- «Адресному регистру принять значение, поступающее в настоящий момент от шины данных»
- «Регистру команд принять значение, поступающее в настоящий момент от шины данных»
- «Счетчику команд увеличить значение [на единицу]»
- «Счетчику команд обнулиться»
- «Активировать один из из шести буферов сортировки» (шесть отдельных линий управления)
- «Сообщить арифметико-логическому устройству, какую операцию ему выполнять»
- «Тестовому регистру принять тестовые биты из АЛУ»
- «Активировать RD (канал чтения)»
- «Активировать WR (канал записи)»
В дешифратор команд поступают биты данных из тестового регистра, канала синхронизации, а также из регистра команд. Если максимально упростить описание задач дешифратора инструкций, то можно сказать, что именно этот модуль «подсказывает» процессору, что необходимо сделать в данный момент.
Память микропроцессора
Выше мы писали о шинах (адресной и данных), а также о каналах чтения (RD) и записи (WR). Эти шины и каналы соединены с памятью: оперативной (ОЗУ, RAM) и постоянным запоминающим устройством (ПЗУ, ROM). В нашем примере рассматривается микропроцессор, ширина каждой из шин которого составляет 8 бит. Это значит, что он способен выполнять адресацию 256 байт (два в восьмой степени). В один момент времени он может считывать из памяти или записывать в нее 8 бит данных. Предположим, что этот простой микропроцессор располагает 128 байтами ПЗУ (начиная с адреса 0) или 128 байтами оперативной памяти (начиная с адреса 128).
Модуль постоянной памяти содержит определенный предварительно установленный постоянный набор байт. Адресная шина запрашивает у ПЗУ определенный байт, который следует передать шине данных. Когда канал чтения (RD) меняет свое состояние, модуль ПЗУ предоставляет запрошенный байт шине данных. То есть в данном случае возможно только чтение данных.
Из оперативной памяти процессор может не только считывать информацию, он способен также записывать в нее данные. В зависимости от того, чтение или запись осуществляется, сигнал поступает либо через канал чтения (RD), либо через канал записи (WR). К сожалению, оперативная память энергозависима. При отключении питания она теряет все размещенные в ней данные. По этой причине компьютеру необходимо энергонезависимое постоянное запоминающее устройство.
Более того, теоретически компьютер может обойтись и вовсе без оперативной памяти. Многие микроконтроллеры позволяют размещать необходимые байты данных непосредственно в чип процессора. Но без ПЗУ обойтись невозможно. В персональных компьютерах ПЗУ называется базовой системой ввода и вывода (БСВВ, BIOS, Basic Input/Output System). Свою работу при запуске микропроцессор начинает с выполнения команд, найденных им в BIOS.
Команды BIOS выполняют тестирование аппаратного обеспечения компьютера, а затем они обращаются к жесткому диску и выбирают загрузочный сектор. Этот загрузочный сектор является отдельной небольшой программой, которую BIOS сначала считывает с диска, а затем размещает в оперативной памяти. После этого микропроцессор начинает выполнять команды расположенного в ОЗУ загрузочного сектора. Программа загрузочного сектора сообщает микропроцессору о том, какие данные (предназначенные для последующего выполнения процессором) следует дополнительно переместить с жесткого диска в оперативную память. Именно так происходит процесс загрузки процессором операционной системы.
Инструкции микропроцессора
Приведем список слов-команд языка ассемблера для условного простого процессора, который мы рассматриваем в качестве примера к нашему повествованию:
- LOADA mem — Загрузить (load) регистр A из некоторого адреса памяти
- LOADB mem — Загрузить (load) регистр B из некоторого адреса памяти
- CONB con — Загрузить постоянное значение (constant value) в регистр B
- SAVEB mem — Сохранить (save) значение регистра B в памяти по определенному адресу
- SAVEC mem — Сохранить (save) значение регистра C в памяти по определенному адресу
- ADD — Сложить (add) значения регистров A и B. Результат действия сохранить в регистре C
- SUB — Вычесть (subtract) значение регистра B из значения регистра A. Результат действия сохранить в регистре C
- MUL — Перемножить (multiply) значения регистров A и B. Результат действия сохранить в регистре C
- DIV — Разделить (divide) значение регистра A на значение регистра B. Результат действия сохранить в регистре C
- COM — Сравнить (compare) значения регистров A и B. Результат передать в тестовый регистр
- JUMP addr — Перепрыгнуть (jump) к указанному адресу
- JEQ addr — Если выполняется условие равенства значений двух регистров, перепрыгнуть (jump) к указанному адресу
- JNEQ addr — Если условие равенства значений двух регистров не выполняется, перепрыгнуть (jump) к указанному адресу
- JG addr — Если значение больше, перепрыгнуть (jump) к указанному адресу
- JGE addr — Если значение больше или равно, перепрыгнуть (jump) к указанному адресу
- JL addr — Если значение меньше, перепрыгнуть (jump) к указанному адресу
- JLE addr — Если значение меньше или равно, перепрыгнуть (jump) к указанному адресу
- STOP — Остановить (stop) выполнение
Английские слова, обозначающие выполняемые действия, в скобках приведены неспроста. Так мы можем видеть, что язык ассемблера (как и многие другие языки программирования) основан на английском языке, то есть на привычном средстве общения тех людей, которые создавали цифровые технологии.
Работа микропроцессора на примере вычисления факториала
факториал от 5 = 5! = 5 * 4 * 3 * 2 * 1 = 120
На языке программирования C этот фрагмент кода, выполняющего данное вычисление, будет выглядеть следующим образом:
Когда эта программа завершит свою работу, переменная f будет содержать значение факториала от пяти.
Компилятор C транслирует (то есть переводит) этот код в набор инструкций языка ассемблера. В рассматриваемом нами процессоре оперативная память начинается с адреса 128, а постоянная память (которая содержит язык ассемблера) начинается с адреса 0. Следовательно, на языке данного процессора эта программа будет выглядеть так:
// Предположим, что a по адресу 128// Предположим, что F по адресу 1290 CONB 1 // a=1;1 SAVEB 1282 CONB 1 // f=1;3 SAVEB 1294 LOADA 128 // if a > 5 the jump to 175 CONB 56 COM7 JG 178 LOADA 129 // f=f*a;9 LOADB 12810 MUL11 SAVEC 12912 LOADA 128 // a=a+1;13 CONB 114 ADD15 SAVEC 12816 JUMP 4 // loop back to if17 STOP
Теперь возникает следующий вопрос: а как же все эти команды выглядят в постоянной памяти? Каждая из этих инструкций должна быть представлена в виде двоичного числа. Чтобы упростить понимание материала, предположим, что каждая из команд языка ассемблера рассматриваемого нами процессора имеет уникальный номер:
- LOADA — 1
- LOADB — 2
- CONB — 3
- SAVEB — 4
- SAVEC mem — 5
- ADD — 6
- SUB — 7
- MUL — 8
- DIV — 9
- COM — 10
- JUMP addr — 11
- JEQ addr — 12
- JNEQ addr — 13
- JG addr — 14
- JGE addr — 15
- JL addr — 16
- JLE addr — 17
- STOP — 18
Будем считать эти порядковые номера кодами машинных команд (opcodes). Их еще называют кодами операций. При таком допущении, наша небольшая программа в постоянной памяти будет представлена в таком виде:
// Предположим, что a по адресу 128// Предположим, что F по адресу 129Addr машинная команда/значение0 3 // CONB 11 12 4 // SAVEB 1283 1284 3 // CONB 15 16 4 // SAVEB 1297 1298 1 // LOADA 1289 12810 3 // CONB 511 512 10 // COM13 14 // JG 1714 3115 1 // LOADA 12916 12917 2 // LOADB 12818 12819 8 // MUL20 5 // SAVEC 12921 12922 1 // LOADA 12823 12824 3 // CONB 125 126 6 // ADD27 5 // SAVEC 12828 12829 11 // JUMP 430 831 18 // STOP
Как вы заметили, семь строчек кода на языке C были преобразованы в 18 строчек на языке ассемблера. Они заняли в ПЗУ 32 байта.
Декодирование
Дешифратор команд нужен для того, чтобы перевести каждый машинный код в набор сигналов, приводящих в действие различные компоненты микропроцессора. Если упростить суть его действий, то можно сказать, что именно он согласует «софт» и «железо».
Рассмотрим работу дешифратора команд на примере инструкции ADD, выполняющей действие сложения:
- В течение первого цикла тактовой частоты процессора происходит загрузка команды. На этом этапе дешифратору команд необходимо: активировать буфер сортировки для счетчика команд; активировать канал чтения (RD); активировать защелку буфера сортировки на пропуск входных данных в регистр команд
- В течение второго цикла тактовой частоты процессора команда ADD декодируется. На этом этапе арифметико-логическое устройство выполняет сложение и передает значение в регистр C
- В течение третьего цикла тактовой частоты процессора счетчик команд увеличивает свое значение на единицу (теоретически, это действие пересекается с происходившим во время второго цикла)
Каждая команда может быть представлена в виде набора последовательно выполняемых операций, которые в определенном порядке манипулируют компонентами микропроцессора. То есть программные инструкции ведут ко вполне физическим изменениям: например, изменению положения защелки. Некоторые инструкции могут потребовать на свое выполнение двух или трех тактовых циклов процессора. Другим может потребоваться даже пять или шесть циклов.
Микропроцессоры: производительность и тенденции
Многие транзисторы поддерживают технологию конвейеризации. В рамках конвейерной архитектуры происходит частичное наложение выполняемых инструкций друг на друга. Инструкция может требовать на свое выполнение все тех же пяти циклов, но если процессором одновременно обрабатываются пять команд (на разных этапах завершенности), то в среднем на выполнение одной инструкции потребуется один цикл тактовой частоты процессора.
Во многих современных процессорах дешифратор команд не один. И каждый из них поддерживает конвейеризацию. Это позволяет выполнять более одной инструкции за один такт процессора. Для реализации этой технологии требуется невероятное множество транзисторов.
64-битные процессоры
Основная причина, по которой процессорам нужна 64-битность, состоит в том, что данная архитектура расширяет адресное пространство. 32-битные процессоры могут получать доступ только к двум или четырем гигабайтам оперативной памяти. Когда-то эти цифры казались гигантскими, но миновали годы и сегодня такой памятью никого уже не удивишь. Несколько лет назад память обычного компьютера составляла 256 или 512 мегабайт. В те времена четырехгигабайтный лимит мешал только серверам и машинам, на которых работают большие базы данных.
Но очень быстро оказалось, что даже обычным пользователям порой не хватает ни двух, ни даже четырех гигабайт оперативной памяти. 64-битных процессоров это досадное ограничение не касается. Доступное им адресное пространство в наши дни кажется бесконечным: два в шестьдесят четвертой степени байт, то есть что-то около миллиарда гигабайт. В обозримом будущем столь гигантской оперативной памяти не предвидится.
64-битная адресная шина, а также широкие и высокоскоростные шины данных соответствующих материнских плат, позволяют 64-битным компьютерам увеличить скорость ввода и вывода данных в процессе взаимодействия с такими устройствами, как жесткий диск и видеокарта. Эти новые возможности значительно увеличивают производительность современных вычислительных машин.
Но далеко не все пользователи ощутят преимущества 64-битной архитектуры. Она необходима, прежде всего, тем, кто занимается редактированием видео и фотографий, а также работает с различными большими картинками. 64-битные компьютеры по достоинству оценены ценителями компьютерных игр. Но те пользователи, которые с помощью компьютера просто общаются в социальных сетях и бродят по веб-просторам да редактируют текстовые файлы никаких преимуществ этих процессоров, скорее всего, просто не почувствуют.
1.1. Что такое микропроцессор?
Ядром любой микропроцессорной системы является микропроцессор или просто процессор (от английского processor). Перевести на русский язык это слово правильнее всего как «обработчик», так как именно микропроцессор — это тот узел, блок, который производит всю обработку информации внутри микропроцессорной системы . Остальные узлы выполняют всего лишь вспомогательные функции: хранение информации (в том числе и управляющей информации, то есть программы), связи с внешними устройствами, связи с пользователем и т.д. Процессор заменяет практически всю «жесткую логику», которая понадобилась бы в случае традиционной цифровой системы. Он выполняет арифметические функции (сложение, умножение и т.д.), логические функции (сдвиг, сравнение, маскирование кодов и т.д.), временное хранение кодов (во внутренних регистрах), пересылку кодов между узлами микропроцессорной системы и многое другое. Количество таких элементарных операций, выполняемых процессором, может достигать нескольких сотен. Процессор можно сравнить с мозгом системы.
Но при этом надо учитывать, что все свои операции процессор выполняет последовательно, то есть одну за другой, по очереди. Конечно, существуют процессоры с параллельным выполнением некоторых операций, встречаются также микропроцессорные системы, в которых несколько процессоров работают над одной задачей параллельно, но это редкие исключения. С одной стороны, последовательное выполнение операций — несомненное достоинство, так как позволяет с помощью всего одного процессора выполнять любые, самые сложные алгоритмы обработки информации. Но, с другой стороны, последовательное выполнение операций приводит к тому, что время выполнения алгоритма зависит от его сложности. Простые алгоритмы выполняются быстрее сложных. То есть микропроцессорная система способна сделать все, но работает она не слишком быстро, ведь все информационные потоки приходится пропускать через один-единственный узел — микропроцессор (рис. 1.3). В традиционной цифровой системе можно легко организовать параллельную обработку всех потоков информации, правда, ценой усложнения схемы.

Рис. 1.3. Информационные потоки в микропроцессорной системе.
Итак, микропроцессор способен выполнять множество операций. Но откуда он узнает, какую операцию ему надо выполнять в данный момент? Именно это определяется управляющей информацией, программой. Программа представляет собой набор команд (инструкций), то есть цифровых кодов, расшифровав которые, процессор узнает, что ему надо делать. Программа от начала и до конца составляется человеком, программистом, а процессор выступает в роли послушного исполнителя этой программы, никакой инициативы он не проявляет (если, конечно, исправен). Поэтому сравнение процессора с мозгом не слишком корректно. Он всего лишь исполнитель того алгоритма, который заранее составил для него человек. Любое отклонение от этого алгоритма может быть вызвано только неисправностью процессора или каких-нибудь других узлов микропроцессорной системы.
Все команды, выполняемые процессором, образуют систему команд процессора. Структура и объем системы команд процессора определяют его быстродействие, гибкость, удобство использования. Всего команд у процессора может быть от нескольких десятков до нескольких сотен. Система команд может быть рассчитана на узкий круг решаемых задач (у специализированных процессоров) или на максимально широкий круг задач (у универсальных процессоров). Коды команд могут иметь различное количество разрядов (занимать от одного до нескольких байт). Каждая команда имеет свое время выполнения, поэтому время выполнения всей программы зависит не только от количества команд в программе, но и от того, какие именно команды используются.
Для выполнения команд в структуру процессора входят внутренние регистры, арифметико-логическое устройство (АЛУ, ALU — Arithmetic Logic Unit) , мультиплексоры, буферы, регистры и другие узлы. Работа всех узлов синхронизируется общим внешним тактовым сигналом процессора. То есть процессор представляет собой довольно сложное цифровое устройство (рис. 1.4).

Рис. 1.4. Пример структуры простейшего процессора.
Впрочем, для разработчика микропроцессорных систем информация о тонкостях внутренней структуры процессора не слишком важна. Разработчик должен рассматривать процессор как «черный ящик«, который в ответ на входные и управляющие коды производит ту или иную операцию и выдает выходные сигналы. Разработчику необходимо знать систему команд, режимы работы процессора, а также правила взаимодействия процессора с внешним миром или, как их еще называют, протоколы обмена информацией. О внутренней структуре процессора надо знать только то, что необходимо для выбора той или иной команды, того или иного режима работы.

1.2. Шинная структура связей
Для достижения максимальной универсальности и упрощения протоколов обмена информацией в микропроцессорных системах применяется так называемая шинная структура связей между отдельными устройствами, входящими в систему. Суть шинной структуры связей сводится к следующему.

Рис. 1.5. Классическая структура связей.
При классической структуре связей (рис. 1.5) все сигналы и коды между устройствами передаются по отдельным линиям связи. Каждое устройство, входящее в систему, передает свои сигналы и коды независимо от других устройств. При этом в системе получается очень много линий связи и разных протоколов обмена информацией.
При шинной структуре связей (рис. 1.6) все сигналы между устройствами передаются по одним и тем же линиям связи, но в разное время (это называется мультиплексированной передачей). Причем передача по всем линиям связи может осуществляться в обоих направлениях (так называемая двунаправленная передача). В результате количество линий связи существенно сокращается, а правила обмена (протоколы) упрощаются. Группа линий связи, по которым передаются сигналы или коды как раз и называется шиной (англ. bus).
Понятно, что при шинной структуре связей легко осуществляется пересылка всех информационных потоков в нужном направлении, например, их можно пропустить через один процессор, что очень важно для микропроцессорной системы. Однако при шинной структуре связей вся информация передается по линиям связи последовательно во времени, по очереди, что снижает быстродействие системы по сравнению с классической структурой связей.

Рис. 1.6. Шинная структура связей.
Большое достоинство шинной структуры связей состоит в том, что все устройства, подключенные к шине, должны принимать и передавать информацию по одним и тем же правилам (протоколам обмена информацией по шине ). Соответственно, все узлы, отвечающие за обмен с шиной в этих устройствах, должны быть единообразны, унифицированы.
Существенный недостаток шинной структуры связан с тем, что все устройства подключаются к каждой линии связи параллельно. Поэтому любая неисправность любого устройства может вывести из строя всю систему, если она портит линию связи. По этой же причине отладка системы с шинной структурой связей довольно сложна и обычно требует специального оборудования.
В системах с шинной структурой связей применяют все три существующие разновидности выходных каскадов цифровых микросхем:
стандартный выход или выход с двумя состояниями (обозначается 2С, 2S, реже ТТЛ, TTL);
выход с открытым коллектором (обозначается ОК, OC);
выход с тремя состояниями или (что то же самое) с возможностью отключения (обозначается 3С, 3S).
Упрощенно эти три типа выходных каскадов могут быть представлены в виде схем на рис. 1.7.
У выхода 2С два ключа замыкаются по очереди, что соответствует уровням логической единицы (верхний ключ замкнут) и логического нуля (нижний ключ замкнут). У выхода ОК замкнутый ключ формирует уровень логического нуля, разомкнутый — логической единицы. У выхода 3С ключи могут замыкаться по очереди (как в случае 2С), а могут размыкаться одновременно, образуя третье, высокоимпедансное состояние. Переход в третье состояние (Z-состояние) управляется сигналом на специальном входе EZ.

Рис. 1.7. Три типа выходов цифровых микросхем.
Выходные каскады типов 3С и ОК позволяют объединять несколько выходов микросхем для получения мультиплексированных (рис. 1.8) или двунаправленных (рис. 1.9) линий.

Рис. 1.8. Мультиплексированная линия.

Рис. 1.9. Двунаправленная линия.
При этом в случае выходов 3С необходимо обеспечить, чтобы на линии всегда работал только один активный выход, а все остальные выходы находились бы в это время в третьем состоянии, иначе возможны конфликты. Объединенные выходы ОК могут работать все одновременно, без всяких конфликтов.
Типичная структура микропроцессорной системы приведена на рис. 1.10. Она включает в себя три основных типа устройств:
память, включающую оперативную память ( ОЗУ, RAM — Random Access Memory ) и постоянную память ( ПЗУ, ROM —Read Only Memory ), которая служит для хранения данных и программ;
устройства ввода/вывода ( УВВ, I/O — Input/Output Devices ), служащие для связи микропроцессорной системы с внешними устройствами, для приема (ввода, чтения, Read) входных сигналов и выдачи (вывода, записи, Write) выходных сигналов.

Рис. 1.10. Структура микропроцессорной системы.
Все устройства микропроцессорной системы объединяются общей системной шиной (она же называется еще системной магистралью или каналом ). Системная магистраль включает в себя четыре основные шины нижнего уровня:
шина адреса (Address Bus);
шина данных (Data Bus);
шина управления (Control Bus);
шина питания (Power Bus).
Шина адреса служит для определения адреса (номера) устройства, с которым процессор обменивается информацией в данный момент. Каждому устройству (кроме процессора), каждой ячейке памяти в микропроцессорной системе присваивается собственный адрес. Когда код какого-то адреса выставляется процессором на шине адреса, устройство, которому этот адрес приписан, понимает, что ему предстоит обмен информацией. Шина адреса может быть однонаправленной или двунаправленной.
Шина данных — это основная шина, которая используется для передачи информационных кодов между всеми устройствами микропроцессорной системы. Обычно в пересылке информации участвует процессор, который передает код данных в какое-то устройство или в ячейку памяти или же принимает код данных из какого-то устройства или из ячейки памяти. Но возможна также и передача информации между устройствами без участия процессора. Шина данных всегда двунаправленная.
Шина управления в отличие от шины адреса и шины данных состоит из отдельных управляющих сигналов. Каждый из этих сигналов во время обмена информацией имеет свою функцию. Некоторые сигналы служат для стробирования передаваемых или принимаемых данных (то есть определяют моменты времени, когда информационный код выставлен на шину данных). Другие управляющие сигналы могут использоваться для подтверждения приема данных, для сброса всех устройств в исходное состояние, для тактирования всех устройств и т.д. Линии шины управления могут быть однонаправленными или двунаправленными.
Наконец, шина питания предназначена не для пересылки информационных сигналов, а для питания системы. Она состоит из линий питания и общего провода. В микропроцессорной системе может быть один источник питания (чаще +5 В) или несколько источников питания (обычно еще –5 В, +12 В и –12 В). Каждому напряжению питания соответствует своя линия связи. Все устройства подключены к этим линиям параллельно.
Если в микропроцессорную систему надо ввести входной код (или входной сигнал), то процессор по шине адреса обращается к нужному устройству ввода/вывода и принимает по шине данных входную информацию. Если из микропроцессорной системы надо вывести выходной код (или выходной сигнал), то процессор обращается по шине адреса к нужному устройству ввода/вывода и передает ему по шине данных выходную информацию.
Если информация должна пройти сложную многоступенчатую обработку, то процессор может хранить промежуточные результаты в системной оперативной памяти. Для обращения к любой ячейке памяти процессор выставляет ее адрес на шину адреса и передает в нее информационный код по шине данных или же принимает из нее информационный код по шине данных. В памяти (оперативной и постоянной) находятся также и управляющие коды (команды выполняемой процессором программы), которые процессор также читает по шине данных с адресацией по шине адреса. Постоянная память используется в основном для хранения программы начального пуска микропроцессорной системы, которая выполняется каждый раз после включения питания. Информация в нее заносится изготовителем раз и навсегда.
Таким образом, в микропроцессорной системе все информационные коды и коды команд передаются по шинам последовательно, по очереди. Это определяет сравнительно невысокое быстродействие микропроцессорной системы. Оно ограничено обычно даже не быстродействием процессора (которое тоже очень важно) и не скоростью обмена по системной шине (магистрали), а именно последовательным характером передачи информации по системной шине (магистрали).
Важно учитывать, что устройства ввода/вывода чаще всего представляют собой устройства на «жесткой логике». На них может быть возложена часть функций, выполняемых микропроцессорной системой. Поэтому у разработчика всегда имеется возможность перераспределять функции системы между аппаратной и программной реализациями оптимальным образом. Аппаратная реализация ускоряет выполнение функции, но имеет недостаточную гибкость. Программная реализация значительно медленнее, но обеспечивает высокую гибкость. Аппаратная реализация функций увеличивает стоимость системы и ее энергопотребление, программная — не увеличивает. Чаще всего применяется комбинирование аппаратных и программных функций.
Иногда устройства ввода/вывода имеют в своем составе процессор, то есть представляют собой небольшую специализированную микропроцессорную систему. Это позволяет переложить часть программных функций на устройства ввода/вывода, разгрузив центральный процессор системы.
За какие операции отвечает микропроцессор
Микропроцессорная система. Принципы, назначение, архитектура микропроцессорных систем
Микропроцессор (МП) — это устройство, которое осуществляет прием, обработку и выдачу информации. Конструктивно МП содержит одну или несколько интегральных схем и выполняет действия, определенные программой, записанной в памяти.
Микропроцессорная система — это вычислительная, контрольно-измерительная или управляющая система, основным устройством обработки информации в которой является МП. Микропроцессорная система строится из набора микропроцессорных больших интегральных схем БИС.
Мультимикропроцессорная (или мультипроцессорная) система — система, которая образуется объединением некоторого количества универсальных или специализированных МП, благодаря чему обеспечивается параллельная обработка информации и распределенное управление.
Микропроцессорный комплект (МПК) — совокупность интегральных схем, совместимых по электрическим, информационным и конструктивным параметрам и предназначенных для построения электронно-вычислительной аппаратуры и микропроцессорных систем управления.
В типичный состав МПК входят:
- БИС МП (один или несколько корпусов интегральных схем);
- БИС оперативных запоминающих устройств (ОЗУ);
- БИС постоянных запоминающих устройств (ПЗУ);
- БИС интерфейсов или контроллеров внешних устройств;
- служебные БИС (тактовый генератор, регистры, шинные формирователи, контроллеры шин, арбитры шин).
Микропроцессоры и МПК классифицируют по таким признакам: назначение; количество; способ управления; тип архитектуры; тип системы команд.
По назначению МП разделяют на универсальные и специализированные.
В основу построения МПС-систем положено три принципа:
- магистральности;
- модульности;
- микропрограммного управления.
Принцип магистральности определяет характер связей между функциональными блоками МПС — все блоки соединяются с единой системной шиной. Принципы магистральности и модульности позволяют наращивать управляющие и вычислительные возможности МП путем подсоединения других модулей к системной шине.
Принцип микропрограммного управления состоит в возможности осуществления элементарных операций — микрокоманд (сдвигов, пересылок информации, логических операций).
Используя определенные комбинации микрокоманд, можно создать технологический язык, т. е. набор команд, который максимально соответствует назначению системы. В секционных процессорах набор микрокоманд можно изменить, используя другие микросхемы памяти микрокоманд.
Рассмотрим структурную схему микропроцессорной системы (МПС), приведенную на рисунке 1.
Функционирование МПС сводится к следующей последовательности действий: получение данных от различных периферийных устройств (с клавиатуры терминала, от дисплеев, из каналов связи, от различного типа внешних запоминающих устройств), обработка данных и выдача результатов обработки на периферийные устройства (ПУ). При этом данные от ПУ, подлежащие обработке, могут поступать и в процессе их обработки.
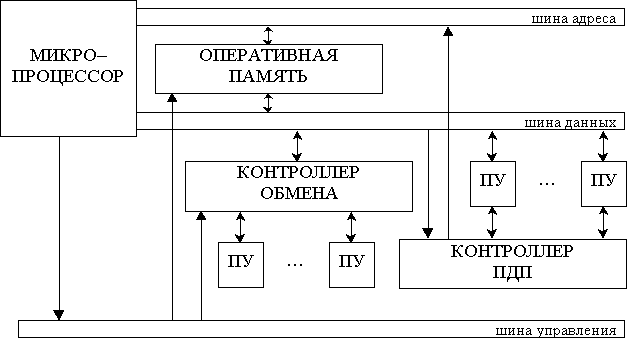
Рисунок 1 – Структурная схема микропроцессорной системы
Для выполнения этих действий в МПС кроме микропроцессора предусматриваются следующие устройства: — оперативная память (ОП), предназначенная для хранения и выдачи по запросам команд программ, определяющих работу микропроцессора, различных данных (исходных данных, промежуточных и конечных результатов обработки данных в микропроцессоре); — контроллеры — устройства, обеспечивающие обмен данными различных ПУ с микропроцессором и ОП.
Микропроцессор выдает на шину адреса номер (адрес) ячейки ОП, в которой хранится очередная команда, и из шины управления в ОП поступают сигналы, обеспечивающие считывание содержимого указываемой шиной адреса ячейки памяти.
Оперативная память выдает запрошенную команду на шину данных, откуда она принимается в микропроцессор. Здесь команда расшифровывается. Если данные, действия над которыми предусматривает команда, находятся в регистрах микропроцессора, то микропроцессор приступает к выполнению указанной в команде операции. Если при расшифровке команды выяснится, что участвующие в операции данные находятся в ОП, то микропроцессор выставляет на шину адреса адрес ячейки, хранящей эти данные; после выдачи данных из ОП микропроцессор принимает их через шину данных, затем выполняется операция над данными.
После завершения текущей команды на шину адреса выдается адрес следующей команды, и описанный процесс повторяется.
Обмен данными с ПУ может осуществляться следующим образом. Группа ПУ подключается к шине данных МПС через контроллер обмена (устройства сопряжения), управляющий процессом обмена данными. До начала непосредственного обмена данными с ПУ микропроцессор через шину данных должен выдать в контроллер информацию о режимах, используемых при передаче, направлениях передачи данных (от микропроцессора к ПУ либо, наоборот, от ПУ к микропроцессору), используемых в дальнейшем при обмене данными с каждым из подключенных к контроллеру ПУ. Затем в момент, когда потребуется, например, передать в ОП выдаваемые из ПУ данные, микропроцессор, выполняя команду ввода, подает на контроллер соответствующие управляющие сигналы; данные из ПУ принимаются в регистр контроллера, откуда они затем контроллером выдаются на шину данных. Далее эти данные с шины данных принимаются в микропроцессор, после чего в процессе выполнения соответствующей команды они передаются в ОП.
Аналогично происходит обмен данными в обратном направлении — от ОП к ПУ. По соответствующей команде программы осуществляется прием из ОП в микропроцессор данных, подлежащих передаче, после чего по одной из следующих команд эти данные выдаются на шину данных и через контроллер обмена передаются на УП.
Описанный обмен предполагает, что моменты обмена данными известны заранее уже на этапе программирования, и в программе предусматриваются в определенных местах соответствующие команды, обеспечивающие обмен. Моменты обмена могут определяться и самим ПУ. Тогда эти моменты программисту оказываются неизвестными, он не может предусмотреть в программе соответствующие команды обмена. В этих случаях ПУ, подавая в микропроцессор определенные сигналы, переводит его в состояние так называемого прерывания.
В этом состоянии микропроцессор прекращает выполнение основной программы и переходит к исполнению команд другой хранящейся в ОП программы (прерывающей программы), обеспечивающей обмен данными, требуемый периферийным устройством.
После окончания такой прерывающей программы микропроцессор возвращается к выполнению основной программы.
Описанные способы обеспечивают низкую скорость обмена, и применять их целесообразно при обмене данными с низкоскоростными ПУ.
При работе с высокоскоростными ПУ (такими, как запоминающие устройства на дисках и др.) используется так называемый режим прямого доступа к памяти (ПДП). В этом режиме микропроцессор отключается от шин адреса и данных, предоставляя их в распоряжение ПУ для непосредственного обмена данными с ОП (без участия микропроцессора). Обмен при этом организуется специальным контроллером ПДП.
В режиме ПДП ПУ обменивается с ОП не одиночными данными, а большими блоками данных. В контроллер ПДП микропроцессор предварительно помещает информацию, необходимую для управления обменом (адрес ячейки ОП, куда помещается или откуда считывается первое подлежащее обмену слово, количество слов в блоке и др.). В процессе обмена контроллер ПДП выдает на шину адреса адрес ячейки ОП, после окончания передачи слова между ОП и ПУ через шину данных контроллер ПДП увеличивает на единицу значение адреса, выдаваемого на шину адреса. После завершения передачи заданного количества слов контроллер ПДП прекращает обмен, информируя об этом микропроцессор. Последний восстанавливает связь с шинами адреса и данных и продолжает выполнение программы.
1. Критерии оценки качества микропроцессорной системы
Основными критериями оценки качества микропроцессорных систем являются: производительность, точность, надежность.
Пиковая или техническая производительность представляет собой теоретический максимум быстродействия микропроцессорной системы при идеальных условиях. Данный максимум определяется как число вычислительных операций, выполняемое в единицу времени имеющимися в системе обрабатывающими логико-арифметическими устройствами.
Предельное быстродействие достигается при обработке бесконечной последовательности несвязанных между собой и неконфликтующих при доступе в память команд (т.е. когда результат любой операции не зависит от действий, выполненных другими командами). Разумеется подобная ситуация чисто гипотетическая, и на практике ни одна система не в состоянии работать длительное время с пиковой производительностью, хотя и может приближаться к этой величине. 10 Хорошим показателем является производительность в диапазоне от 0,8 до 0,9 от пикового значения.
При выполнении реальных прикладных программ эффективная производительность может быть существенно меньше пиковой. Характеристики функционирования микропроцессорной системы на уровне внутренних устройств существенно зависят от программы и обрабатываемых данных. Поэтому невозможно оценить производительность только на основании их тактовой частоты.
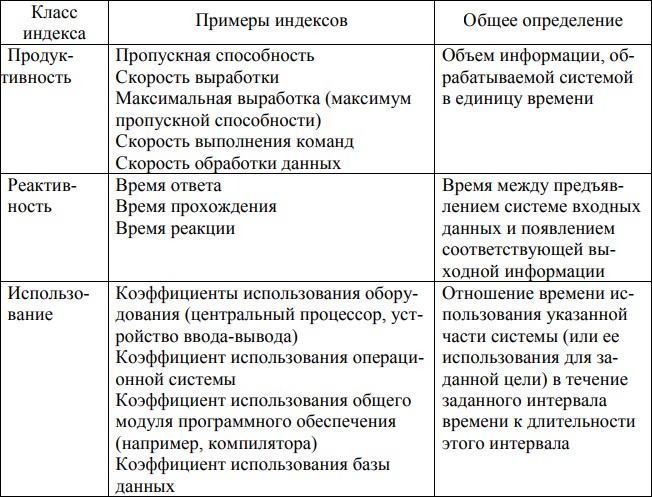
Для оценки производительности вычислительных средств используется набор характерных задач. Время выполнения каждой из задач набора составляет основу для расчета индекса производительности исследуемой вычислительной системы. Индекс производительности является относительной оценкой, несущей информацию о том, насколько быстрее или медленнее исследуемая система выполняет задачи по сравнению с некоторой эталонной системой. Если определить производительность эталонной системы, вычисляемую числом выполняемых в секунду вычислительных операций, то можно определить абсолютное значение производительности исследуемой микропроцессорной системы.
В таблице 1 приведены основные классы количественных индексов производительности вычислительных систем.
Таблица 1 – Основные классы количественных индексов производительности вычислительных систем
Расчет показателей эффективности сложных систем, т.е. задача анализа производительности, представляет собой весьма сложную задачу, которая требует привлечения специальных математических методов и, как правило, решается с помощью ЭВМ. Показатели эффективности зависят от структуры системы, значений ее параметров, характера воздействия внешней среды, внешних и внутренних случайных факторов, поэтому их можно считать функционалами.
В настоящее время качество микропроцессорных систем оценивается соотношением «производительность/энергопотребление». Снижение энергопотребления без снижения производительности – актуальная задача проектирования микропроцессорных систем.
Точность работы микропроцессорной системы определяется погрешностью вычислений выходных параметров системы. Это показатель является составным и определяется не только точностью вычислений процессора, но и точностью приборов, входящих в состав микропроцессорной системы (разнообразных датчиков, преобразующих, корректирующих устройств и т.д.).
Надежность. Основным понятием теории надежности является, как известно, отказ — событие, заключающееся в нарушении работоспособности. Для сложных же объектов, особенно человеко-машинных систем, отсутствие отказов, как показывает практика, еще не гарантирует отсутствия опасных ситуаций, приводящих к нарушению безопасности функционирования (НБФ). Это связано с тем, что на функционирование технического средства кроме его надежности оказывают влияние различные внешние причины.
Виды отказов: отказы технических средств; воздействия человека (ошибки операторов, обслуживающего персонала); природные явления (грозы, пожары и т. п.). Опасный отказ приводит или может привести к опасной ситуации. Поэтому в теории надежности важное место занимает безопасность функционирования техники (БФТ). Существуют два основных пути обеспечения БФТ: предотвращение нарушений, нормальных режимов работы и парирование последствий возникших нарушений нормального функционирования.
На этапе разработки и проектирования технических решений выбирают алгоритмы функционирования систем по критерию БФТ; повышают отказоустойчивость и живучесть технических средств, создают безопасное программное обеспечение микропроцессорных информационноуправляющих систем. С точки, зрения безопасности функционирования сложные технические системы, должны иметь не только повышенную надежность, т.е. малую вероятность появления отказов, но и обладать свойством отказоустойчивости — способностью сохранять работоспособность с заданным качеством в случае отказа их элементов.
Мерой отказоустойчивости является живучесть. Техническая система, имеющая свойство живучести, выполняет свои функции с заданными характеристиками при наличии в ней некоторого числа неисправных элементов, и качественные показатели системы постепенно ухудшаются (деградируют) при увеличении числа отказов. Такая система является отказоустойчивой до отказа некоторой кратности и постепенно деградирует с увеличением числа отказов. Количественно живучесть определяется коэффициентом живучести, 12 который для данного обобщенного отказа представляет собой отношение числа состояний, соответствующих работоспособной системе, ко всей совокупности состояний.
Методы повышения живучести сложных систем могут быть активными и пассивными по отношению к внешним вредным; воздействиям, приложенным к системе.
При активном методе отказы обнаруживаются при помощи средств контроля, локализируются диагностированием и устраняются автоматической реконфигурацией системы, которая заключается в перестройке структуры системы с целью отключения отказавших узлов.
Пассивные методы основаны на функциональном резервировании, при котором одни и тек же элементы при необходимости могут выполнять различные функции в системе, а также резервирование одних элементов другими, в основу принципа действия которых положены различные физические процессы. При этом возможно ухудшение показателей качества функционирования системы.
2. Архитектура микропроцессорных систем
В настоящее время широкое распространение получил модульный принцип организации микроконтроллеров (МК), при котором на базе одного процессорного ядра (центрального процессора) проектируется ряд (линейка) МК, различающихся объемом и типом памяти программ, объемом памяти данных, набором периферийных модулей, частотой синхронизации. При модульном принципе построения все МК одного семейства содержат процессорное ядро, одинаковое для всех МК данного семейства, и изменяемый функциональный блок, который отличает МК разных моделей.
Структура модульного МК приведена на рисунке 2.
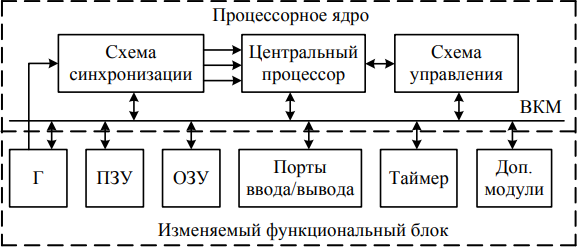
Рисунок 2 – Модульная организация микроконтроллера
Процессорное ядро включает в себя:
- центральный процессор;
- внутреннюю контроллерную магистраль (ВКМ) в составе шин адреса, данных и управления;
- схему синхронизации МК;
- схему управления режимами работы МК, включая поддержку режимов пониженного энергопотребления, начального запуска (сброса) и т.д.
Изменяемый функциональный блок включает в себя модули памяти различного типа и объема, порты ввода/вывода, модули тактовых генераторов (Г), таймеры. В относительно простых МК модуль обработки прерываний входит в состав процессорного ядра. В более сложных МК он представляет собой отдельный модуль с развитыми возможностями. В состав изменяемого функционального блока могут входить и такие дополнительные модули, как компараторы напряжения, аналого-цифровые преобразователи (АЦП) и другие. Каждый модуль проектируется для работы в составе МК с учетом протокола ВКМ. Данный подход позволяет создавать разнообразные по структуре МК в пределах одного семейства.
С точки зрения организации процессов выборки и исполнения команды в современных МК применяется одна из двух архитектур микропроцессорных систем (МПС): фон-неймановская (принстонская) или гарвардская. Основной особенностью фон-неймановской архитектуры является использование общей памяти для хранения программ и данных, как показано на рисунке. 3.
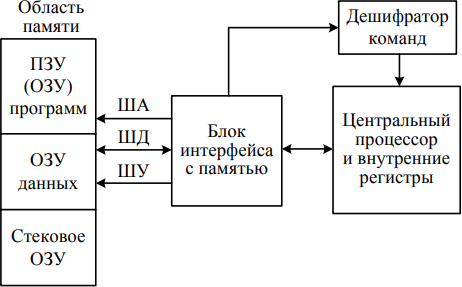
Рисунок 3 – Микропроцессор с фон-неймановской архитектурой
Основное преимущество архитектуры Фон-Неймана – упрощение устройства МПС, так как реализуется обращение только к одной общей памяти. Кроме того, использование единой области памяти позволяло оперативно перераспределять ресурсы между областями программ и данных, что существенно повышало гибкость МПС с точки зрения разработчика программного обеспечения.
Размещение стека в общей памяти облегчало доступ к его содержимому. Неслучайно поэтому фон-неймановская архитектура стала основной архитектурой универсальных компьютеров, включая персональные компьютеры.
Основной особенностью гарвардской архитектуры является использование раздельных адресных пространств для хранения команд и данных, как показано на рисунке 4.
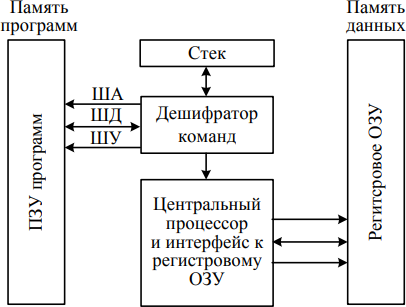
Рисунок 4 – Микропроцессор с гарвардской архитектурой
Гарвардская архитектура долго не использовалось, пока производители МК не поняли, что она дает определенные преимущества разработчикам автономных систем управления. Дело в том, что, судя по опыту использования МПС для управления различными объектами, для реализации большинства алгоритмов управления такие преимущества фон-неймановской архитектуры, как гибкость и универсальность, не имеют большого значения. Анализ реальных программ управления показал, что необходимый объем памяти данных МК, используемый для хранения промежуточных результатов, как правило, на порядок меньше требуемого объема памяти программ.
В этих условиях использование единого адресного пространства приводило к увеличению формата команд за счет увеличения числа разрядов для адресации операндов. Применение отдельной небольшой по объему памяти данных способствовало сокращению длины команд и ускорению поиска информации в памяти данных.
Кроме того, гарвардская архитектура обеспечивает потенциально более высокую скорость выполнения программы по сравнению с фон-неймановской за счет возможности реализации параллельных операций.
Выборка следующей команды может происходить одновременно с выполнением предыдущей, и нет необходимости останавливать процессор на время выборки команды. Этот метод реализации операций позволяет обеспечивать выполнение различных команд за одинаковое число тактов, что дает возможность более просто определить время выполнения циклов и критичных участков программы. Большинство производителей современных МК используют гарвардскую архитектуру.
Однако гарвардская архитектура является недостаточно гибкой для реализации некоторых программных процедур. Поэтому сравнение МК, выполненных по разным архитектурам, следует проводить применительно к конкретному приложению.
Архитектура фон Неймана носит более универсальный характер применения, Гарвардская архитектура – более специализирована.
3. Назначение и область применения микропроцессоров
Применение микропроцессорных систем практически во всех электрических устройствах — важнейшая черта технической инфраструктуры современного общества. Электроэнергетика, промышленность, транспорт, системы связи существенно зависят от компьютерных систем управления. Микропроцессорные системы встраиваются в измерительные приборы, электрические аппараты, осветительные установки и д.р.
Всё это обязывает электрика знать хотя бы основы работы микропроцессорной техники.
Микропроцессорные системы предназначены для автоматизации обработки информации и управления различными процессами.
Микропроцессорная система включает в себя аппаратное обеспечение или по-английски – hardware и программное обеспечение (ПО) — software.
Микропроцессорная систем а работает с цифровой информацией, которая представляет собой последовательность цифровых кодов.
В основе любой микропроцессорной системы лежит микропроцессор, который способен воспринимать только двоичные числа (составленные из 0 и 1). Двоичные числа записываются посредством двоичной системы счисления. Например, в повседневной жизни мы пользуемся десятичной системой счисления, в которой для записи чисел используются десять символов или цифр 0,1,2,3,4,5,6,7,8,9. Соответственно в двоичной системе таких символов (или цифр) всего два – 0 и 1.
Необходимо понимать, что система счисления – это всего лишь правила записи чисел, и выбор типа системы определятся удобством применения. Выбор двоичной системы обусловлен её простотой, а значит надёжностью работы цифровых устройств и лёгкостью их технической реализации.
Рассмотрим единицы измерения цифровой информации:
Бит (от английского «BInary digiT» — двоичная цифра) принимает только два значения: 0 или 1. Можно закодировать логическое значение «да» или «нет», состояние «включено» или «выключено», состояние «открыто» или «закрыто» и т.п.
Группа из восьми бит называется байтом, например 10010111. Один байт позволяет кодировать 256 значений: 00000000 – 0, 11111111 — 255.
Бит – наименьшая единица представления информации.
Байт — наименьшая единица обработки информации. Байт — часть машинного слова, состоящая обычно из 8 бит и используемая как единица количества информации при её хранении, передаче и обработке на ЭВМ. Байт служит для представления букв, слогов и специальных символов (занимающих обычно все 8 бит) или десятичных цифр (по 2 цифры в 1 байт).
Два взаимосвязанных байта называется словом, 4 байта – двойное слово, 8 байт – учетверённое слово.
Почти вся информация, которая нас окружает, является аналоговой. Поэтому, прежде чем информация попадёт на обработку в процессор, она подвергается преобразованию посредством АЦП (аналого-цифровой преобразователь). Кроме того, информация кодируется в определённом формате и может быть числовой, логической, текстовой (символьной), графической, видео и д.р.
Например, для кодирования текстовой информации используется таблица кодов ASCII (от англ. American Standard Code for Information Interchange — Американский стандартный код для обмена информацией). Запись одного символа осуществляется одним байтом, который может принимать 256 значений. Графическая информация разбивается на точки (пиксели) и производится кодирование цвета и положение каждой точки по горизонтали и вертикали.
Кроме двоичной и десятичной системы в МС используют шестнадцатеричную систему, в которой для записи чисел используются символы 0…9 и A…F, как это показано в таблице 2.2. Её применение обуславливается тем, что один байт описывается двухразрядным шестнадцатеричным числом, что значительно сокращает запись цифрового кода и делает его более читаемым (11111111 – FF).
Для определения значения числа (например, значения числа 100 для разных систем счисления может составлять 42, 10010, 25616), в конце числа добавляют латинскую букву, обозначающую систему счисления: для двоичных чисел букву b, для шестнадцатеричных — h, для десятичных – d.
Число без дополнительного обозначения считается десятичным.
Таблица 2 – Запись чисел в различных системах счисления
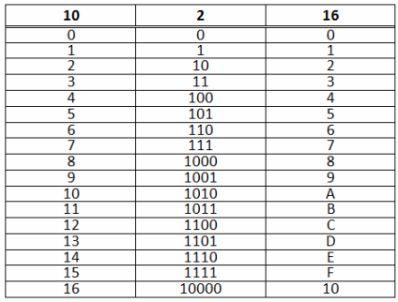
Перевод чисел из одной системы в другую и основные арифметические и логические операции над числами позволяет производить инженерный калькулятор (стандартное приложение операционной системы Windows).
Закон Мура устарел, а Apple совершила революцию. Вот как работает процессор в вашем компьютере
Процессор — основной элемент любого компьютера, планшета, смартфона, «умного» пылесоса или даже холодильника. При этом история «процессоростроения» пока относительно короткая. По сути, первые коммерческие микропроцессоры появились в 1970-х, когда драматически уменьшились в размерах. Но как в принципе работают современные процессоры? Каким образом они собираются, почему в последнее время компанию Apple связывают с революцией в этой области и по какой причине все говорят про превосходство какого-то ARM?
Что вообще такое микропроцессор и при чем тут транзисторы
Понятным языком можно сказать так: процессор представляет собой чип внутри устройства, который производит практически все вычисления. А эти вычисления основываются на применении транзисторов. Если упростить, то чем больше транзисторов на одной плате, тем лучше (то есть производительнее) весь CPU.

Для сравнения: первым микропроцессором считается Intel 4004 (1971 года выпуска). В нем установлено 2300 транзисторов. В этом году Apple представила систему на чипе A15 Bionic — на нем основывается последнее поколение iPhone. В A15 транзисторов уже 15 млрд.
При этом еще 50 лет назад (до появления процессора Intel 4004) транзисторы были в разы массивнее. Их продавали в специализированных радиотехнических лавках, а их «ножки» предлагалось спаивать самостоятельно. Но сейчас транзисторы уменьшились настолько, что их величина составляет всего несколько нанометров (это мера длины, равная одной миллиардной части метра). Их как бы «печатают» на кремниевых пластинах. Благодаря этому миллиарды транзисторов получается помещать на платах размером в несколько сантиметров.

В сети любят приводить такое описание работы транзисторов (оно также упрощенное, но показательное): транзисторы чем-то похожи на систему кранов и труб, которые выполняют только две базовые операции — либо пропускают через себя электрический ток, либо не пропускают. Если такие «краны и трубы» соединить (есть несколько способов), то устройство получится научить производить вычисления, то есть закодировать их на чтение и преобразование операций с нулями (нет тока) и единицами (есть ток).
По сути, таким образом процессор заставляют производить суммирование, умножение, сравнивание и другие, более сложные операции. И чем сложнее комбинации подобных операций, тем сложнее получается и результат — числами можно закодировать (если хотите, зашифровать) хоть текст, хоть нейронные сети.

Какие именно операции нужно производить в данный момент времени, процессор понимает, исходя из заложенных в него инструкций (то есть команд). Таких инструкций существует много. По мере развития микропроцессоров одни инструкции сменялись другими, но сегодня остались две основные архитектуры, применяемые, как правило, в персональных компьютерах и мобильных чипах: RISC и CISC. Про это подробнее поговорим ниже (во многом мнение насчет лидирующего положения Apple связано с переходом от одного набора инструкций к другому).
Почему так важен «чистый» кремний, как на него наносят транзисторы и при чем тут закон Мура
Процессоры создаются на кремниевой основе — все благодаря подходящей для подобных целей внутренней атомной структуре. Правда, процесс «добычи» кремния и уж тем более нанесения транзисторов и других компонентов еще более дорогой и сложный. По сути, поэтому сегодня «воспроизведением» микропроцессоров в основном занимаются всего несколько производств по всему миру. Среди них — Intel, Samsung, TSMC.

Источником кремния служит песок. Его долго обрабатывают химическим способом, чтобы получить так называемый «чистый» кремний (таким он считается при чистоте 99,9%) — на его основе производятся специальные кристаллы. Чтобы сделать подобное, кремний плавят и помещают внутрь маленький кристалл, формирующий вокруг себя еще один слой кристаллической решетки.
Так повторяется несколько раз, и в итоге добывается один большой монокристалл цилиндрической формы весом под сотню килограмм. Его нарезают алмазной пилой на диски диаметром порядка 30 сантиметров — такие вы наверняка видели на фотографиях, которыми иллюстрируют производство микроэлектроники, — и уже на них после тщательной шлифовки «печатают» транзисторы.

Мы уже рассказывали про тонкости этой процедуры в отдельном материале. Если вкратце, на эти диски воздействуют светом, чтобы создать мельчайшие детали будущих интегральных схем. Процесс называется фотолитографией: изначально с помощью системы линз и зеркал на поверхности светочувствительной кремниевой пластины фокусировали лучи света, которые проходили через заранее подготовленный шаблон и запечатлевали его схему на пластине.
Со временем процесс совершенствовался. Сперва источником света для литографии выступала ртутная лампа. Потом длину волны уменьшали, переходя от ртутных ламп к лазерам со смесями различных газов. Следующим поколением лазерных технологий стали устройства, излучающие свет с длиной волны 193 нанометра.

В конце концов пришли к технологии EUV — сверхжесткого ультрафиолетового излучения на длине волны 13,5 нанометра. Эта технология настолько сложная и уникальная, что сегодня в мире ей на достаточно высоком уровне занимается только одна компания — ASML. Она поставляет другим производителям электроники станки, которые и «печатают» компоненты системы на кремниевых дисках с требуемой точностью.
Уменьшение длины волны позволяет наносить на кремний больше транзисторов уменьшенных размеров, то есть увеличивать производительность чипа при сохранении его изначальных габаритов. Вы могли слышать про закон Мура, согласно которому каждые два года количество транзисторов, размещенных на одном и том же кристалле, удваивается.
Сейчас выяснилось, что это является скорее наблюдением одного из инженеров Intel, а не непреложным правилом. Однако оно дало «маркировку» понятию техпроцесса, которым сегодня производители электроники (что самих процессоров, что базирующихся на них смартфонов, компьютеров и прочей техники) любят щеголять во время презентаций.

В настоящее время «нанометровым техпроцессом» описывается условная цифра, означающая плотность размещения транзисторов или увеличение их количества относительно предыдущего техпроцесса.
Если объяснять еще проще, то чем меньше цифра перед словом «нанометровый», тем лучше. Процессоры, изготовленные по 5-нанометровому техпроцессу (на момент публикации материала считается передовым решением), ощутимо мощнее и в сравнении с теми, что базируются на 7-нанометровом. Через год-два производители планируют перейти на 3-нанометровый техпроцесс. Кроме того, у перехода на меньший техпроцесс есть еще одно преимущество: каждый транзистор начинает потреблять меньше электроэнергии, тем самым улучшая энергоэффективность всего устройства.
Что такое «система на чипе»
После того как на печатную плату наносят необходимые элементы, к ядру процессора добавляют контакты, чтобы его можно было вставить в материнскую плату, а сверху все это прикрывают крышкой. Последняя выполняет несколько функций: во-первых, защищает дорогостоящий кристалл с миллиардами транзисторов, а во-вторых, служит средством для отвода тепла во время работы CPU— воздушные кулеры или водяное охлаждение устанавливают на крышку не просто так.

В какой-то момент стало понятно, что чипы уже стали настолько миниатюрными, что под одной такой защитной крышкой вполне может уместиться не только сам CPU, но и другие компоненты — например, графический чип (GPU), отвечающий за вывод картинки на экран, а еще модули беспроводной связи и модемы. Решение, когда все критически важные для работы компьютера компоненты находятся вместе на одной интегральной схеме совсем рядом друг с другом, называется «система на чипе», или «система на кристалле» (System-on-a-Chip, SoC).
По сути, такие «системы на кристалле» используются практически во всей современной мобильной технике: смартфонах, планшетах, смарт-часах. В первую очередь — за счет относительно небольших габаритов и меньшего энергопотребления и тепловыделения, благодаря чему технику получается сделать мобильной. Правда, производительность подобных SoC долго оставалась существенно ниже в сравнении со «взрослыми» центральными (CPU) и графическими (GPU) процессорами, причем не только в ПК, но и ноутбуках.

Еще несколько лет назад дело обстояло так: существуют мощные процессоры (что графические, что центральные) для настольных компьютеров, которые производят гиганты вроде AMD и Intel, а есть относительно слабые «системы на чипе» (когда все компоненты собраны вместе) на базе ARM-архитектуры для мобильных переносных девайсов — и эти два мира долго практически никак не пересекались.
Но к концу 2020 года ситуация с подачи компании Apple изменилась. Выяснилось, что подобные «системы на чипе» могут быть не просто соизмеримы по мощности со «взрослыми» аналогами, но и превосходить их, при этом сохраняя преимущество в виде намного меньшего потребления энергии. По сути, Apple пошла на рискованный шаг: начала переводить ноутбуки и настольные компьютеры на процессоры, изначально использовавшиеся только в мобильных устройствах. Компания оказалась не первой, кто пришел к такому решению, но как минимум одной из первых, кому удалось сделать это удачно.
Будущее — за ARM? И при чем тут Apple
Несколько десятилетий назад еще не существовало так называемых языков программирования «высокого уровня» вроде Python, так что все команды приходилось писать машинным кодом, и каждая подобная команда обозначала какую-либо инструкцию для процессора. В общем, процесс трудоемкий, а главное, громоздкий — каждая программа получалась очень большой и трудночитаемой.
Такой подход назвали RISC (Reduced Instruction Set Computing), то есть компьютер с ограниченным набором команд. С совершенствованием технологий RISC начали развивать двумя способами — так появились архитектуры x86 и ARM. Первая рассчитана на «взрослые» и производительные компьютеры с процессорами от тех же Intel или AMD, которые умеют исполнять инструкции на базе технологии CISC (Complex Instruction Set Computing, то есть вычислительная машина со сложным набором команд), вторая — на относительно небольшие мобильные устройства с низким потреблением энергии, исполняющие усовершенствованные и более простые инструкции RISC.

Если еще немного упростить: говорим CISC — имеем в виду «классические» процессоры от компаний Intel или AMD, говорим RISC — подразумеваем варианты мобильных «систем на чипе», как у Apple или Samsung. Чтобы сделать процессор с x86-архитектурой, производителю необходимо самому придумать и нарисовать все транзисторы и соединения между ними. Это сложно и дорого. С ARM ситуация иная: любая компания может купить лицензию и сделать свой процессор с этой архитектурой, изменив компоновку и добавив другие модули.
Сложность в том, что программы, созданные для CISC (то есть x86, больших настольных процессоров), не способны прочитаться RISC-чипами (ARM, мобильные варианты) из-за разного набора инструкций. Поэтому до недавнего времени просто так запустить на компьютере программу, созданную для смартфона, не получалось.

Решение Apple перейти в компьютерах на ARM-чипы, схожие с применяющимися в iPhone и понимающие инструкции для RISC-процессоров, называют революционным благодаря тому, что компания отыскала программный способ заставить их читать софт, созданный для старых процессоров Intel под архитектуру x86. То есть компьютеры Apple последнего поколения с фирменными чипами M1 на ARM-архитектуре универсальны и берут лучшее от двух миров: производительность, энергоэффективность и возможность чтения программ, созданных для устройств обоих типов.
Пойдут ли по такому пути другие гиганты вроде Intel и AMD? Пока однозначно утверждать это нельзя. Все же их «классические» CPU показывают не меньшую, а то и бо́льшую пиковую производительность. Кроме того, их процессоры в массовом сегменте, как правило, предназначены для компьютеров под управлением операционной системы Windows, а схожую работу по оптимизации ОС таким образом, чтобы она могла читать программы для обеих архитектур, в Microsoft еще не провели.