Ранжирование вариантов ряда
расположение, упорядочивание вариантов в порядке возрастания (убывания).
- Telegram
- Вконтакте
- Одноклассники
Научные статьи на тему «Ранжирование вариантов ряда»
Метод ранжирования
Определение 1 Метод ранжирования – это метод, предполагающий расположение неких определенных предметов.
Статистические методы включают в себя наблюдение, расчет средних величин, исследование динамических рядов.
Эксперты могут прибегать к морфологическому методу, направленному на описание всех возможных вариантов.
Метод ранжирования Метод ранжирования является одним из методов экспертной оценки.
Если качество соизмеримо, но на текущий момент не может быть оценено по ряду причин.
Выбор весовых коэффициентов локальных критериев на основе принципа арифметической прогрессии
Для лица принимающего решение рассмотрен подход к расчету весовых коэффициентов локальных критериев, входящих в состав интегральных критериев, используемых для сравнительной оценки альтернативных вариантов, их ранжирования, и выбора наилучшего варианта. Подход основан на использовании принципа арифметической прогрессии при формировании ранжированного ряда весовых коэффициентов критериев, при этом рассматриваются варианты как полного, так и частичного порядка ранжирования критериев Все критерии разбиваются на группы, в случае полного ранжирования в состав каждой группы входит только один критерий, в случае частичного ранжирования в состав группы входят одинаковые по важности критерии. Предложен к использованию метод настраиваемой оценки предпочтения критериев, учитывающий взаимосвязь весовых коэффициентов групп критериев в виде элементов арифметической прогрессии. Приведены простые аналитические выражения для расчета весовых коэффициентов критериев, а также примеры их использования
Понятие порядковой шкалы в педагогике
объективно и однозначно соотнести объект с конкретной категорией; транзитивность, способствует осуществлению ранжирования.
В соответствии с тем, сколько вариантов ответов или баллов имеет шкала, устанавливается ее название и.
область применения, например, дихотомическая порядковая шкала имеет два варианта (результат): «высокий.
порядкового шкалирования В настоящее время в педагогике выделено несколько видов порядкового шкалирования: Ранжирование.
самый высокий балл, далее идут объекты с менее низкими оценками, занимающие соответствующие места в ряду
Сравнительная Характеристика вариантов выхода из венчурных инвестиций
Выход из инвестиций для венчурного инвестора является одним из показателей эффективности вложений его капитала. В работе проведена оценка различных вариантов выхода из венчурных инвестиций по ряду параметров. Результатом явилось ранжирование вариаций выходов по степени привлекательности для венчурных инвесторов и менеджмента компании.
Ранжирование выборки
Рассматривается ГС со случайным признаком Х , измеренным в порядковой шкале. Вариационный ряд выборки объёма n из этой ГС в идеальном случае имеет вид (например, в случае непрерывной случайной величины Х , когда вероятность совпадения двух значений в выборке равна 0). Но на практике в выборке могут быть одинаковые значения, тогда вариационный ряд имеет вид .
Ранжированные выборки — это приписывание каждому члену вариационного ряда его порядкового номера – ранга в вариационном ряду выборки.
Пример 1. Выборка 2, 5, 19, 8, 1, 4.
Вариационный ряд 1, 2 4, 5, 8, 19.
Ранги членов 1, 2, 3, 4, 5, 6.
Сложности в ранжировании возникают, когда среди элементов выборки встречаются совпадения, Тогда используют средние ранги , которые могут быть дробными.
Вариационный ряд 1 1 2 2 2 4 5 19,
Ранги членов 1,5 1,5 4 4 4 6 7 8,
так как 1,5 = (1 + 2) / 2 , 4 = (3 + 4 + 5) / 3.
При большом числе совпадающих значений в выборке следует либо повысить точность измерения признака Х , либо перейти к номинативной шкале.
Проверка гипотезы об однородности двух ГС по критерию Уилкоксона (по критерию суммы рангов)
Этот критерий эквивалентен критерию Манна-Уитни.
Постановка задачи – как в критерии Манна-Уитни.
Проверка гипотезы по критерию Уилкоксона
Предварительная обработка выборок.
Записывается вариационный ряд для выборок из ГС I и ГС II. Затем общий вариационный ряд ранжируется.
Статистика критерия Уилкоксона (статистика суммы рангов)
W(m, n) = сумма рангов элементов выборки из ГС I в общем вариационном ряду. Аналогично можно определить статистику W(n, m).
Существует связь статистик Уилкоксона и Манна-Уитни:
Поэтому применение критерия Уилкоксона даёт тот же результат, что и критерий Манна-Уитни.
3. По данному УЗ α при использовании правостороннего критерия по таблицам находят
Для левостороннего критерия
При двустороннем критерии по таблицам находят и по формуле (*) — .
По выборкам находят выборочное значение статистики критерия. Если попадает в допустимую область, то принимается. В противном случае отвергается.
Проверка гипотезы об однородности двух гс в случае связанных выборок
Постановка задачи. Пусть выборка из ГС I , — выборка из ГС II и объёмы выборок одинаковы равны n. Считается, что выборки связаны парами . (*)
Пары независимы друг от друга, но и в парах связаны некоторым образом.
Гипотеза об однородности : законы распределения ГС I и ГС II одинаковы.
Практически важная интерпретация задачи.
На объекты ГС I оказывается некоторое воздействие, которое может оказать влияние на распределение признака Х объектов ГС I. После воздействия получаем ГС II. Изменилось ли распределение признака Х после воздействия или оно осталось таким же, как было в ГС I ? Иными словами, произвело ли воздействие наблюдаемый эффект на объекты ГС I ?
Гипотеза — воздействие не имело эффекта.
Гипотеза — проявился эффект воздействия.
Для проверки из ГС I производят выбору n объектов, у которых измеряют величину Х до воздействия, получая выборку , и, после воздействия, получая выборку . Отсутствие или наличие эффекта воздействия, то есть гипотеза , проверяется по парам (*).
07.3. Примеры статистических моделей и гипотез, ранги и ранжирование
Ранги. Во многих случаях имеющиеся в нашем распоряжении числовые данные (например, значения элементов выборки) носят в той или иной мере условный характер. Например, эти данные могут быть тестовыми баллами, экспертными оценками, данными о вкусовых или политических предпочтениях опрошенных людей и т. д. Анализ таких данных требует особой осторожности, поскольку многие предпосылки классических статистических методов (например, предположения о каком-либо конкретном, скажем нормальном, законе распределения) для них не выполняются. Твердую основу для выводов здесь дают только соотношения между наблюдениями типа «больше-меньше», так как они не меняются при изменении шкалы измерений. Например, при анализе анкет с данными о симпатиях избирателей к политическим деятелям мы можем сказать, что политик, получивший больший балл в анкете, более симпатичен отвечавшему на вопросы человеку (респонденту), чем политик, получивший меньший балл. Но на сколько (или во сколько раз) он более симпатичен, сказать нельзя, так как для предпочтений нет объективной единицы измерения.
В подобных случаях (которые мы будем более подробно рассматривать в последующих главах), имеет смысл вообще отказаться от анализа конкретных значений данных, а исследовать только информацию об из взаимной упорядоченности. Для этого от исходных числовых данных осуществляют переход к их Рангам.
Определение. Рангом наблюдения называют тот номер, который получит это наблюдение в упорядоченной совокупности всех данных — после их упорядочения по определенному правилу (например, от меньших значений к большим или наоборот).
Чаще всего упорядочение чисел (набор которых составляют упомянутые выше данные) производят по величине — от меньших к большим. Именно такое упорядочение и связанное с ним ранжирование (присвоение рангов) мы будем иметь в виду в дальнейшем.
Пример. Пусть выборка состоит из чисел 6, 17, 14,5, 12. Тогда рангом числа 6 оказывается 2, рангом 17 будет 5 и т. д.
Определение. Процедура перехода от совокупности наблюдений к последовательности их рангов называется ранжированием. Результат ранжирования называется ранжировкой.
Статистические методы, в которых мы делаем выводы о данных на основании их рангов, называются ранговыми. Они получили широкое распространение, так как надежно работают при очень слабых предположениях об исходных данных (не требуя, например, чтобы эти данные имели какой-либо конкретный закон распределения). В последующих главах этой книги мы рассмотрим применение ранговых методов в наиболее распространенных практических задачах.
Средние ранги. Трудности в назначении рангов возникают, если среди элементов выборки встречаются совпадающие. (Так часто бывает, когда данные регистрируются с округлением.) В этом случае обыкновенно используют Средние ранги.
Средние ранги вводятся так. Предположим, что наблюдение  , имеет ту же величину, что и некоторые другие из общего числа П Наблюдений. (Эту совокупность одинаковых наблюдений из набора
 называют Связкой, количество таких одинаковых наблюдений в данной связке называют ее размером.) Средний ранг , в ранжировке наблюдений есть среднее арифметическое тех рангов, которые были бы назначены и всем остальным элементам связки, если бы одинаковые наблюдения оказались различны.
В качестве примера рассмотрим выборку 6, 17, 12, 6, 12. Ее ранжировка равна 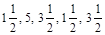 .
Покажем на примерах, как может проходить математическая формализация практических задач и как сформулированные на естественном языке вопросы превращаются в статистические гипотезы.
Тройной тест. Рассмотрим распространенный в психологии тройной тест (его другое название — тест дегустатора). Он состоит из серии одинаковых опытов, в каждом из которых испытуемому предъявляют одновременно три стимула. Два из них идентичны, а третий несколько отличается. Испытуемый, ориентируясь на свои ощущения, должен указать этот отличающийся стимул. Например, испытуемому могут быть предложены три стакана с жидкостью: два с чистой водой, а третий — со слабым раствором сахара, либо наоборот — два стакана подслащенных, а третий — с чистой водой. Задание для испытуемого — указать стакан, отличающийся от двух других.
Опыты стараются организовать так, чтобы они проходили в одинаковых условиях и чтобы в каждом из них испытуемый мог полагаться только на свои ощущения. В результате подобного однократного эксперимента можно получить как правильный, так и неправильный ответ.
При слабой концентрации раствора, когда его трудно отличить от воды, из одного ответа нельзя сделать определенного заключения о способности испытуемого чувствовать данную концентрацию. Испытуемый может случайно ошибиться, даже если в целом он способен отличать данную концентрацию сахара от чистой воды. С другой стороны, правильный ответ не исключает того, что испытуемый его просто угадал, не отличая раствора от воды.
Эти свойства эксперимента мы можем перечислить в виде следующих допущений:
• в каждом испытании ответ испытуемого случаен;
• существует вероятность правильного ответа, которая неизменна во все время испытаний;
• результаты отдельных испытаний статистически независимы.
Коротко это выражается так: статистической моделью эксперимента служит схема Бернулли.
Сформулировав математическую модель явления, перейдем к выдвижению статистических гипотез. Интересующая нас способность испытуемого характеризуется вероятностью правильного ответа, которую мы обозначим Р. В этом опыте она нам неизвестна. Естественно, эта вероятность зависит от степени концентрации сахара. Если концентрация очень мала и не воспринимается, то у испытуемого нет оснований для выбора. Он «наудачу» будет указывать один из трех стаканов. В этих условиях вероятность правильного ответа  .
Предположим, что экспериментатора интересует, начиная с каких концентраций испытуемый отличает раствор от воды. Тогда для данной концентрации экспериментатор может выдвинуть предположение, что испытуемый ее ощутить не в состоянии. В изложенной модели это предположение превращается в статистическую гипотезу о том, что . Примем следующую форму записи статистической гипотезы:  . Если же экспериментатор предполагает, что испытуемый может ощутить наличие сахара, то соответствующая статистическая гипотеза состоит в том, что
 , т. е.
 . Возможна и гипотеза о том, что
 , она соответствует тому, что испытуемый способен отличить раствор от воды, но принимает одно за другое.
Экспериментатор может выдвигать и другие гипотезы о способности испытуемого к различению концентраций. Например, возможна такая гипотеза: испытуемый способен ощутить присутствие сахара, ошибаясь один раз из десяти. В этом случае вероятность правильного ответа равна 0.9 и гипотеза примет вид: Н : р = 0.9.
Заметим, что с чисто математической точки зрения гипотеза вида проще, чем или . Действительно, при мы имеем дело с одним (полностью заданным) биномиальным распределением, а в других случаях перед нами семейство распределений. Ясно, что с одним распределением иметь дело проще.
Сейчас мы не будем рассматривать процесс проверки этих гипотез (он описан в п. 4), а вместо этого приведем еще один пример перевода естественнонаучной задачи на статистический язык, т. е. построения статистической модели явления и выдвижения гипотезы для проверки.
Парные наблюдения. На практике часто бывает необходимо сравнить два способа действий по их результатам. Речь может идти о сравнении двух методик обучения, эффективности двух лекарств, производительности труда при двух технологиях и т. д. В качестве конкретного примера рассмотрим эксперимент, в котором выясняется, на какой из сигналов человек реагирует быстрее: на свет или на звук.
Эксперимент был организован следующим образом. Каждому из семнадцати испытуемых в случайном порядке поочередно подавались два сигнала: световой и звуковой. Интенсивность сигналов была неизменна в течение всего эксперимента. Увидев или услышав сигнал, испытуемый должен был нажать на кнопку. Время между сигналом и реакцией испытуемого регистрировал прибор. Результаты эксперимента приведены в табл. 1.
Время реакции на свет и на звук, в миллисекундах
I — номер испытуемого, I = 1. 17; Xi — время его реакции на звук, YI — время его реакции на свет.
Вместо поставленного выше вопроса о том, на какой из сигналов человек отвечает быстрее, выдвинем другой: можно ли считать, что время реакции человека на свет и на звук одинаковы? Логически эти вопросы тесно связаны: если мы отвечаем отрицательно на второй из них, мы тем самым признаем, что различия есть. После этого уже не трудно понять, когда время реакции меньше. Если же на второй вопрос мы отвечаем положительно, то первый после этого просто снимается. С математической же точки зрения второй вопрос проще, как мы увидим из дальнейшего обсуждения.
Итак, время реакции на звук, X, и время реакции на свет, Y, различно у разных людей, несмотря на то, что во время опыта они находились в одинаковых условиях. Ясно, что наблюдаемый разброс во времени реакции не связан с изучаемым явлением (различием двух действий). По-видимому, этот разброс можно объяснить различиями между испытуемыми и/или нестабильностью времени отклика на сигнал у каждого испытуемого. Как бы то ни было, эти колебания не имеют отношения к той закономерности, что нас интересует. Поэтому мы объявляем их случайными. Так сделан первый шаг к статистической модели: переменные Xi и Yi признаны реализациями случайных величин, скажем Xi и Yi. Поскольку каждый испытуемый решал свои задачи самостоятельно, не взаимодействуя с другими испытуемыми и не испытывая с их стороны влияния, мы будем считать случайные величины X1, Y1. Х17, Y17 Независимыми (в теоретико-вероятностном смысле).
Выбор статистической модели. Дальнейшее уточнение статистической модели в подобных задачах может идти различными путями, в зависимости от природы эксперимента и наших знаний о ней. Один путь связан с предположением о том, что случайные величины XI и Yi имеют некоторые конкретные законы распределения. Например, мы можем предположить, что Xi и Yi — независимы и имеют нормальные распределения с одной и той же дисперсией (обозначим ее  ). Тогда, если ввести для средних значений обозначения:
 где I = 1. , 17, то можно сформулировать наши допущения так: случайные величины Xi, Yi подчиняются нормальным распределениям
 Соответственно, где параметры
 нам неизвестны. При этих обозначениях выдвинутый вопрос о равном времени реакции на свет и на звук может быть сформулирован как статистическая гипотеза:
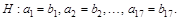
Если экспериментатор уверен, что группа испытуемых достаточно однородна, он может дополнительно предположить, что  и
 . Если обозначить общие значения параметров через A и B соответственно, то статистическую модель в этом случае можно сформулировать так: случайные величины
 независимы и распределены по закону
 ; случайные величины
 тоже независимы, не зависят от и распределены по закону
 . Параметры A, B и неизвестны. Тогда гипотезу о равном времени реакции можно записать следующим образом:

Ясно, что задача с меньшим числом неопределенных параметров, как во второй постановке, в принципе должна давать более точные ответы. При проверке гипотез это означает, что мы сможем принять или отвергнуть проверяемую гипотезу с большей степенью уверенности. Но следует помнить, что уменьшение количества параметров в модели является следствием принятия дополнительных предположений об имеющихся данных. Так, в приведенном выше примере мы предположили, что  и
 , что и дало нам возможность уменьшить количество параметров в модели с 35 до 3. Но если сделанные дополнительные предположения являются неправомерными, то использование полученной математической модели может привести к неверному заключению. Например, при обработке наших данных по однородной схеме можно получить неверный ответ, если фактически эти данные однородными не являются.
Итак, при построении статистической модели постоянно приходится вводить упрощающие математические предположения и одновременно оценивать, насколько они приемлемы с содержательной точки зрения. И часто надо быть готовым к тому, чтобы отказаться от недопустимых предположений или заменить их чем-то другим.
Другой путь построения статистической модели — так называемый Непараметрический. Здесь мы не делаем предположений о том, что наблюдаемые случайные переменные имеют какой-либо параметрический закон распределения. В этом случае мы делаем меньше математических допущений, а значит, здесь меньше опасности принять неоправданное предположение. Зато при этом мы используем не всю информацию об имеющихся данных, а только ту ее часть, которая не зависит от конкретного вида распределения исходных данных. Например, при проверке гипотезы о равном времени реакции на свет и звук мы должны будем использовать не сами значения времен реакций Xi и Yi, а их Ранги В объединенной выборке Xi и Yi. По сравнению с параметрическим методом (если предположения о параметрическом характере случайных событий справедливы), мы получим при этом несколько менее точные выводы, но зато непараметрический метод имеет гораздо более широкую область применимости.
Итак, при построении статистической модели приходится делать ряд предположений. Большую часть этих предположений мы не проверяем (и часто даже и не можем проверить). Некоторые предположения мы Выбираем для проверки их совместимости со статистическим материалом и называем такие предположения статистическими гипотезами. НиЖе Мы расскажем, как осуществляется проверка статистических гипотез.
Что такое ранжирование выборки и зачем оно нужно
Ранжирование выборки — это процесс упорядочивания объектов в соответствии с определенным критерием. Оно используется в различных областях, включая информационный поиск, машинное обучение, экономику и маркетинг.
В информационном поиске, например, ранжирование выборки используется для упорядочивания результатов поиска в соответствии с релевантностью запроса. В машинном обучении и экономике, ранжирование выборки используется для классификации и сортировки данных. В маркетинге, ранжирование выборки может использоваться для определения наиболее важных показателей успеха по определенной метрике.
Зачем нужно ранжирование выборки? Прежде всего, это помогает упорядочить данные и выделить наиболее значимые объекты. Также ранжирование позволяет значительно ускорить процессы анализа данных, что особенно важно в больших выборках.
Ранжирование выборки — это очень важный инструмент для любой области, где требуется обработка больших объемов данных. Этот метод позволяет не только упорядочить информацию, но и выделить наиболее важные объекты для дальнейшего анализа и принятия решений.
Ранжирование выборки: что это?
Ранжирование выборки – это процесс упорядочивания набора данных по некоторым критериям с целью быстрого и удобного доступа к определенным элементам выборки. Кроме того, ранжирование позволяет выявлять закономерности и тенденции в выборке, а также выделять особенности и паттерны, которые сложно заметить при обычном просмотре исходных данных.
От результата ранжирования зависит эффективность последующего использования данных. Например, в медицинской статистике ранжирование позволяет вычислить наиболее распространенные заболевания, а в банковском секторе – только наиболее выгодные кредитные продукты. В общем, ранжирование помогает находить наиболее значимые данные и использовать их в дальнейшей работе.
Существует множество различных методов ранжирования данных: от простейших, основанных на одном критерии, до более сложных, которые учитывают несколько критериев одновременно. Одним из наиболее популярных методов является ранжирование данных с помощью ранговой статистики, при котором каждому элементу выборки присваивается ранг в зависимости от его значения по определенному параметру.
Цель и принцип работы ранжирования выборки
Ранжирование выборки – это процесс упорядочивания элементов выборки на основе их признаков или параметров. Целью ранжирования является выявление наиболее значимых элементов выборки.
Основной принцип работы ранжирования заключается в установлении признаков, на основании которых будет определяться ранг элементов выборки. Эти признаки могут быть различными в зависимости от цели ранжирования – по убыванию цены, по возрастанию веса, по рейтингу и т.д.
Одним из наиболее распространенных методов ранжирования выборки является метод ранговой корреляции Спирмена. Он предполагает установление корреляции между рангом элемента и его признаком. Чем выше ранг, тем более значимым считается элемент выборки.
Ранжирование выборки широко применяется на практике для анализа данных, поиска наиболее эффективных решений или выбора наиболее приоритетных задач. Применение ранжирования повышает эффективность анализа данных и увеличивает точность принимаемых решений.
Примеры применения ранжирования выборки
1. Маркетинговые исследования: для проведения маркетинговых исследований очень важно знать, какую часть аудитории представляют определенные категории потребителей или какие факторы влияют на ценности и поведение покупателей. Разделение выборки на группы по определенным критериям позволяет проанализировать результаты и выявить закономерности, которые могут помочь оптимизировать маркетинговую стратегию.
2. Исследования в области медицины: в клинических испытаниях применяется ранжирование выборки, чтобы выявить эффективность лекарственных препаратов или новых технологий. Для этого пациенты разделяются на группы, которые получают разные лечения, и затем результаты сравниваются, чтобы определить, какое лечение является самым эффективным.
3. Оценка производительности: в рамках бизнес-анализа ранжирование выборки может быть использовано для оценки производительности сотрудников или отделов. Проведение рейтинга позволяет найти лучших и худших исполнителей, определить их сильные и слабые стороны, а также планировать развитие и обучение персонала.
4. Определение приоритетов: в различных областях, например, в проектном менеджменте, ранжирование выборки может помочь определить приоритеты задач и планировать их выполнение. При этом возможно определение наивыгоднейшей последовательности задач, а также оценка времени и затрат на выполнение каждой из них.
5. Системы оценки: системы оценки используются в образовании, а также в различных сферах, где требуется оценить качество или эффективность чего-либо. Ранжирование выборки помогает определить наилучшую и наихудшую оценки, а также выявить тенденции и закономерности.
6. Определение приоритетов в поисковых запросах: ранжирование выборки также используется в интернет-маркетинге при оптимизации сайта под поисковые запросы. В данном случае слова или фразы разбиваются на группы по степени конкуренции и числу запросов, а затем формируются стратегии продвижения.
Все эти примеры показывают, как важно ранжирование выборки при проведении исследований и определении наилучших стратегий в разных сферах. Качество и точность результатов зависит от тщательного разделения выборки на группы и анализа полученных данных.
Алгоритмы ранжирования выборки
Ранжирование выборки — это процедура упорядочивания множества объектов по некоторому критерию. Алгоритмы ранжирования позволяют обработать большие объемы данных и определить релевантность объектов в выборке.
Самым распространенным алгоритмом ранжирования является метод TF-IDF (Term Frequency-Inverse Document Frequency), который используется в поисковых системах. Он основан на представлении документов в виде векторов, в которых каждый элемент соответствует частоте употребления термина в документе. Чем чаще термины встречаются в документе, тем большую значимость они имеют.
Другой алгоритм ранжирования — PageRank, который используется в поисковой системе Google. Он определяет значимость веб-страницы по количеству ссылок на нее. Чем больше ссылок на страницу, тем выше ее релевантность и ранг.
Еще один алгоритм ранжирования — AdaRank, который используется для ранжирования результатов многоклассовой классификации. Он основан на оценке важности признаков в классификации. Чем больше вес признака, тем большее значение он имеет для классификации и ранжирования.
В зависимости от целей и задач выбираются соответствующие алгоритмы ранжирования. Наиболее эффективные алгоритмы позволяют сократить время и убрать ненужные данные, повысить качество и удобство работы с выборкой, а также получить точные результаты.
Достоинства и недостатки ранжирования выборки
Достоинства:
- Позволяет удобно определить наиболее значимые единицы выборки. Ранжирование выборки позволяет определить «лидеров» выборки, которые имеют наибольшее значение для конкретной задачи. Таким образом, можно определить наиболее перспективные направления развития, важные критерии оценки и т.д.
- Помогает выделить выбросы и аномалии. Если в выборке есть аномальные значения (например, выбросы), то они будут видны при ранжировании. Это позволяет выделить потенциально важные особенности выборки и скорректировать выводы.
Недостатки:
- Не учитывает междуэлементные отношения. При ранжировании элементы выборки определяются только по их значимости относительно конкретной задачи, но не учитываются взаимоотношения между элементами.
- Часто используется без объективного критерия. Ранжирование выборки может быть произведено на основе субъективного мнения или предпочтений и может не отражать реальное положение дел.
- Может быть некорректным в некоторых случаях. В зависимости от выбора метода ранжирования и выборки элементов, результаты могут быть неточными или искаженными в некоторых случаях.
Современные тенденции в ранжировании выборки
Выборка данных часто является ключевым моментом в работе аналитика или исследователя. Ранжирование выборки позволяет организовать данные в определенном порядке и помочь важные данные выделиться. Современные методы ранжирования опираются на различные алгоритмы, учитывают контекст и выполняют задачи автоматически, с помощью машинного обучения.
Одним из наиболее популярных методов является PageRank, который используется в Google для организации ранжирования страниц в поисковой выдаче. Этот метод основан на оценке значимости страницы с учетом ее ссылочной массы. Граф, состоящий из страницы и связей между ними, подвергается анализу и ранжированию.
Другой важный метод — машинное обучение, которое применяется в многих областях. Алгоритмы машинного обучения позволяют обрабатывать большие объемы данных и строить полезные модели. В задаче ранжирования, эти алгоритмы могут быть использованы для построения персонализированных рекомендаций и предсказаний, основанных на предыдущем поведении пользователя.
Но не только машинное обучение играет важную роль в организации ранжирования выборки. Условная замена, которая заключается в использовании данных, полученных на основе знаний и предпочтений определенных пользователей, тоже играет свою роль. Например, если пользователь предпочитает определенный тип продуктов или контента, условная замена будет учитывать это при формировании рекомендаций и ранжировании выборки.
Таким образом, современные тенденции в ранжировании выборки учитывают уникальные потребности и предпочтения пользователей, используют разнообразные алгоритмы машинного обучения и стараются обеспечить максимальную релевантность и точность рекомендаций.
Анализ результатов работы ранжирования выборки
Ранжирование выборки — это процесс упорядочивания элементов выборки по заданному критерию. Одним из наиболее часто используемых критериев является ранг элемента в выборке. После проведения ранжирования выборки можно провести анализ результатов работы этого процесса.
В первую очередь, следует оценить достоверность результатов. Для этого необходимо провести статистический анализ и сравнить полученные результаты с ожидаемым распределением. Если результаты соответствуют ожиданиям, можно считать, что ранжирование было проведено правильно и дало адекватные результаты.
Одним из основных преимуществ ранжирования является возможность проведения сравнительного анализа. Сравнивая элементы выборки, упорядоченные по заданному критерию, можно выявить закономерности и тренды, которые могут быть полезны для принятия решений.
Также результаты ранжирования могут быть представлены в виде графиков или таблиц. Это позволит визуализировать полученные данные и лучше понять распределение элементов выборки.
Однако, необходимо помнить, что ранжирование выборки может быть субъективным и зависеть от выбранного критерия. Поэтому весьма важно тщательно выбрать критерий ранжирования и продумать его корректность для решаемой задачи. И только после этого проводить анализ результатов ранжирования.
Вопрос-ответ
Что такое ранжирование выборки и зачем оно нужно?
Ранжирование выборки — это процесс упорядочения элементов выборки в соответствии с определенными критериями. Оно нужно для того, чтобы лучше понимать закономерности и особенности данных, а также для удобства работы с ними. Ранжирование помогает выделить наиболее важные элементы выборки и сделать правильные выводы из данных.
Какие критерии можно использовать при ранжировании выборки?
Критерии ранжирования выборки могут быть различными. Например, можно использовать критерии числовой характеристики, такие как среднее арифметическое или медиана. Также можно использовать критерии ранговой характеристики, такие как порядковый номер элемента в выборке или ранговый коэффициент корреляции.
Каким образом проводится ранжирование выборки?
Ранжирование выборки можно проводить различными способами, в зависимости от выбранных критериев. Например, простой способ ранжирования — это присвоение каждому элементу порядкового номера в выборке по возрастанию или убыванию. Другой способ — это использование эквидистантного ранжирования, при котором значения элементов выборки делятся на определенное количество равных промежутков и каждому элементу присваивается ранг в зависимости от того, в какой промежуток он попал.
Какие преимущества может дать ранжирование выборки при анализе данных?
Ранжирование выборки может дать ряд преимуществ при анализе данных. Во-первых, оно помогает наглядно представить распределение данных и выявить скрытые закономерности. Во-вторых, ранжирование позволяет упростить анализ данных, так как по результатам ранжирования можно выделить наиболее важные элементы выборки. Кроме того, ранжирование может помочь выявить выбросы и исключить их из анализа.
Какое значение может иметь ранжирование выборки в машинном обучении?
Ранжирование выборки имеет большое значение в машинном обучении. Оно позволяет выделить наиболее важные признаки выборки, что помогает улучшить качество модели. Кроме того, ранжирование может быть использовано для отбора признаков и упрощения модели. В дополнение к этому, ранжирование может помочь снизить ошибку прогнозирования и повысить точность предсказания результатов.